软件开发技术报告
USDA-GeoProdStudio V3.5.0 软件开发技术报告
版本: 3.5.0 发布日期: 2026.10.08
本报告介绍 USDA-GeoProdStudio V3.5.0 的技术目标、系统架构、算法方法、工程实现与验证依据,包含公式、参数和应用图谱附录。
| 所属项目: | 城市蓝绿空间生态涵养关键技术研究与示范 |
|---|---|
| 所属课题: | 城市蓝绿空间规划与生态系统服务功能优化技术 |
| 所属专项: | 多目标协同城市蓝绿空间规划体系建构 |
| 技术研发单位: | 西安建筑科技大学 |
| 主要研发人员: | 包瑞清 李政儒 |
摘要
本报告说明 USDA GeoProdStudio V3.5.0(发布日期:2026.10.08)的软件开发技术与研究应用边界。系统面向城市蓝绿空间规划与生态系统服务功能优化,贯通地图工具、分割采样、遥感专题产品、数据管理、空间结构关系分析和 GeoAI 项目助手,形成数据生产、结构—控制—响应分析及成果追溯的工作流程。软件可适配不同城市、土地覆盖类别和响应数据,类别含义与有效值必须依据本批次元数据确定。
V3.5.0 的空间分析以共同支持域、稳定来源身份和有效样本为基础,区分统计单元尺度与邻域作用尺度;采用经版本约束的成熟数值后端,落实折内预处理、嵌套空间验证和邻域重叠隔离。多目标分析区分方向校正后的目标关联、固定参考协调评价和精确 Pareto 非支配性;贝叶斯网络采用 pgmpy 完成结构评分、学习、BDeu 参数估计和精确概率推断。计算质量状态、字段语义、模型身份和文件签名随成果保存。
AI 层区分项目知识问答、参数辅助与 Harness Agent 本地分析。Agent 可依据问题读取当前结果及获准的原始数据,生成并执行 Python 等分析工具,返回小规模样本、统计结论及证据文件;多轮对话、执行轨迹、工作目录映射与交付清单可追溯。本文同步修订正文及公式、参数和输出附录,保留原有图表与历史界面示例。工程回归检查证明指定实现与测试用例的一致性,不替代城市案例重算、独立样本验证、生态机制验证或规划情景模拟。
关键词:USDA_GeoProd;城市蓝绿空间;土地覆盖;生态系统服务;统计单元与邻域作用双尺度分析;控制变量与多目标分析;贝叶斯网络
建设背景与技术目标
1.1 课题背景与软件建设依据
USDA_GeoProd 服务于国家重点研发计划项目“城市蓝绿空间生态涵养关键技术研究与示范”中的课题三“城市蓝绿空间规划与生态系统服务功能优化技术”。课题围绕多目标协同规划体系、生态系统服务评价与综合效能提升、高效益单元类型与营建模式、生态系统服务功能提升优化技术与应用四条任务线展开,研究对象覆盖城市—组团—社区等层级,并关注中心城区、高密度建成环境及核心—过渡—缓冲梯度中的蓝绿空间结构、功能、服务与综合效益。软件建设不是一般性 GIS 功能叠加,而是把课题所需的基础数据生产、空间结构表征、尺度效应识别、控制后关系、多服务协同权衡和概率机制分析转化为可执行、可复核的计算工具。
课题的分析逻辑可概括为“土地覆盖与规划环境数据—蓝绿空间结构—生态过程与环境响应—生态系统服务—综合效能—规划干预”。其中,土地覆盖决定蓝绿空间的位置、类型和面积,是结构特征与服务评价的共同空间底板;统计单元与邻域作用尺度决定结构和响应以何种支持域发生关联;人口、建筑、道路和城市强度等背景变量影响关系解释;不同服务目标之间可能同时存在协同与权衡。因此,软件必须同时解决数据可用性、空间一致性、尺度可解释性和多目标决策证据组织问题。
1.2 研究问题与数据瓶颈
中心城区地物类型密集、斑块尺度小、光谱混合强,绿地、水体、建筑、道路和裸地边界复杂。直接使用通用土地覆盖产品时,常出现建成区局部类型混淆、与课题关注对象不完全对应,以及分类时相与生态系统服务观测时相不匹配等情况。进一步开展结构—响应研究时,如果土地覆盖、服务响应和城市背景数据未在同一空间基准上组织,或者把统计单元变化与邻域作用范围变化混为同一尺度,所得高效益单元与优化范围将缺乏一致的空间含义。
| 课题问题 | 对研究的影响 | USDA_GeoProd 技术响应 |
|---|---|---|
| 建成区土地覆盖精度不足 | 小斑块和混合像元影响蓝绿空间面积、边缘、破碎化与连通性测度 | 15 m 全色融合、对象分割与交互采样、多域特征、传统/深度模型及融合评价 |
| 土地覆盖类型固定 | 通用类别无法直接表达课题所需的蓝绿空间或建成环境细分类 | 类别由样本属性字段与标签编码器动态建立,训练、预测、调色和融合沿用同一类别语义 |
| 时间点有限或不连续 | 结构与温度、蒸散发等响应难以按研究时相匹配 | 面向可获得 Landsat 场景重复生产,支持多景时序统计、模型复用及统一分类数据模式 |
| 尺度含义混杂 | 无法区分单元聚合效应与周边结构作用范围 | 统计单元尺度与邻域作用尺度并行建模,分别保持明确的响应支持域 |
| 背景条件与服务目标复杂 | 结构效应可能受城市强度混杂,多服务之间存在协同与权衡 | 控制后关联与匹配空间验证下的解释增量、多目标描述指标、精确 Pareto 非支配前沿及贝叶斯条件依赖分析 |
表 1-1 课题问题、分析影响与软件技术响应
1.3 软件定位与作用边界
软件定位为课题研究的数据生产底座、尺度机制分析引擎和规划优化证据接口。地图浏览与交互式操作界面用于承载数据选择、参数确认、空间复核及结果解释,核心价值在于其背后的数据模型、计算方法和成果追溯链。软件直接生产土地覆盖和地表温度,生成基于场景冷热端温度指数的实际蒸散发估算响应层,并可接收其他模型或调查形成的降雨调蓄、碳储存、空气质量、文化休闲、生境连通等响应栅格或表格;ETa 估算层主要用于场景内相对水热格局及蓝绿空间差异分析,绝对耗水量应用须另行校准验证。上述数据在统一结构—控制—响应框架中组织,所得尺度、净效应、协同权衡和概率关系用于支持高效益单元识别、营建模式归纳与优化方案比较。软件前序登记版本 USDA-GeoProdStudio V2.0.0 已取得计算机软件著作权登记,登记基础及著作权归属证明见附录 E。
“连续生产”在本报告中指针对可获得的有效观测场景,采用一致类别体系、特征定义、模型与质量控制重复生成可比产品;“优化支持”指输出可解释的空间证据、优先单元和多目标关系,而规划方案的最终形成仍与课题中的规划设计、情景构建和综合决策环节衔接。上述定义保证软件能力与课题任务对应,同时保持方法和成果口径清晰。
1.4 技术目标与成果类型
| 技术目标 | 方法落实 | 形成的成果与用途 |
|---|---|---|
| 建立可配置土地覆盖数据底板 | 分割采样、多域特征、自定义类别、多模型训练/融合和块式推理 | 分类 GeoTIFF、类别 schema、模型与评价文件;支撑蓝绿空间结构提取 |
| 统一多源服务评价空间基准 | 坐标参考系统(CRS)、分辨率、范围锚点、重采样和共同有效掩膜 | 对齐数据集、位置索引、schema 与 manifest;保证跨数据关系可比 |
| 识别高效益统计单元 | 统计单元尺度、格局特征、空间关系及尺度诊断 | 候选峰值、连续近峰平台、转折与有效性记录;用于单元比较和后续验证 |
| 识别邻域作用与优化范围 | 固定中心响应、奇数邻域窗口、空间模型和跨尺度比较 | 邻域关联候选范围和描述性空间模型;干预范围需另行验证 |
| 评价综合效能与多目标关系 | 控制后净效应、协同/权衡、耦合协调度(Coupling Coordination Degree,CCD)、Pareto 和贝叶斯网络 | 解释增量、固定参考协调指标、非支配成员、条件依赖边与概率;支撑候选方案比较 |
| 形成可追溯研究证据 | 阶段文件、参数落盘、随机种子、日志、QC 和多格式输出 | 可重放工作目录和可进入课题后续分析的标准成果 |
表 1-2 软件技术目标与课题成果支撑关系
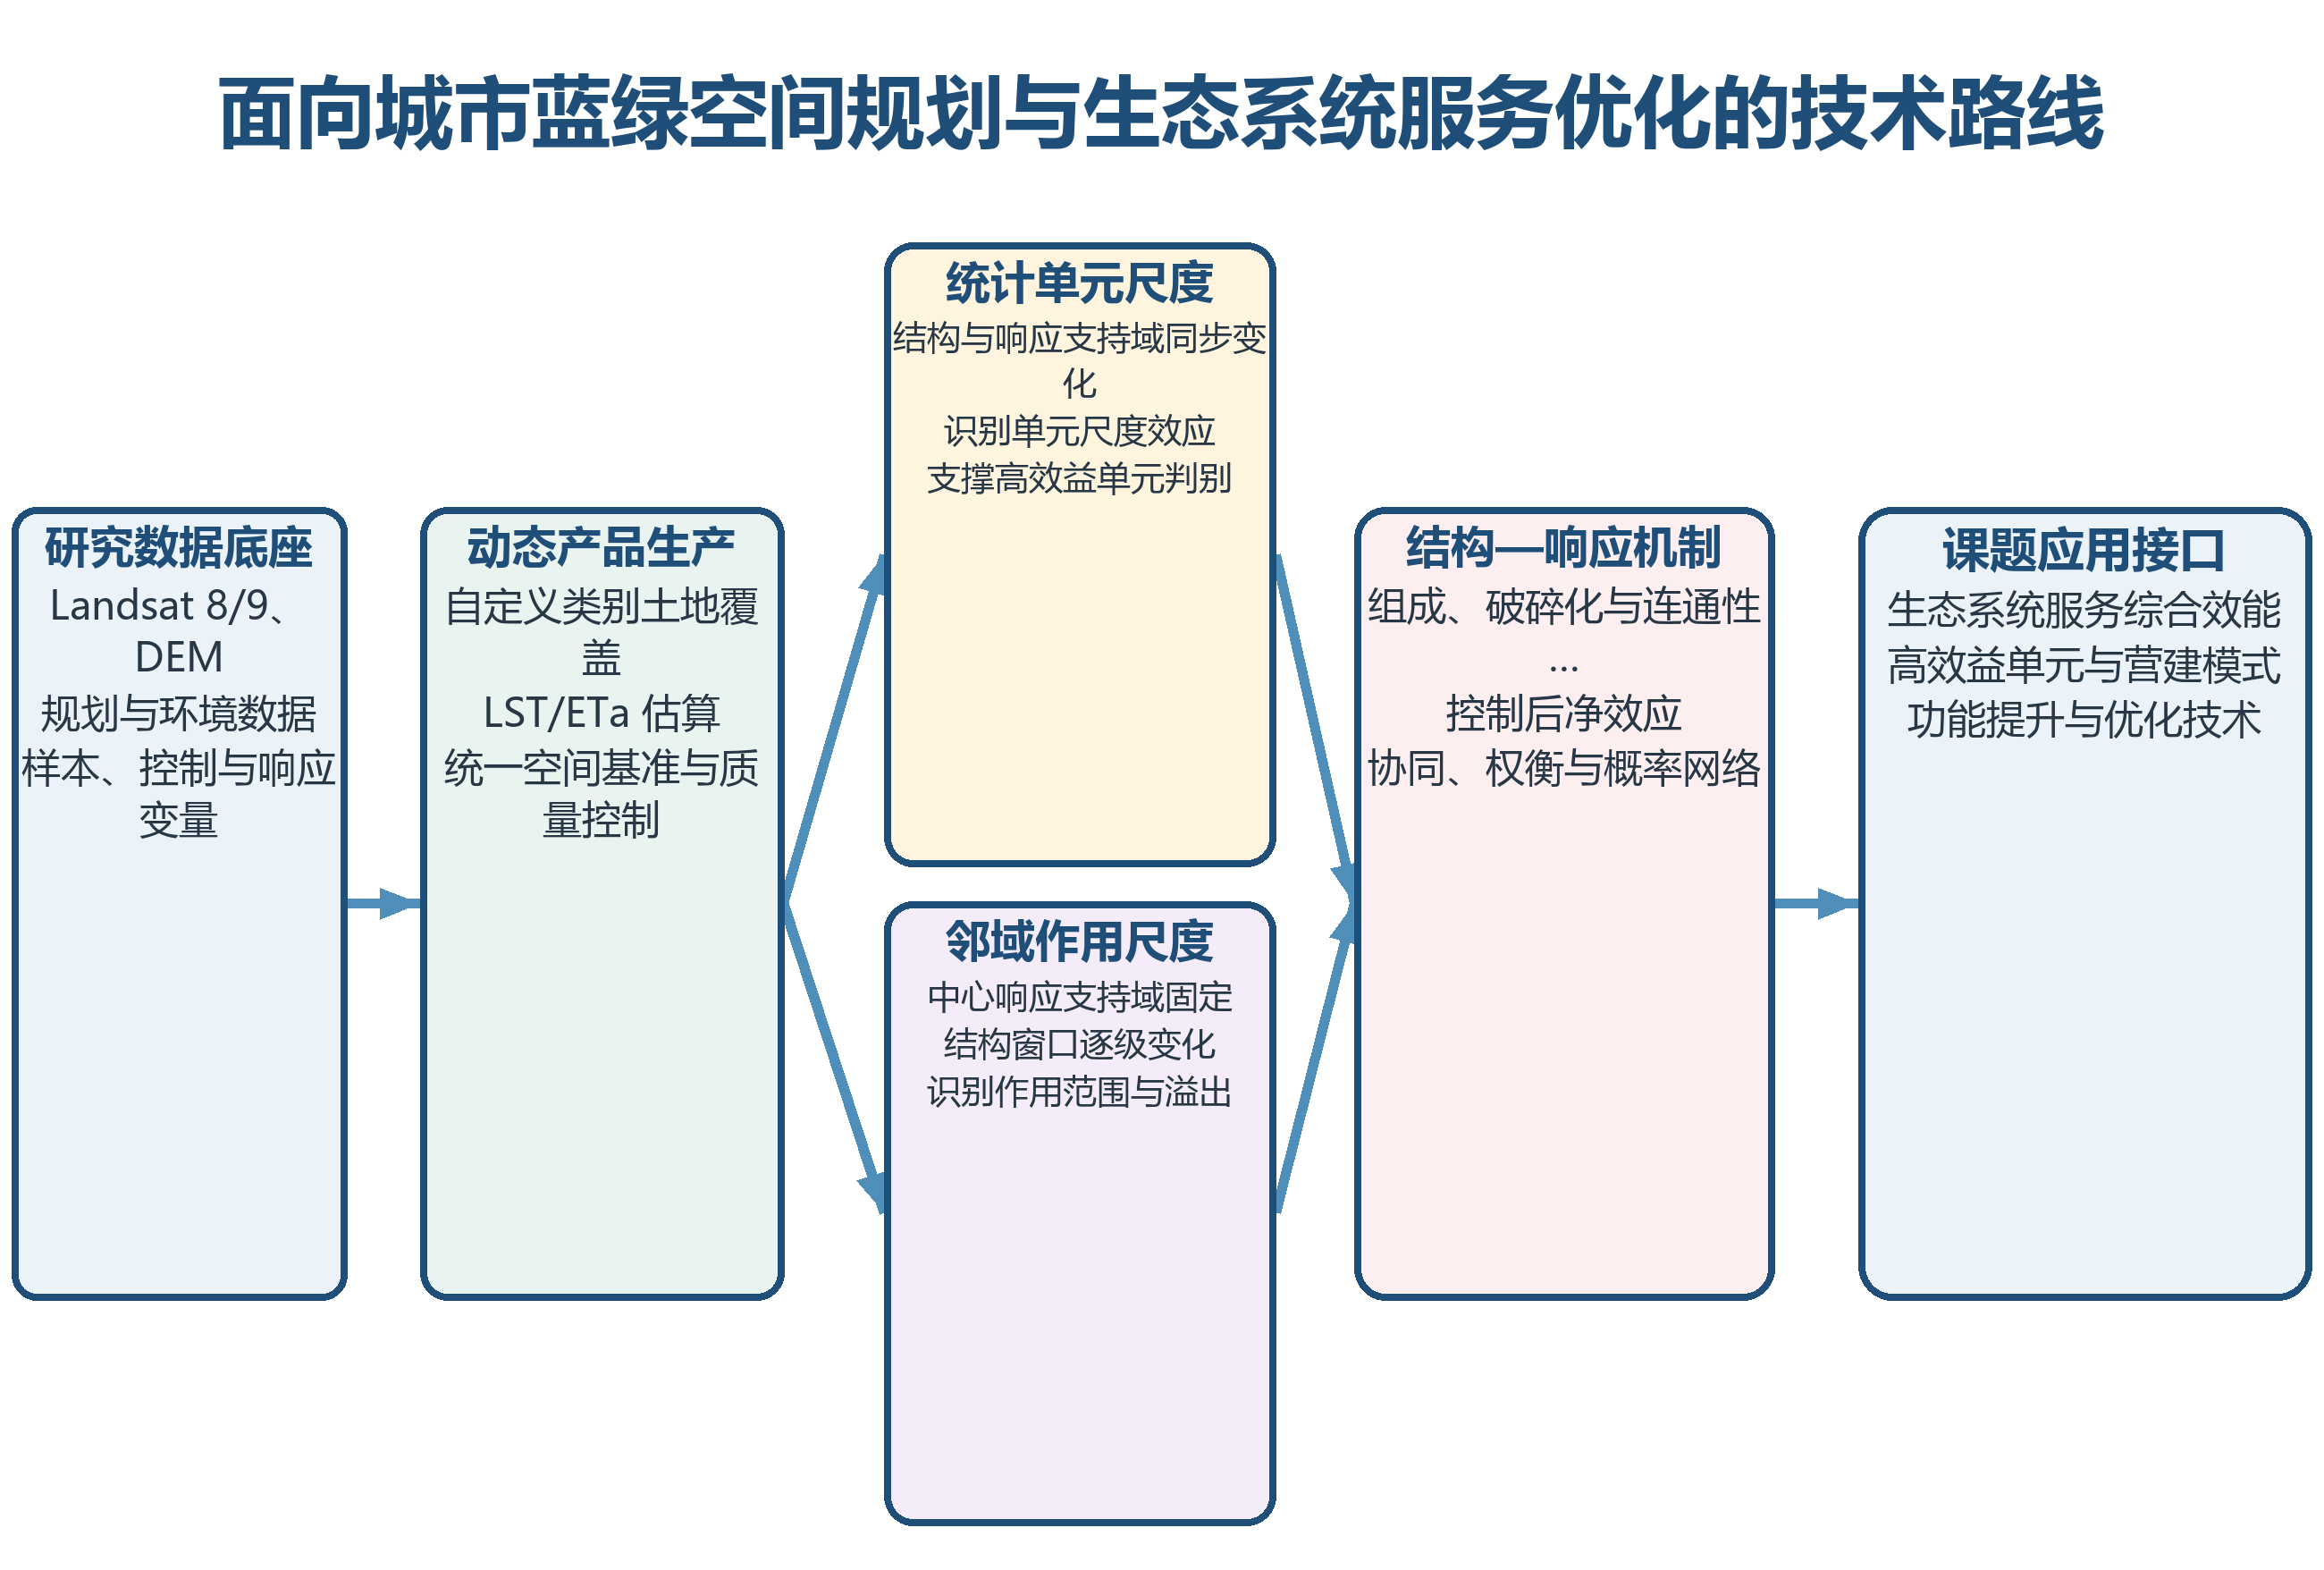
图 1-1 从动态土地覆盖数据底板到城市蓝绿空间规划优化证据的总体技术路线
1.5 总体成果闭环
软件成果按“数据产品—分析数据集—尺度与机制结果—空间化证据”四级组织。土地覆盖、LST 和 ETa 估算层形成可直接叠加的专题 GeoTIFF(地理标记图像文件格式);公共建模数据集把结构、控制和响应转化为具有共同位置索引与 schema 的分析对象;尺度曲线、控制后关系、多目标指标和贝叶斯网络形成方法结果;局部多波段 GeoTIFF、诊断表和概率推断把结果重新落到城市空间。四级成果通过输入路径、模型、参数、随机种子、空间位置索引(positions)、manifest 和 QC 标签相互关联。
| **与课题成果的衔接 **数据产品回答蓝绿空间“在哪里、是什么、何时可比”,双尺度分析回答“以多大单元评价、周边多大范围起作用”,控制/多目标和概率网络回答“哪些结构在控制背景后仍重要、多个服务如何协同或权衡”,空间化成果用于支撑高效益单元、营建模式与功能提升技术的归纳。 |
|---|
课题任务链与总体技术路线
2.1 子课题任务与软件支撑关系
课题四条任务线不是彼此独立的软件菜单,而是共享同一数据和机制证据链。多目标协同规划体系需要统一的数据底板和目标表达;综合效能评价需要多类服务响应及其空间公平、协同和权衡信息;高效益单元类型需要在可解释统计尺度上比较结构与效益;功能提升优化需要识别邻域结构的作用范围、控制背景条件并比较多目标结果。USDA_GeoProd 以模块化能力连接这四条任务线,并把每一步输出保存为下一环节可复用的数据对象。
| 课题任务 | 主要软件能力 | 形成的研究证据 |
|---|---|---|
| 多目标协同城市蓝绿空间规划体系建构 | 动态土地覆盖、统一空间基准、响应数据接入、控制变量与多目标分析 | 蓝绿空间现状底板、目标间协同/权衡及方案比较指标 |
| 生态系统服务评价与综合效能提升方法 | LST/ETa 估算层、外部服务响应接入、统计单元尺度、空间关系与多目标协调 | 服务空间格局、综合效能单元、尺度依赖和公平/协调分析接口 |
| 高效益单元类型与营建模式 | 组成—破碎化—连通性等等结构特征、统计单元尺度、控制后净效应、贝叶斯网络 | 高效益单元的结构组合、关键尺度、稳定关系与类型归纳依据 |
| 生态系统服务功能提升优化技术与应用 | 邻域作用尺度、局部空间结果、Pareto 共赢、条件概率推断与成果导出 | 作用半径、优化优先区、结构调整方向和多目标模式比较依据 |
表 2-1 课题任务—软件能力—研究用途对应关系
2.2 从结构到服务效益的分析链
软件采用“结构—过程/响应—服务—效益”的分层表达。土地覆盖及规划环境数据首先转化为蓝绿空间组成、配置、破碎化、连通性、边缘、形状和邻接等结构变量;地表温度、蒸散发及外部导入的径流、碳、空气质量、休闲和生境结果构成响应变量;人口、建筑、道路、开发强度及自然背景构成控制变量。统计单元尺度回答“何种单元大小最能稳定识别结构与综合效能关系”,邻域作用尺度回答“中心位置周边多大范围的结构与响应关联最强”。控制后净效应、多目标协调和概率网络进一步把相关关系组织为可比较的机制证据。
土地覆盖 L(t) → 空间结构 X(s,t) → 环境/服务响应 Y(s,t) → 综合效能 E(s,t) → 规划干预 Π
式中,L(t) 为时相 t 的土地覆盖数据,X(s,t) 为尺度 s 和时相 t 下的空间结构特征,Y(s,t) 为相应支持域上的环境或生态系统服务响应,E(s,t) 为综合效能,Π 为与课题规划设计环节衔接的干预方案;t 表示观测时相,s 表示统计单元尺度或邻域作用尺度,箭头表示数据加工、指标派生与证据传递关系。软件对 L、X、Y 和 E 的数据来源、支持域、有效位置和计算参数进行记录,使不同城市、梯度分区和规划层级能够在同一逻辑下组织,但不强制使用单一指标体系。
2.3 设计原则
• 课题目标牵引:数据生产和空间分析均指向生态系统服务综合效能、高效益单元和功能提升模式,不以界面功能数量作为建设目标。
• 分类体系可配置:土地覆盖类别由研究样本和属性字段定义,并在训练、预测、融合、调色(类别颜色映射和地图渲染配色)和后续结构分析中保持统一。
• 空间一致性优先:跨源计算先明确目标 CRS、像元大小、公共范围、网格锚点、重采样语义和 NoData(空值或无效数值) 传播。
• 尺度含义分离:统计单元尺度与邻域作用尺度采用不同的支持域构造和结果命名,防止尺度解释混淆。
• 结构特征优先解释:综合效能分析不仅比较面积比例,还系统表征破碎化、连通性、边缘、邻接和多尺度组织等等。
• 证据可复核:模型指标、尺度曲线、局部空间结果、参数清单、schema、manifest 和 QC 信息随成果保存。
2.4 端到端技术路线
技术路线从课题数据语义而不是软件页面出发。数据进入平台后,先建立资产信息、类别语义和显示图层;进入计算时执行空间对齐与共同有效域构建;土地覆盖链以“轻数据、强特征”为原则,通过自动化分割—采样、特征生产、模型训练、预测与融合形成研究时相底板,LST、ETa 估算层或外部服务数据形成响应层;随后在同一位置索引上构造结构、控制和响应特征,分别进入统计单元尺度和邻域作用尺度;控制变量、多目标和贝叶斯网络在双尺度结果基础上深化解释;最终将结果写回空间并导出为高效益单元识别、营建模式归纳和优化情景比较可直接使用的成果。
| 需求场景 | 核心模块 | 主要处理 | 代表输出 |
|---|---|---|---|
| 多源数据组织 | 地图工作台、DataLoader、数据管理器 | 加载、投影显示、元数据索引、检索与预览 | 图层注册表、SQLite 元数据、地图图层 |
| 训练样本构建 | 分割采样 | 特征、分割、分区、对象选择与保存 | segments.geojson(分割结果)、samples.geojson(采样结果) |
| 动态土地覆盖生产 | Landsat2LC | 自定义类别、多域/时序特征、RF/提升树/ResNet、融合 | 模型、评价、分类 GeoTIFF 与类别 schema |
| 环境与服务响应组织 | LST/ETa 估算处理器、公共数据集 | Level-2比例因子与偏移量换算、QA、端元计算及外部响应接入 | LST/ETa 估算层或其他服务响应及 QC 元数据 |
| 高效益单元与作用范围 | 双尺度空间结构分析 | 结构特征、关系、尺度诊断、局部回写 | 尺度曲线、诊断表、局部多波段 GeoTIFF |
| 综合效能/优化关系 | 控制/多目标、贝叶斯网络 | 净效应、协同权衡、Pareto、CPT 与稳定性 | 共赢单元、稳定边、后验结果、网络图 |
表 2-2 需求—模块—输出闭环
系统总体架构
3.1 分层架构
软件采用界面、任务编排、数值引擎、成果与 AI 辅助层分离的架构。PySide6 承载参数、地图与结果交互;业务层管理输入角色、阶段依赖、取消和复用;成熟 Python 后端执行确定性计算。GeoAI 知识问答检索项目知识和当前页面状态,Harness Agent 则通过 USDA MCP 桥接获取项目与数据上下文,在独立工作目录生成本地分析工具。用户触发的 AI 任务与正式批处理保留各自的参数、文件与执行记录。
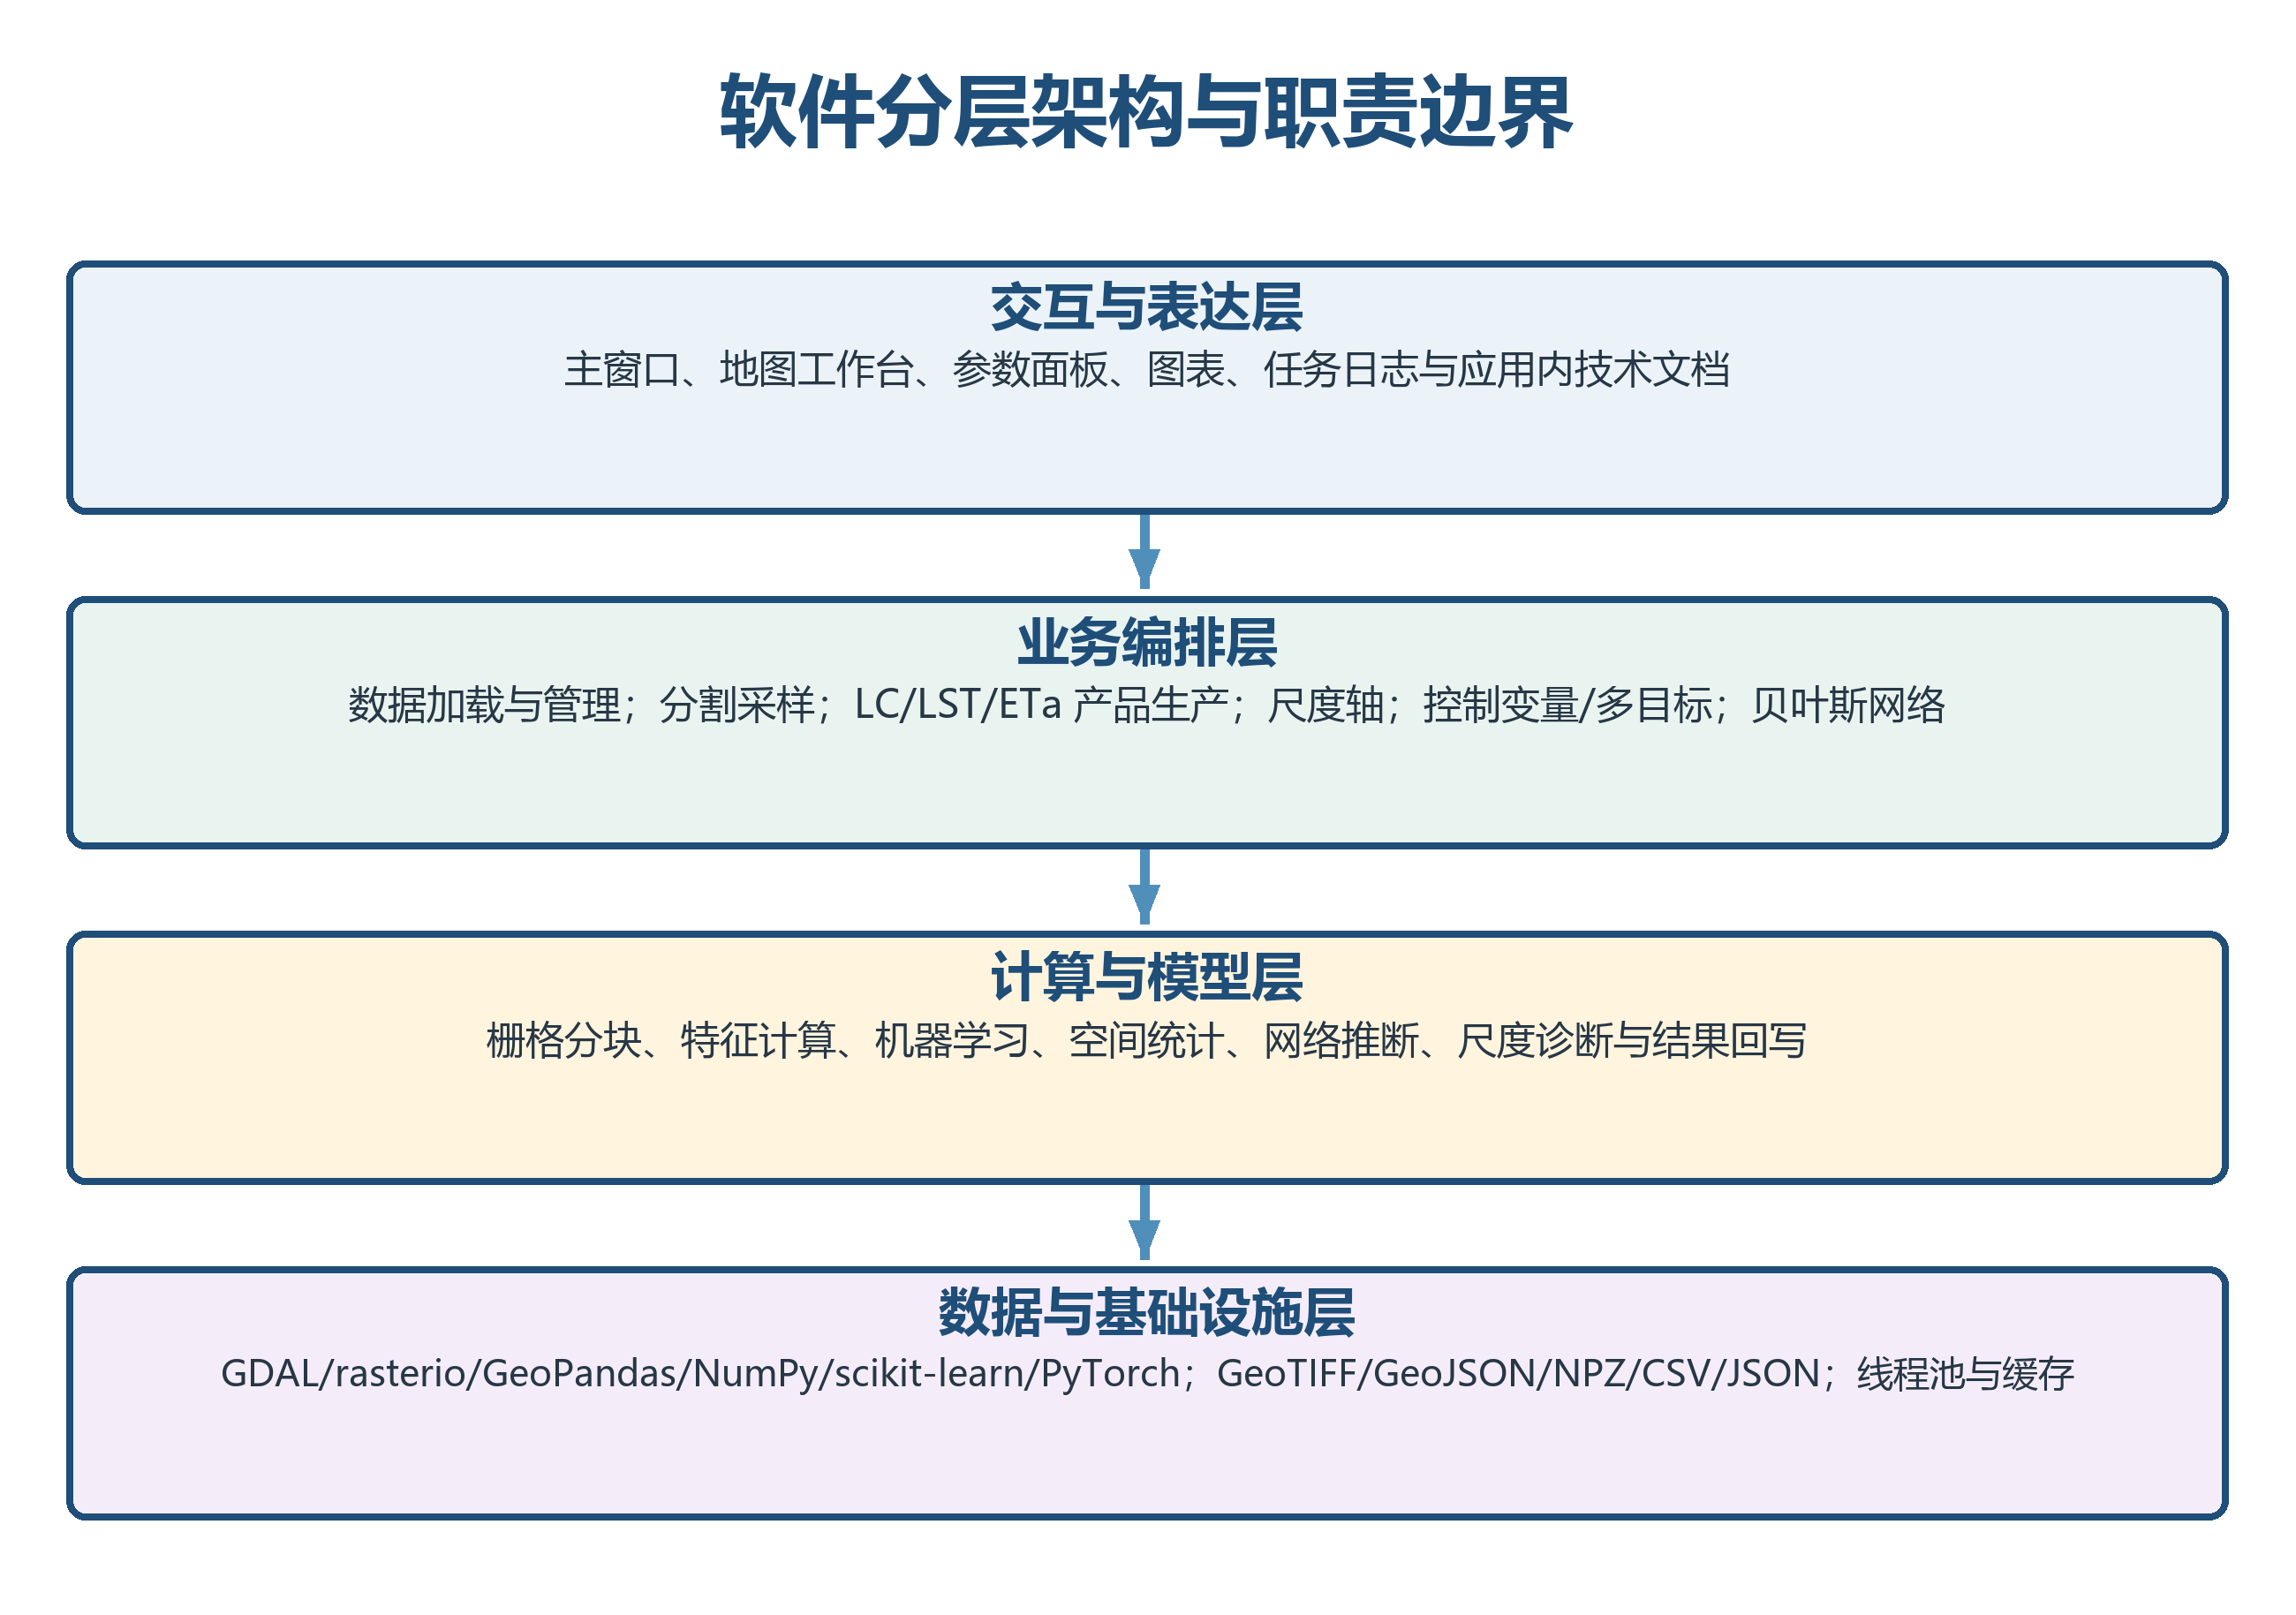
图 3-1 USDA_GeoProd 软件分层架构
3.2 主界面与模块装配
主窗口负责地图、数据管理、数据生产、空间结构分析和知识文档等功能页的装配。地图页维护蓝绿空间底图、环境响应和分析结果的图层注册与叠加复核;数据管理页以元数据索引支持跨城市、时相和专题检索;模型训练/数据生产页组织 LC、LST 和 ETa 估算流程;空间结构分析页加载公共数据集并派生统计单元、邻域作用、控制变量/多目标和贝叶斯网络任务;知识文档页把公式、变量角色、参数和读图规则与工具入口对应起来。
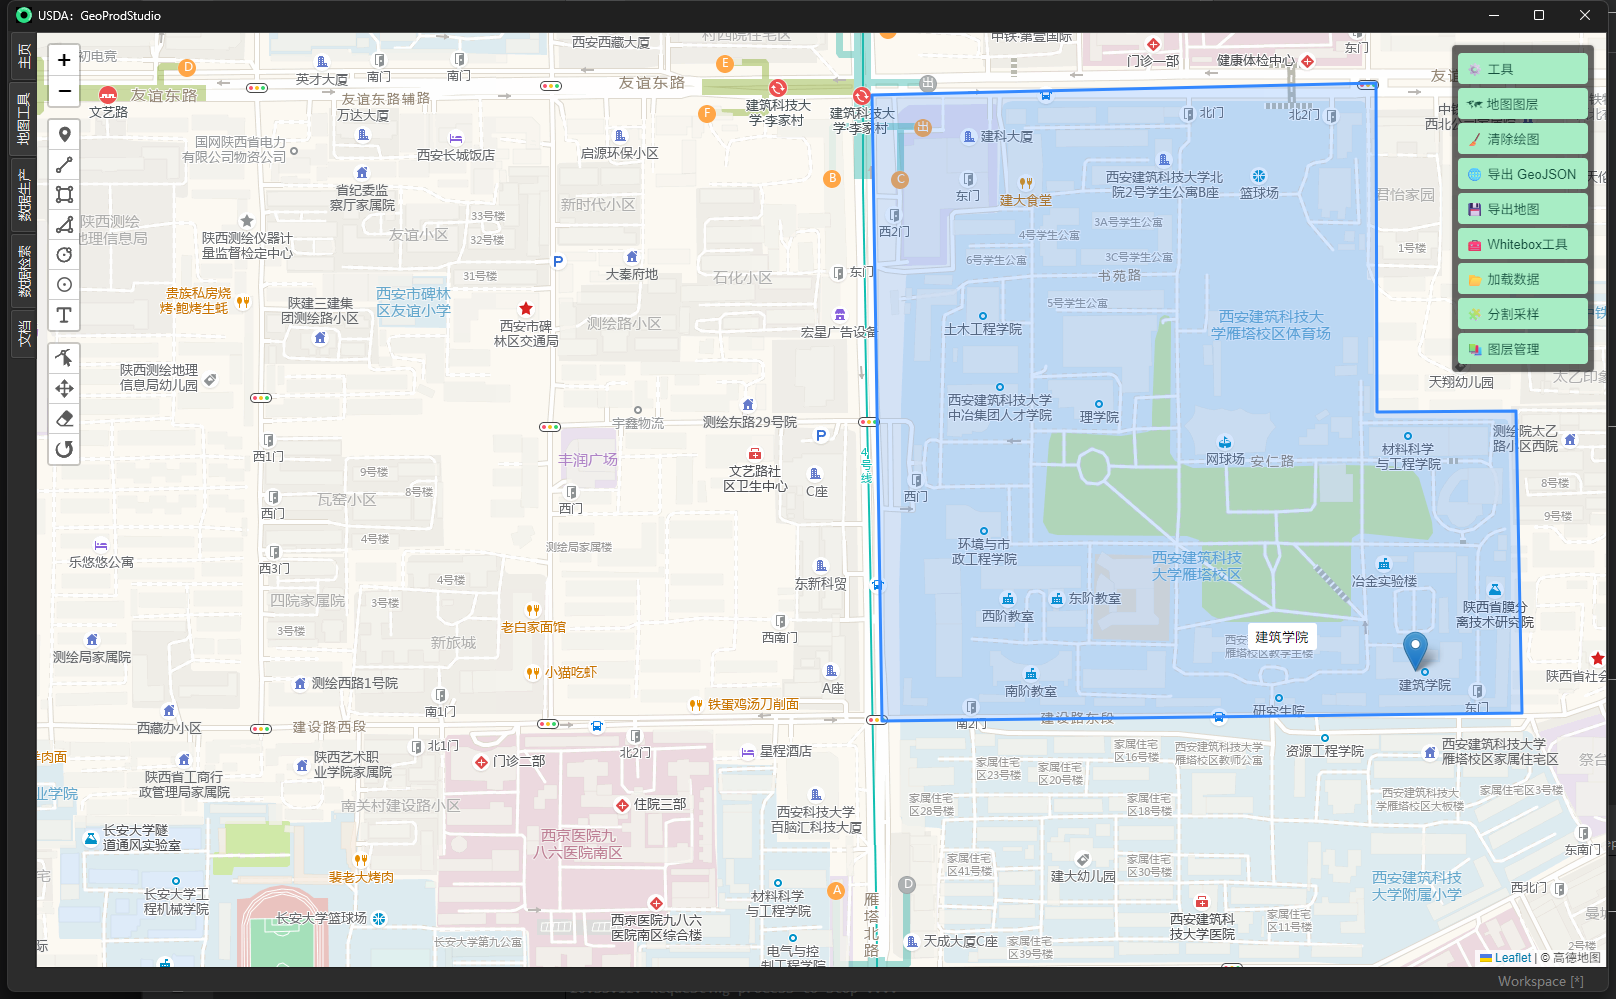
图 3-2 地图工作台作为数据加载、空间复核与成果表达入口
3.3 业务编排与计算引擎
业务编排按阶段组织任务并将耗时运算移出主界面线程。空间关系与多目标分析使用统一的验证协议和后端适配,贝叶斯模块延迟导入 pgmpy 并在后台发现来源及读取预览。参数、输入指纹、软件与后端版本共同决定复用签名;输入变化、协议变化或未完成的检查点不能作为匹配正式结果复用。
3.4 注册表驱动与扩展机制
注册表登记特征、方法、参数、兼容条件、开销及实现状态,界面根据登记内容展示和执行。V3.5.0 将成熟后端身份与结果质量状态写入成果;依赖缺失时明确报告,不以其他模型冒充。探索性 PCA/图结构代理和未实现的 Bootstrap、独立尺度一致性检验停用或标明未计算,注册入口不等于已有有效结果。OrthoPlan-AI 为开发中功能,本次发布隐藏该入口。
| 模块 | 代表实现 | 工程职责 |
|---|---|---|
| 交互与数据 | mainwindow.py;tab_map.py;tab_dm.py | 导航、图层回显、元数据索引与任务入口 |
| 样本与专题产品 | map/seg_sampling/*;modeltrain/* | 对象样本、土地覆盖、LST/ETa 估算生产与评价 |
| 结构与机制分析 | spatial_structure_analysis/* | 双尺度特征/关系/诊断、控制后效应、多目标与条件推断 |
表 3-1 关键模块与工程职责
数据体系与空间计算基础
4.1 数据角色与语义
统一空间基准以 CRS、分辨率、范围锚点、仿射变换和有效掩膜组织多源数据。分类源使用最近邻,连续源按配置重采样;先识别 NoData/有效值再应用波段 scale/offset。来源路径、波段及稳定身份、数据类型、单位、类别字典和改善方向保存到元数据,避免同名波段、类别 0 或缩放值被错误解释。
Yᵢ(s) = f[Xᵢ(s), Cᵢ(s) | s, G] + εᵢ
式中,i 为空间位置索引,s 为统计单元尺度或邻域作用尺度,Yᵢ(s) 为位置 i 在尺度 s 下的响应,Xᵢ(s) 为主结构特征向量,Cᵢ(s) 为控制变量向量,f(·) 为待估计的结构—响应关系函数;竖线“|”表示在给定尺度 s 和空间结构 G 的条件下建模,G 为空间邻接或空间权重结构,εᵢ 为模型未解释的误差项。该统一表达式用于组织尺度、控制变量和空间关系方法,而不预设具体的线性或因果形式。
| 数据角色 | 课题中的代表对象 | 软件处理语义 |
|---|---|---|
| 结构变量 X | 土地覆盖、蓝绿空间比例、斑块、连通网络、边缘和邻接 | 类别/连续源识别,按统计单元或邻域窗口构造结构特征 |
| 控制变量 C | 人口、建筑、道路、开发强度、地形和气候背景 | 在共同有效样本上标准化并用于残差控制、基线模型或网络节点 |
| 响应变量 Y | LST、ETa 估算值、雨洪、碳、空气质量、休闲、生境和综合效能 | 保持响应语义与期望方向,按分析轴聚合或固定中心支持域 |
| 空间基准 G | 城市边界、梯度分区、目标网格和邻接关系 | 统一 CRS、锚点、分辨率、公共范围、位置索引与空间权重 |
| 时间 t | 土地覆盖和服务响应的观测日期、季节或年份 | 记录数据时相与来源,按统一 schema 组织可比的重复生产成果 |
表 4-1 城市蓝绿空间研究的数据角色与软件处理语义
4.2 公共支持域与目标网格
跨源计算首先取得空间范围交集,并以指定锚点和目标像元建立共同网格。土地覆盖、蓝绿空间结构、城市背景和生态系统服务响应由此共享一致行列位置;只有结构、控制和响应均满足有效值条件的位置进入建模。类别型栅格采用最近邻以保留类别编码,连续型栅格采用双线性或按统计单元聚合;规划分区和样本矢量按目标 CRS 投影后再执行栅格化、叠置或样本提取。公共支持域不仅是技术预处理,也是保证“同一城市位置、同一统计支持域、同一服务响应”能够被解释的研究前提。
Ω* = ⋂ₖ Ωₖ; xⱼ = x₀ + (j + 1/2)r₀; yᵢ = y₀ − (i + 1/2)r₀
式中,Ωₖ 为第 k 个输入数据集的空间覆盖范围,Ω* 为所有输入覆盖范围的交集,k 遍历参与对齐的数据源,⋂ 表示集合求交;(x₀,y₀) 为目标网格左上角锚点,r₀ 为目标像元大小,i 和 j 分别为行、列索引,yᵢ 和 xⱼ 分别为第 i 行、第 j 列像元的中心坐标,1/2 像元偏移用于把坐标定位到像元中心。像元中心坐标及行列索引同步写入位置表,作为后续空间回写的连接键。
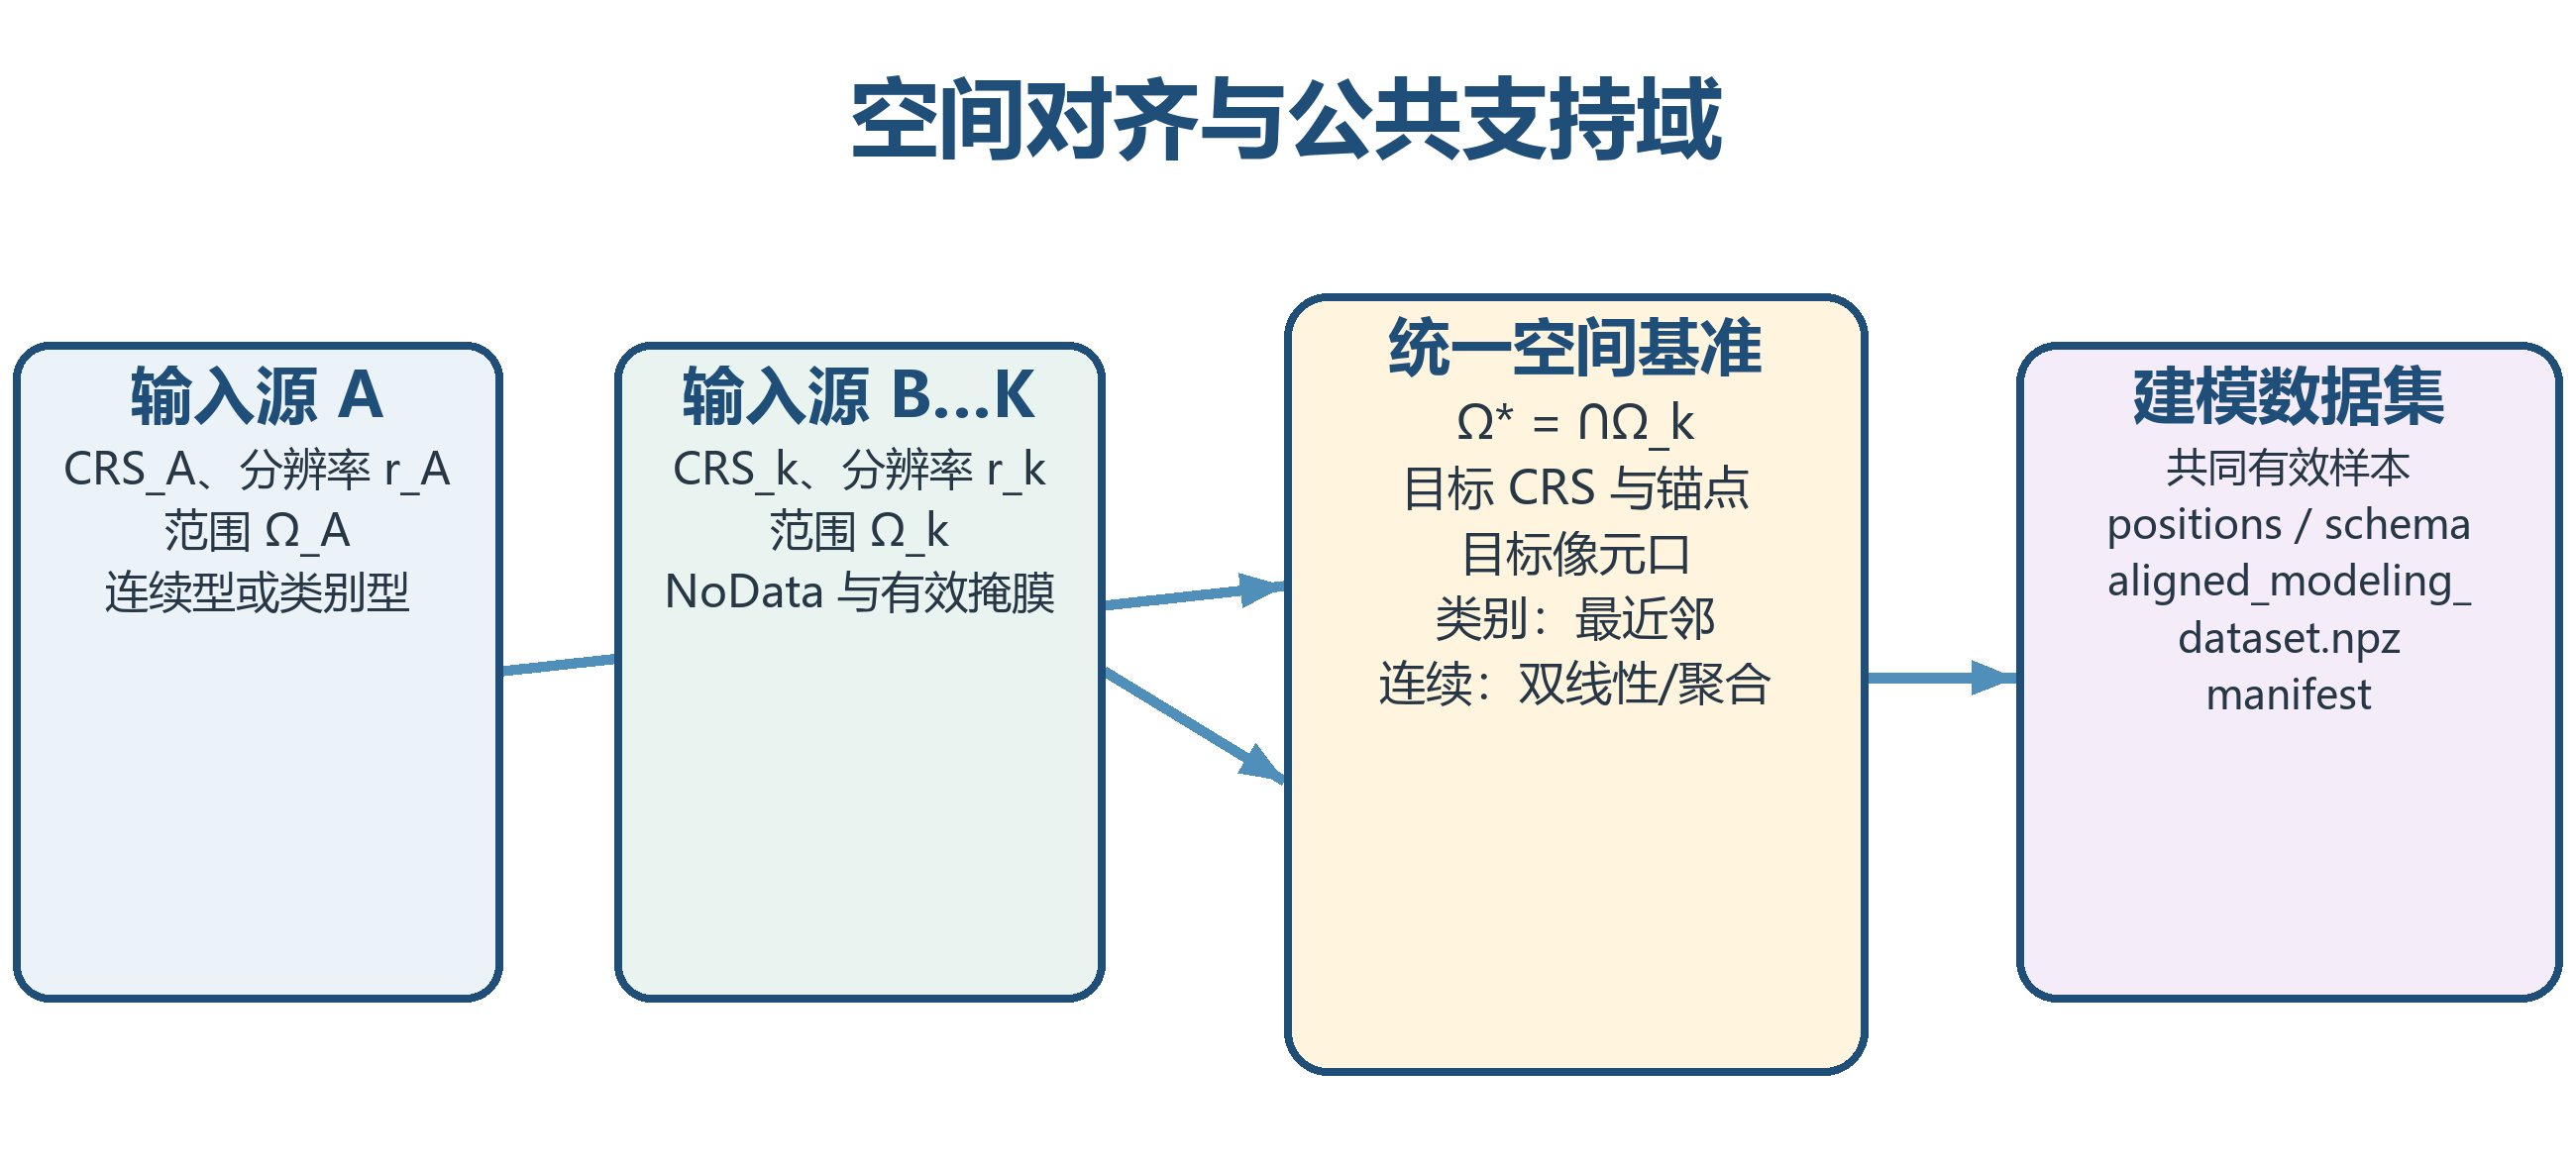
图 4-1 空间对齐、有效域构建与建模数据集形成
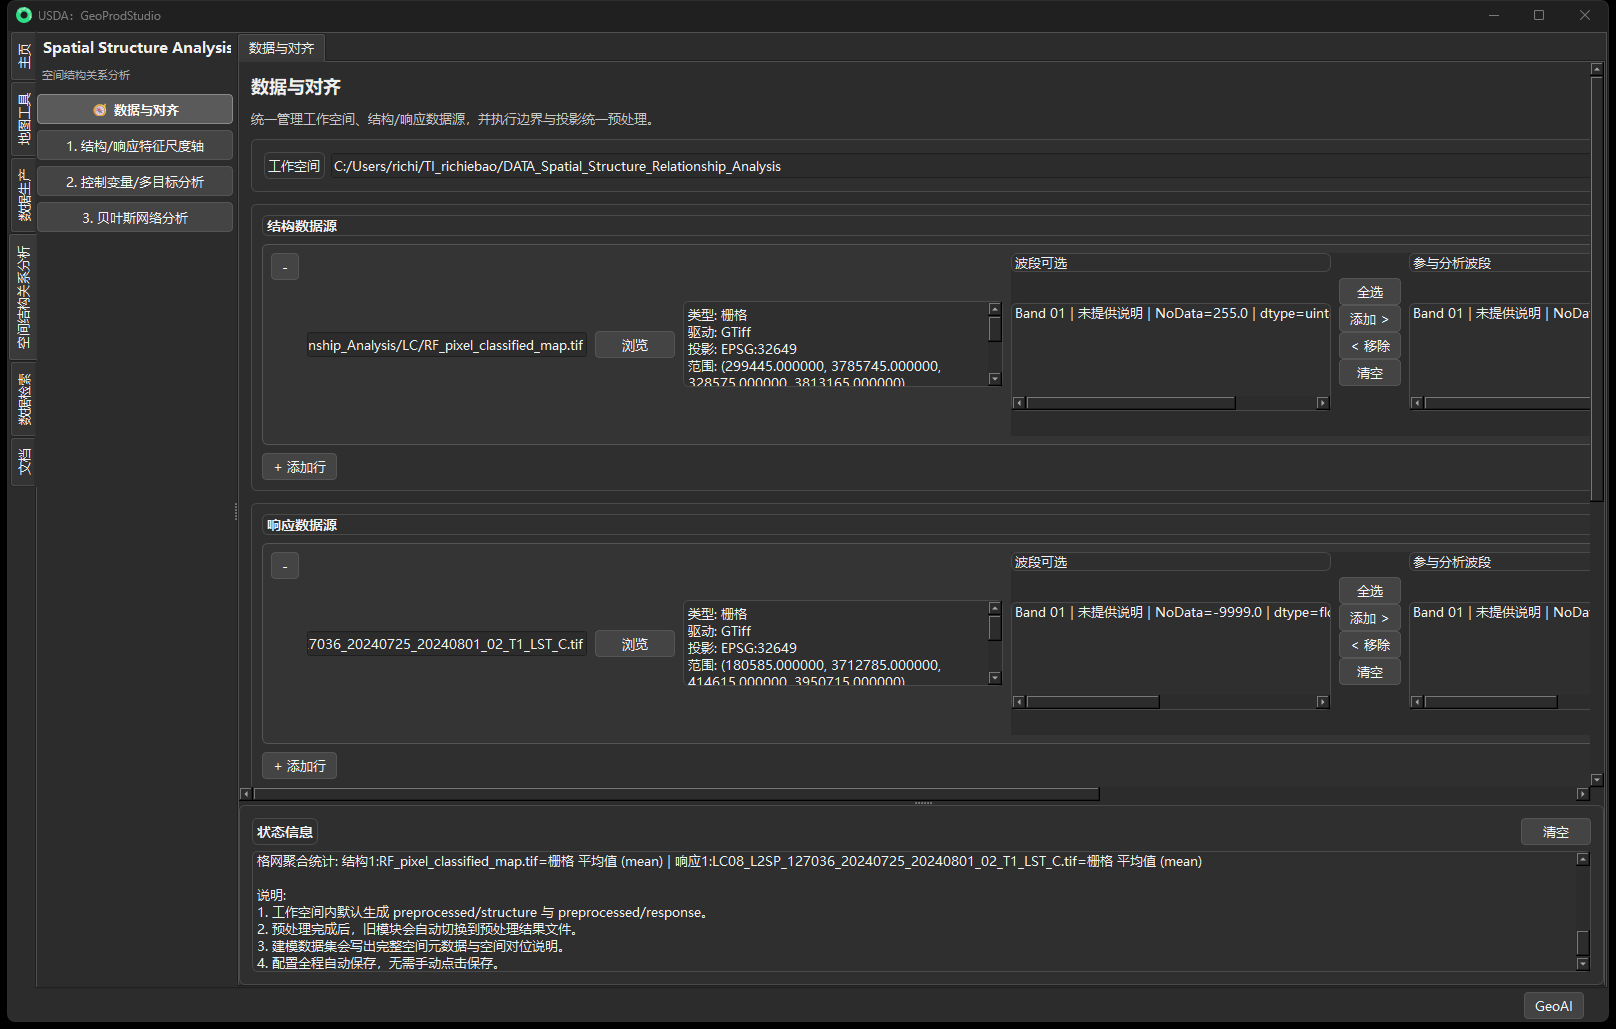
图 4-2 空间结构分析的数据角色、对齐与公共数据集配置
4.3 有效值、质量掩膜与数值规范
缓存和中间数组用于承载读取与对齐状态,正式建模使用阶段特征表及共同 positions。直接读取路径下 common_structure_grid.npy 或 common_response_grid.npy 可能为预分配的全 NaN 占位缓存,不能将其等同于正式特征矩阵或据此判断整批无数据。复核应同时检查 manifest、阶段完成状态、schema、表格有效行和来源信息。
4.4 数据资产、缓存与追踪
数据管理器使用 SQLite 保存路径、格式、空间参考、范围、分辨率、波段/字段和时间等元数据,索引指向原始数据而不复制大体量数据主体。不同城市、时相和服务主题可按同一资产规则管理。空间分析工作目录保存 aligned_modeling_dataset.npz、positions、schema、manifest 及各阶段结果;土地覆盖模型流程保存特征顺序、标签编码、类别体系、超参数、模型文件和评价文件。由此可从高效益单元或局部优化指标追溯到尺度、关系方法、响应数据、土地覆盖版本和原始输入。
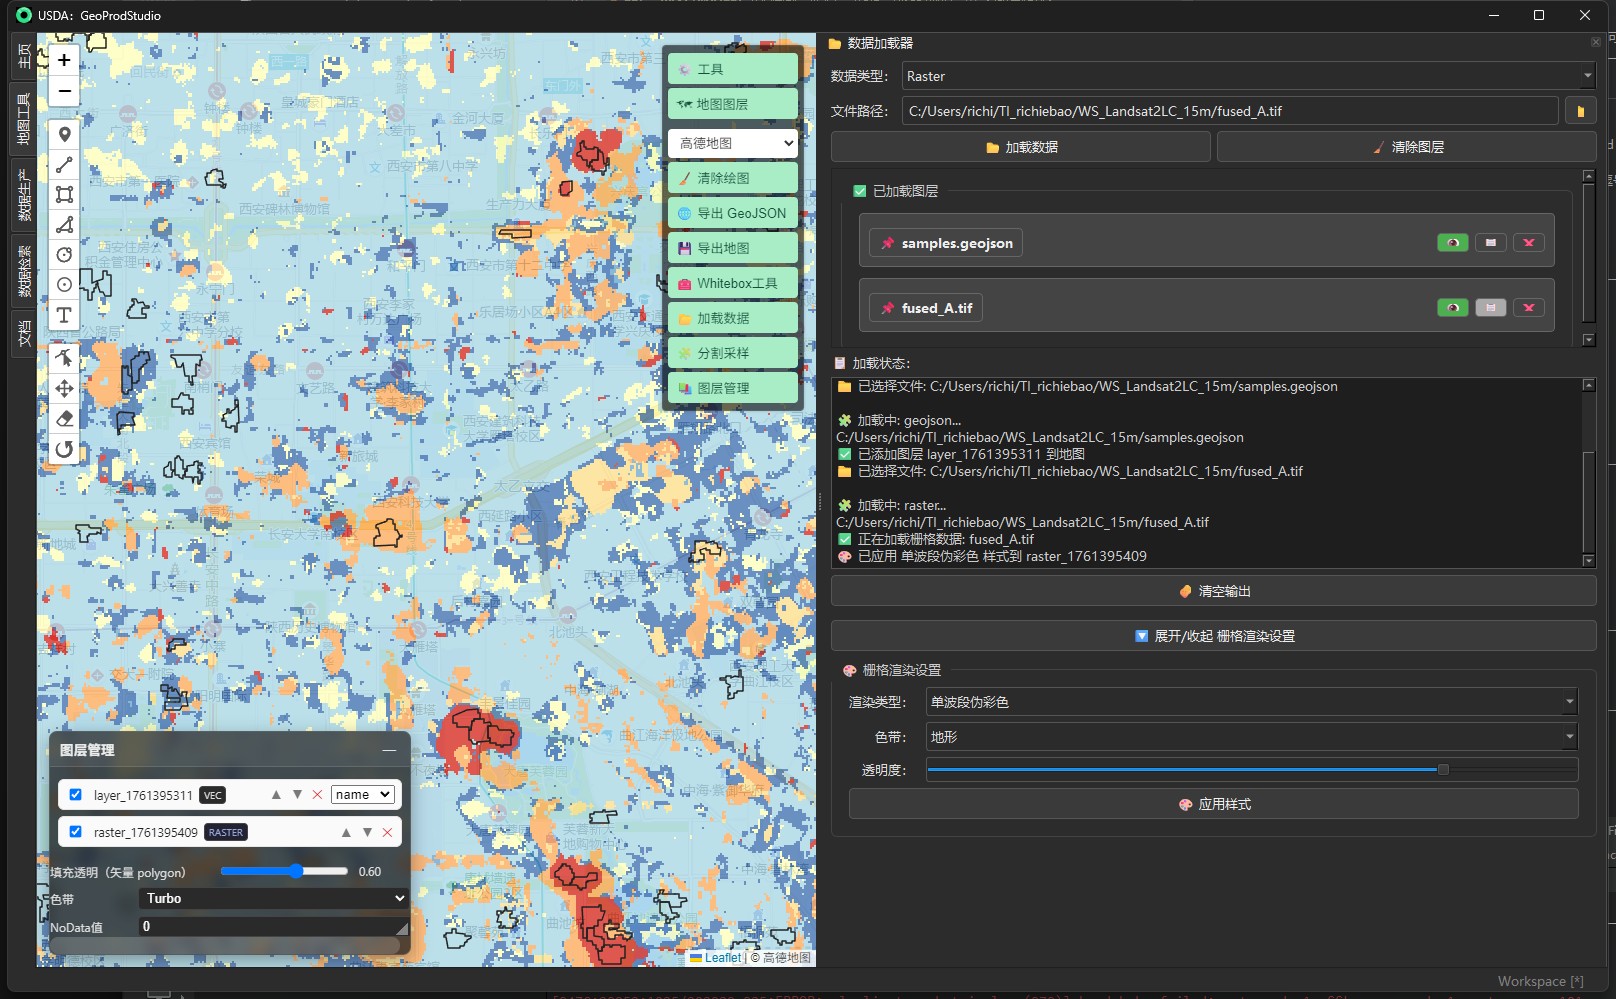
图 4-3 栅格数据加载、渲染与地图图层回显
遥感专题产品生产方法
5.1 土地覆盖产品:方法框架
土地覆盖产品采用**“轻数据、强特征”方法框架:以 Landsat 多光谱/全色波段与 DEM 为主要输入,不依赖复杂多源数据融合,通过充分挖掘光谱、地形、纹理、时序和空间窗口信息实现面向建成区的高精度解译。生产链由数据准备、自动化分割—采样、多域特征、样本数据集、模型训练、块式预测和模型融合构成。数据准备明确 Landsat 波段语义、DEM、样本矢量和目标空间基准,将30 m反射型多光谱波段与15 m全色波段完成配准和共同范围裁剪后,采用Brovey变换生成具有15 m像元网格和更丰富空间细节的融合影像;训练集按用户指定的样本属性字段读取类别并动态编码,不预置固定土地覆盖类型;传统模型与 ResNet 独立训练并保存参数;预测按训练时的特征顺序分块推理;融合先按类别名称统一各模型标签,再以投票、概率或按类优选规则形成最终产品。输入清单、特征 schema、标签编码、模型、参数、随机种子、评价文件和输出路径共同形成可追溯的可复现性**证据链。
| **三类数据问题的技术闭环 **建成区精细识别由 15 m 全色融合、对象样本、多域特征和模型融合共同支撑;类别可变性由样本字段—标签编码—预测调色的一致语义链保证;时相可配置性由多景 Landsat 输入、时序统计特征、模型复用和按场景重复生产保证。 |
|---|
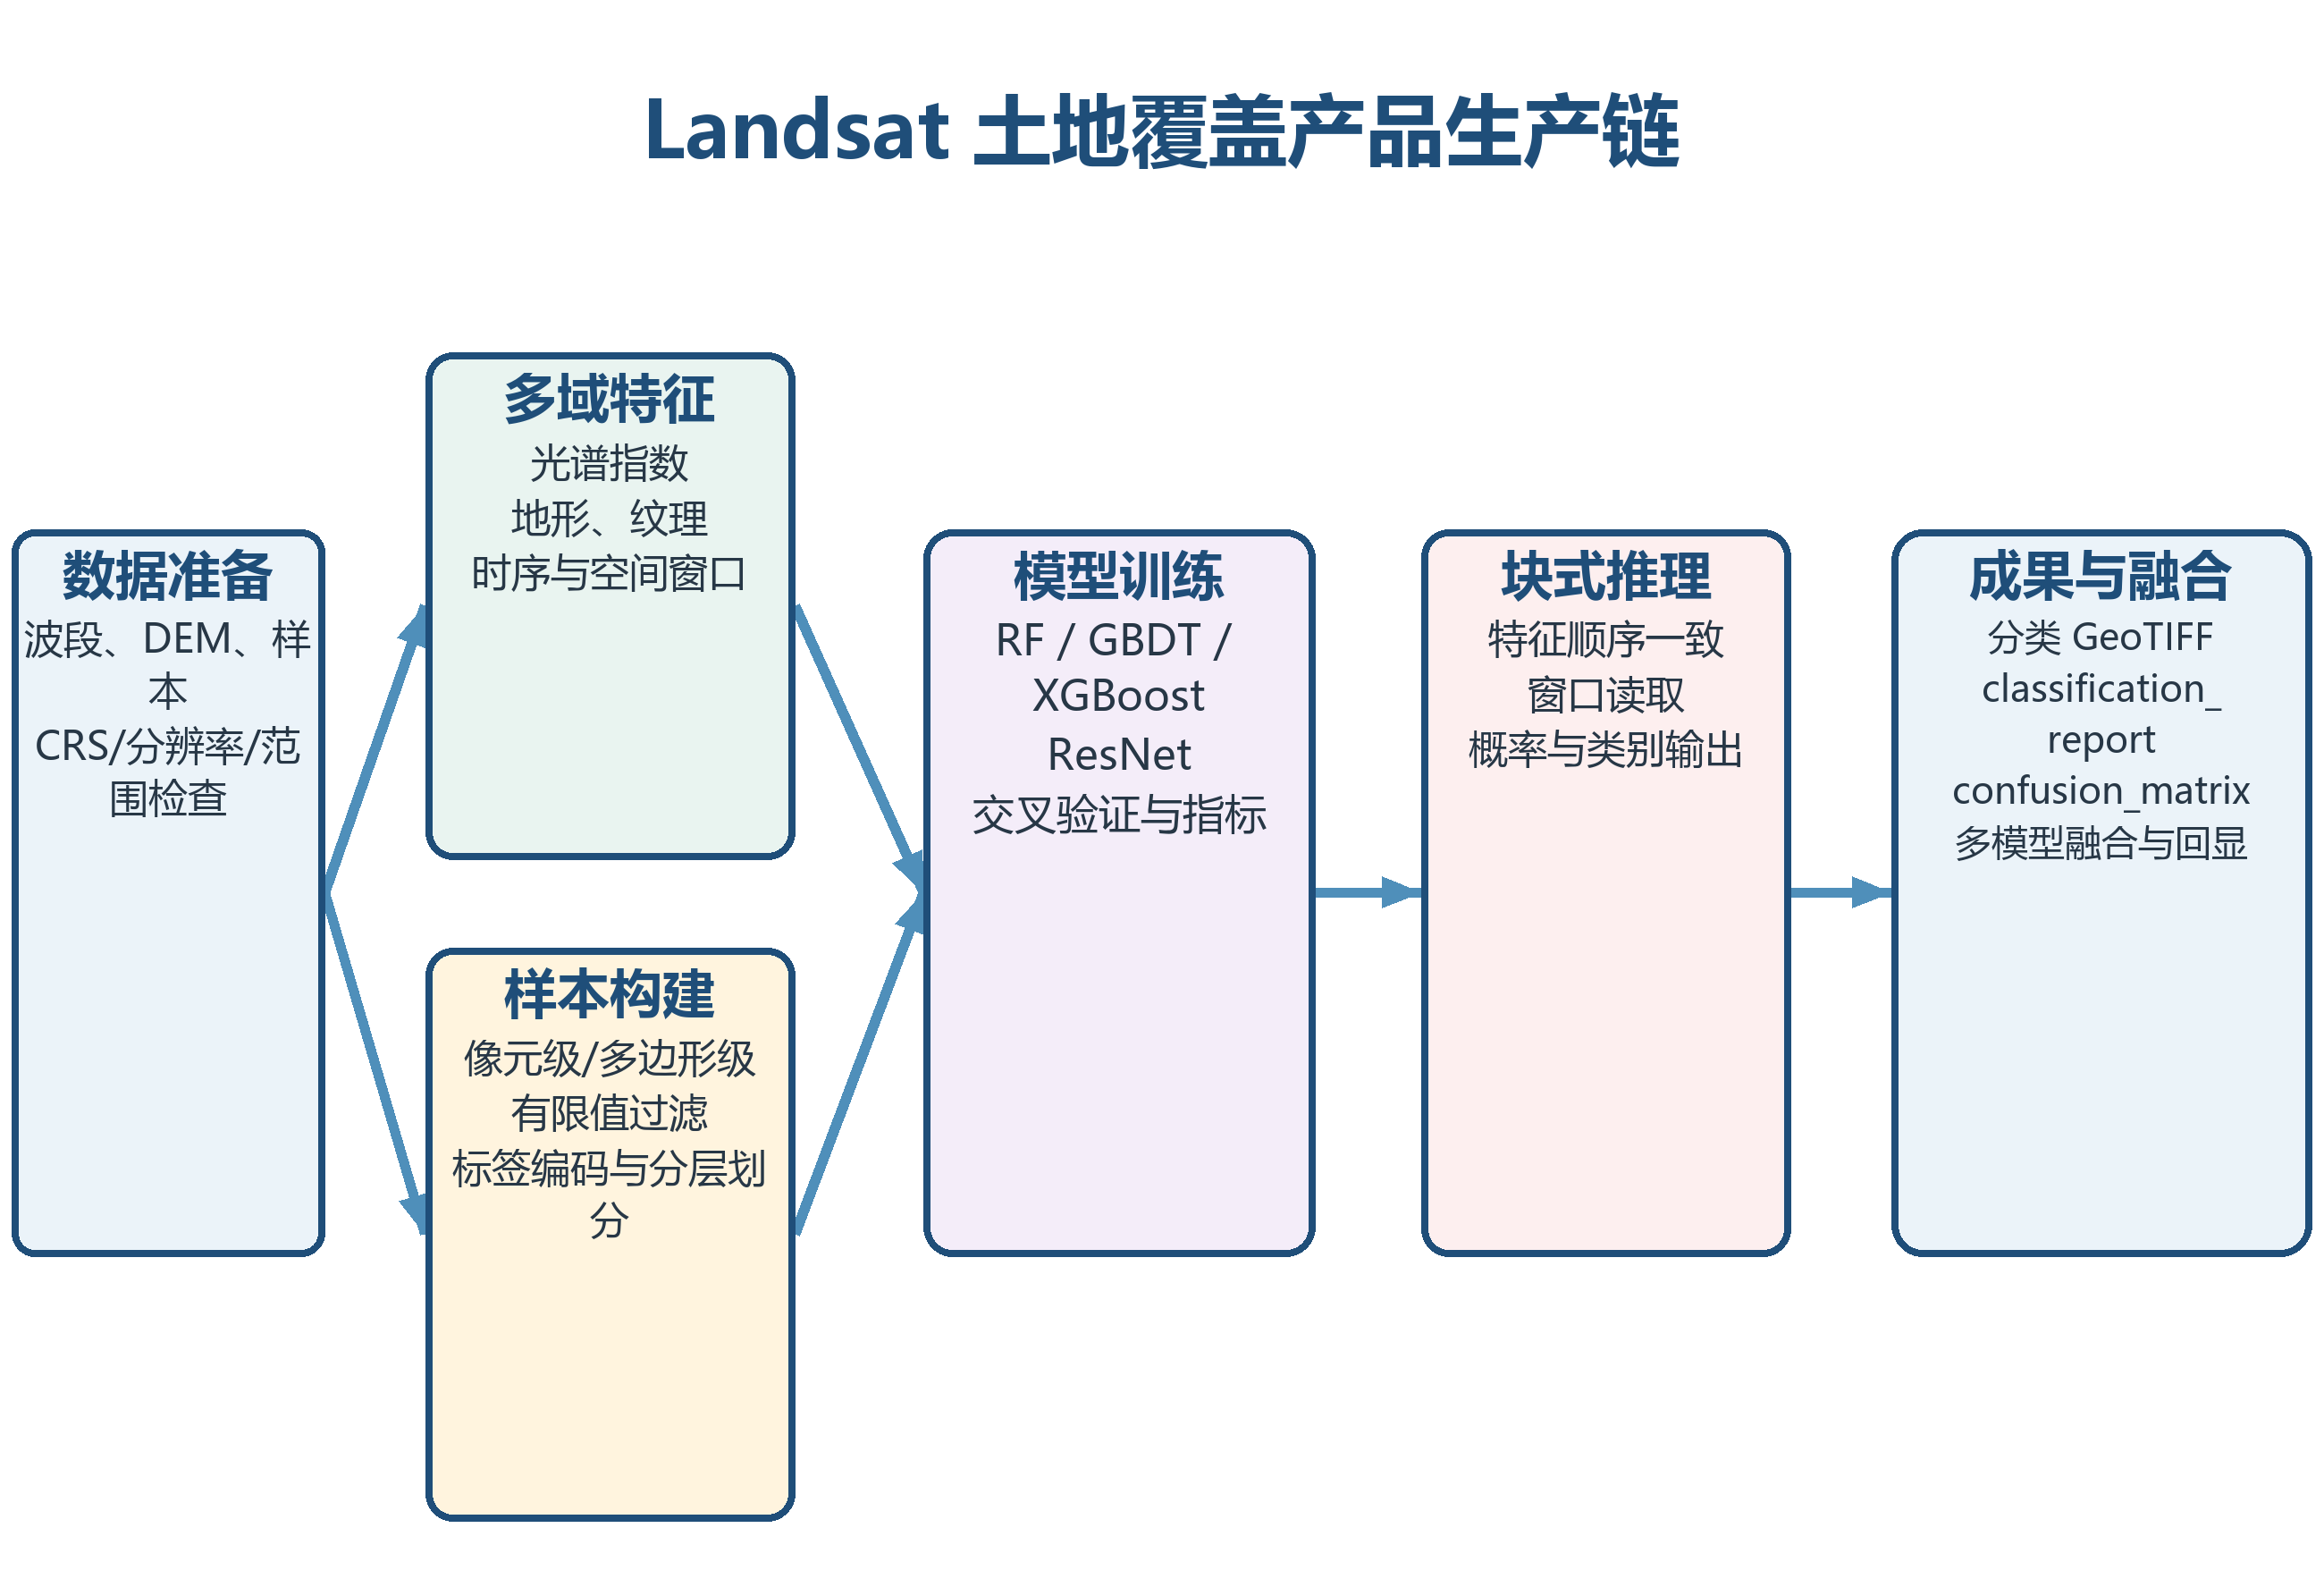
图 5-1 Landsat 土地覆盖产品的计算与成果链
5.2 光谱、地形、纹理、时序与空间特征
**“强特征”**并非简单增加变量数量,而是围绕城市蓝绿空间的可分性系统组织互补信息。光谱特征既保留原始或定标波段,也构造对植被、水体、建筑与裸地敏感的指数;指数在共同有效掩膜上计算并设置分母数值保护。NDVI、EVI、SAVI、MNDWI、NDBI 分别突出植被活力、冠层响应、土壤背景校正、开放水体和建设用地,实现还包含 GNDVI、NDMI、NBR、AWEI、BSI、IBI、DBSI 等互补指标,具体目录与公式列于附录 A、B。
NDVI = (ρNIR − ρRed)/(ρNIR + ρRed);
EVI = 2.5(ρNIR − ρRed)/(ρNIR + 6ρRed − 7.5ρBlue + 1);
MNDWI = (ρGreen − ρSWIR1)/(ρGreen + ρSWIR1);
NDBI = (ρSWIR1 − ρNIR)/(ρSWIR1 + ρNIR)
式中,ρ 表示经 Level-2 比例因子与偏移量换算后的地表反射率,下标 NIR、Red、Green、Blue 和 SWIR1 分别表示近红外、红、绿、蓝和短波红外 1 波段;对 Landsat 8/9 分别对应 B5、B4、B3、B2 和 B6。NDVI、EVI、MNDWI 和 NDBI 分别为归一化植被指数、增强型植被指数、改进型归一化差异水体指数和归一化差异建筑指数。EVI 中 2.5 为增益系数,6 和 7.5 为红、蓝波段气溶胶校正系数,常数 1 为冠层背景调节项。
地形特征由 DEM 派生高程、坡度、坡向及局部地形统计,用于刻画自然背景;纹理特征采用灰度共生矩阵、灰度游程和局部二值模式等统计描述建成区内部排列;时序特征对多景数据计算均值、标准差、方差、极值、极差、中位数、四分位数、四分位距和峰值时相,并可构造 NDVI 季节离散度、极差与最大值位置;空间窗口特征计算局部均值、标准差和极值等。该**“轻数据、强特征”**组合以少量稳定数据源承载多维判别信息,减少复杂多源数据在时相、尺度和覆盖范围上的耦合成本,以及数据的不可获得性。所有特征合并时校验形状、仿射变换和像元对齐,保存稳定字段顺序,并将特征定义与模型共同留存,保证训练、验证和推理过程一致且可复现。
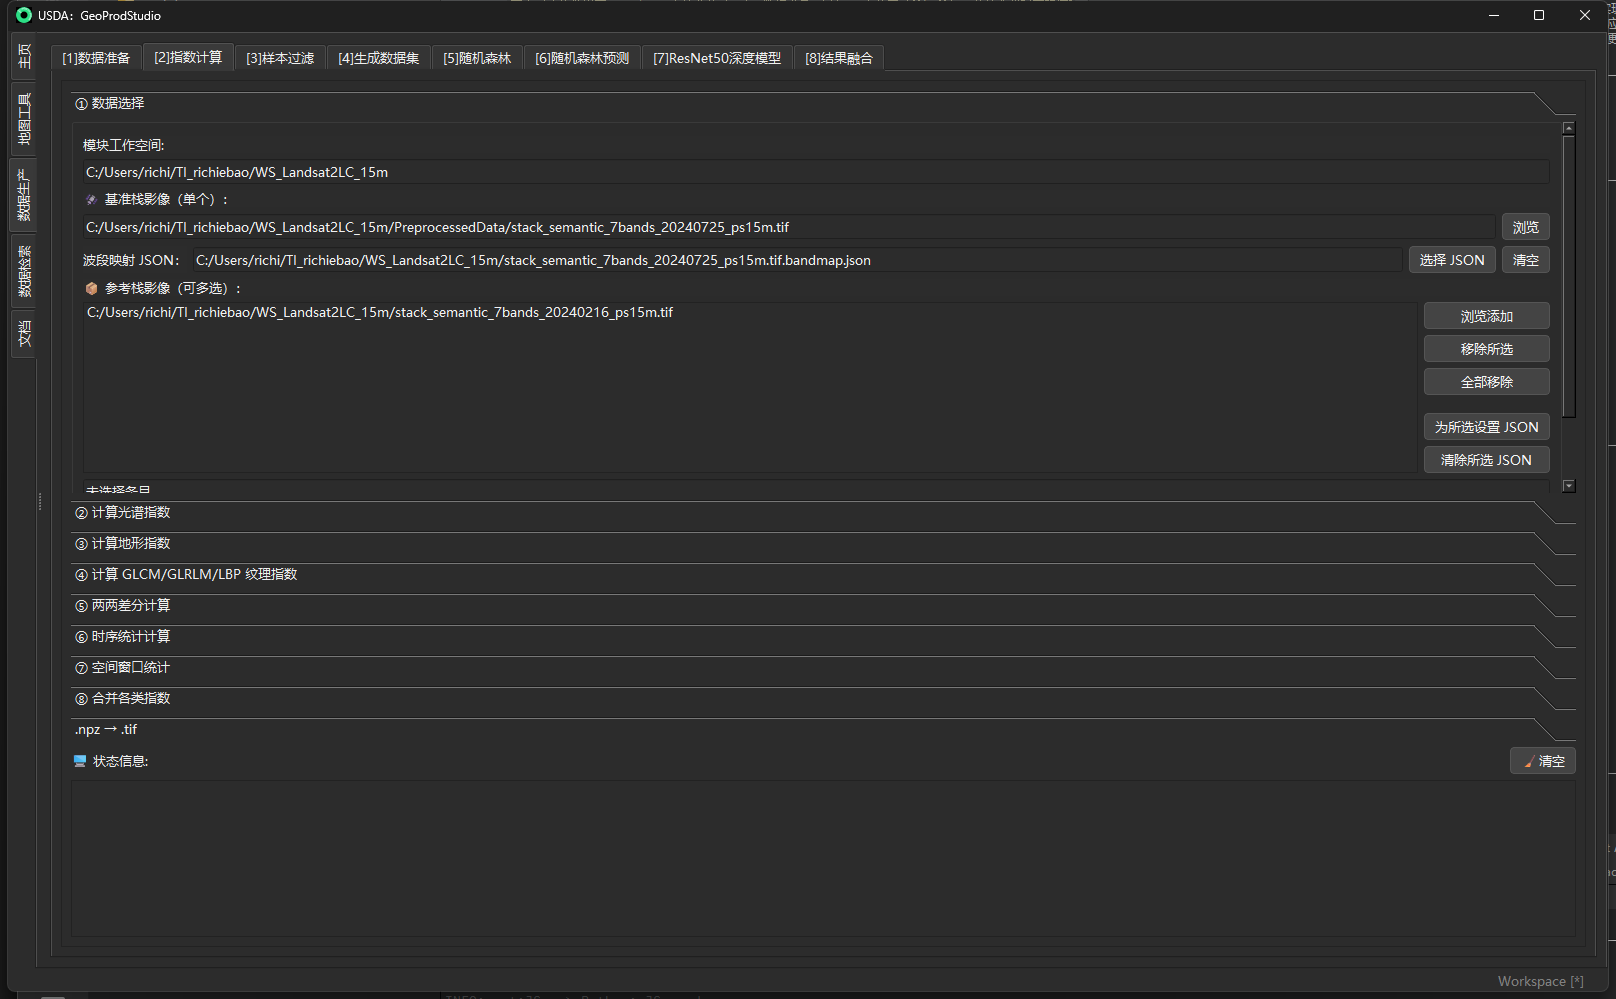
图 5-2 土地覆盖数据源、波段及辅助数据选择
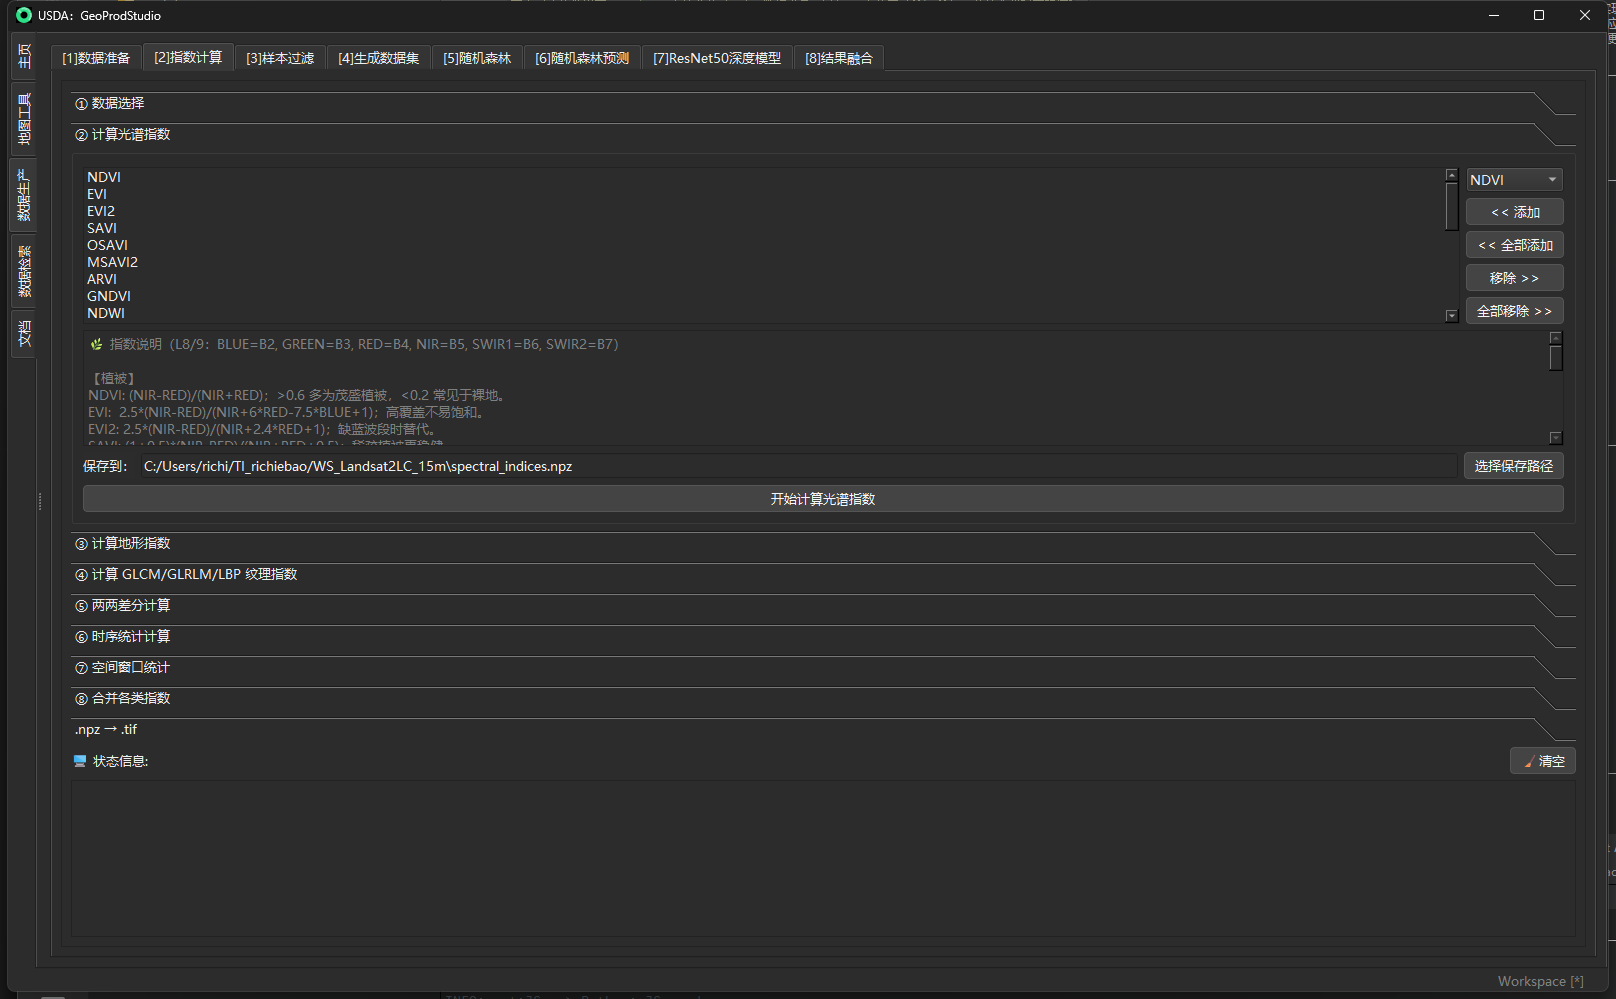
图 5-3 光谱指数配置与特征生产
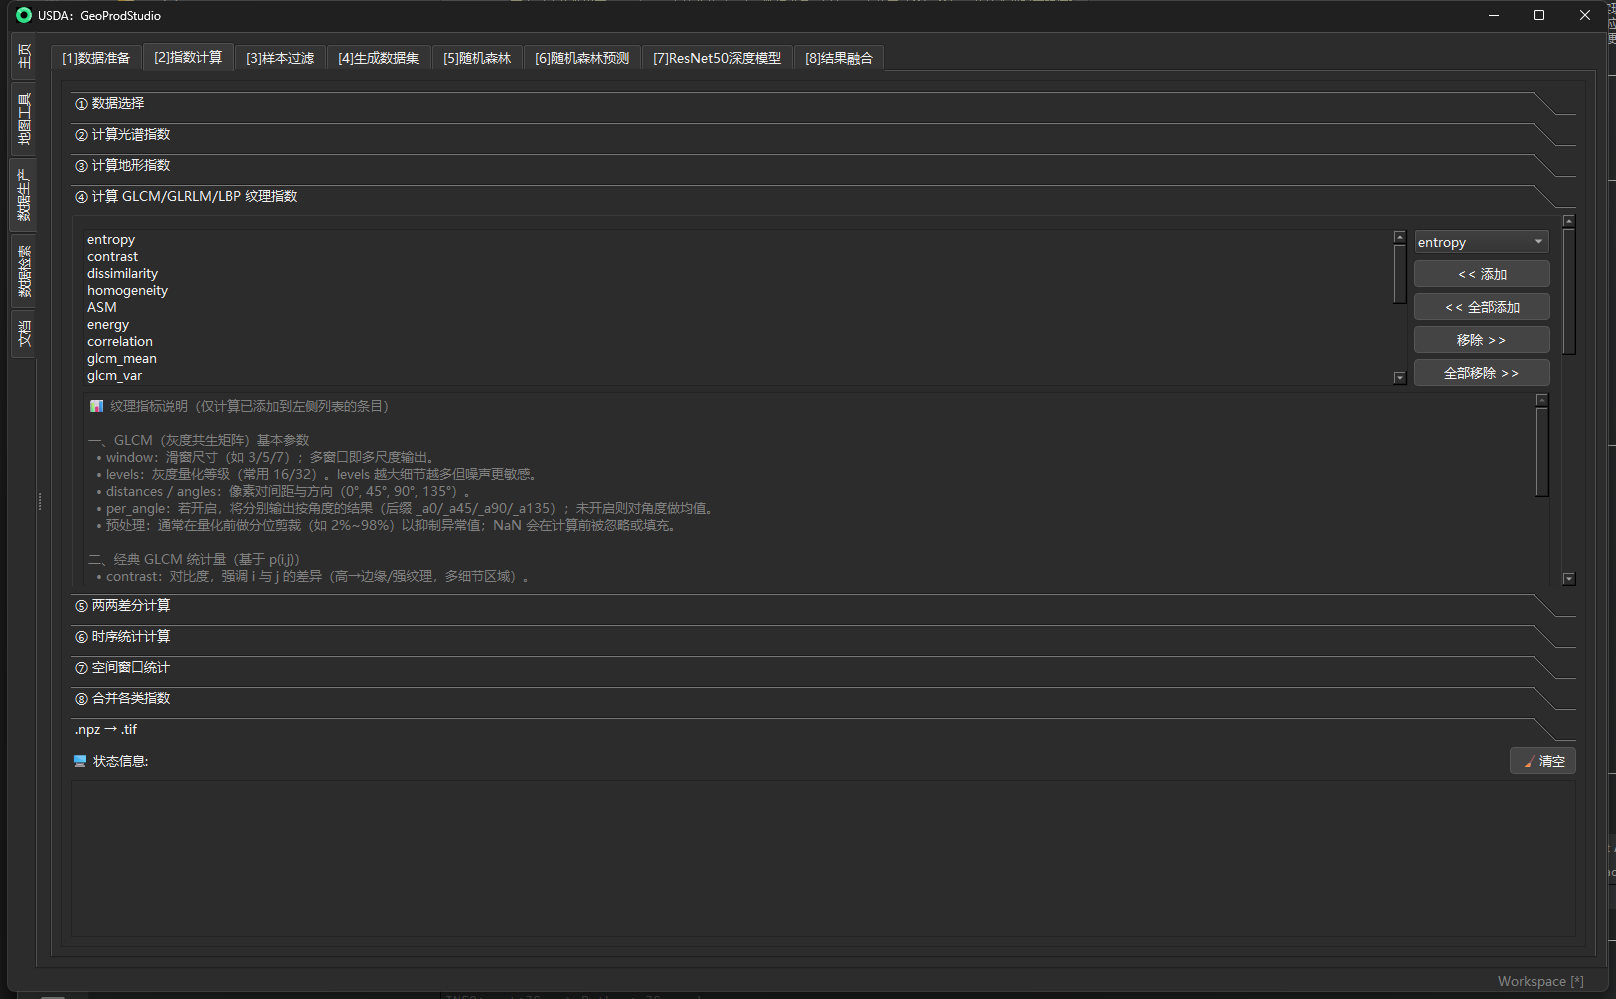
图 5-4 纹理特征及参数配置
5.3 训练样本与模型
像元级训练集直接从样本覆盖像元提取特征,适合保持建成区细小边界;多边形级训练集对对象内部特征聚合,降低同一对象内像元重复性并强化公园、水体、街旁绿地或建设斑块的对象语义。类别名称取自配置的 class_column,并由 LabelEncoder 生成当次任务的类别顺序,因此研究者可依据课题对象建立“水体—乔灌草—建设—道路—裸地”等概化体系,也可建立更细的本地类型体系。数据集记录样本来源、标签字段、classes(类别)、特征列表、筛选规则和数据划分。随机森林通过多棵决策树的自助采样与随机特征子集降低单树方差;梯度提升模型逐步拟合残差以表达复杂边界;ResNet 通过残差连接学习局部图像块的层次特征。
ŷ = mode{h₁(x), h₂(x), …, hB(x)}
式中,x 为输入特征向量,h_b(x) 为第 b 棵决策树对 x 给出的类别预测,b 为树索引,B 为树的总数,mode{·} 表示取众数,ŷ 为集成模型最终预测类别。模型文件与特征顺序共同保存,预测时按同一顺序组织输入。
y = F(x) + x
式中,x 为残差块输入,F(x) 为网络需要学习的残差映射,y 为残差块输出,“+”表示逐元素相加,恒等路径把 x 直接传递至输出。该结构改善深层网络的梯度传播;类别损失、批次、学习率、训练轮次和随机种子由配置记录。
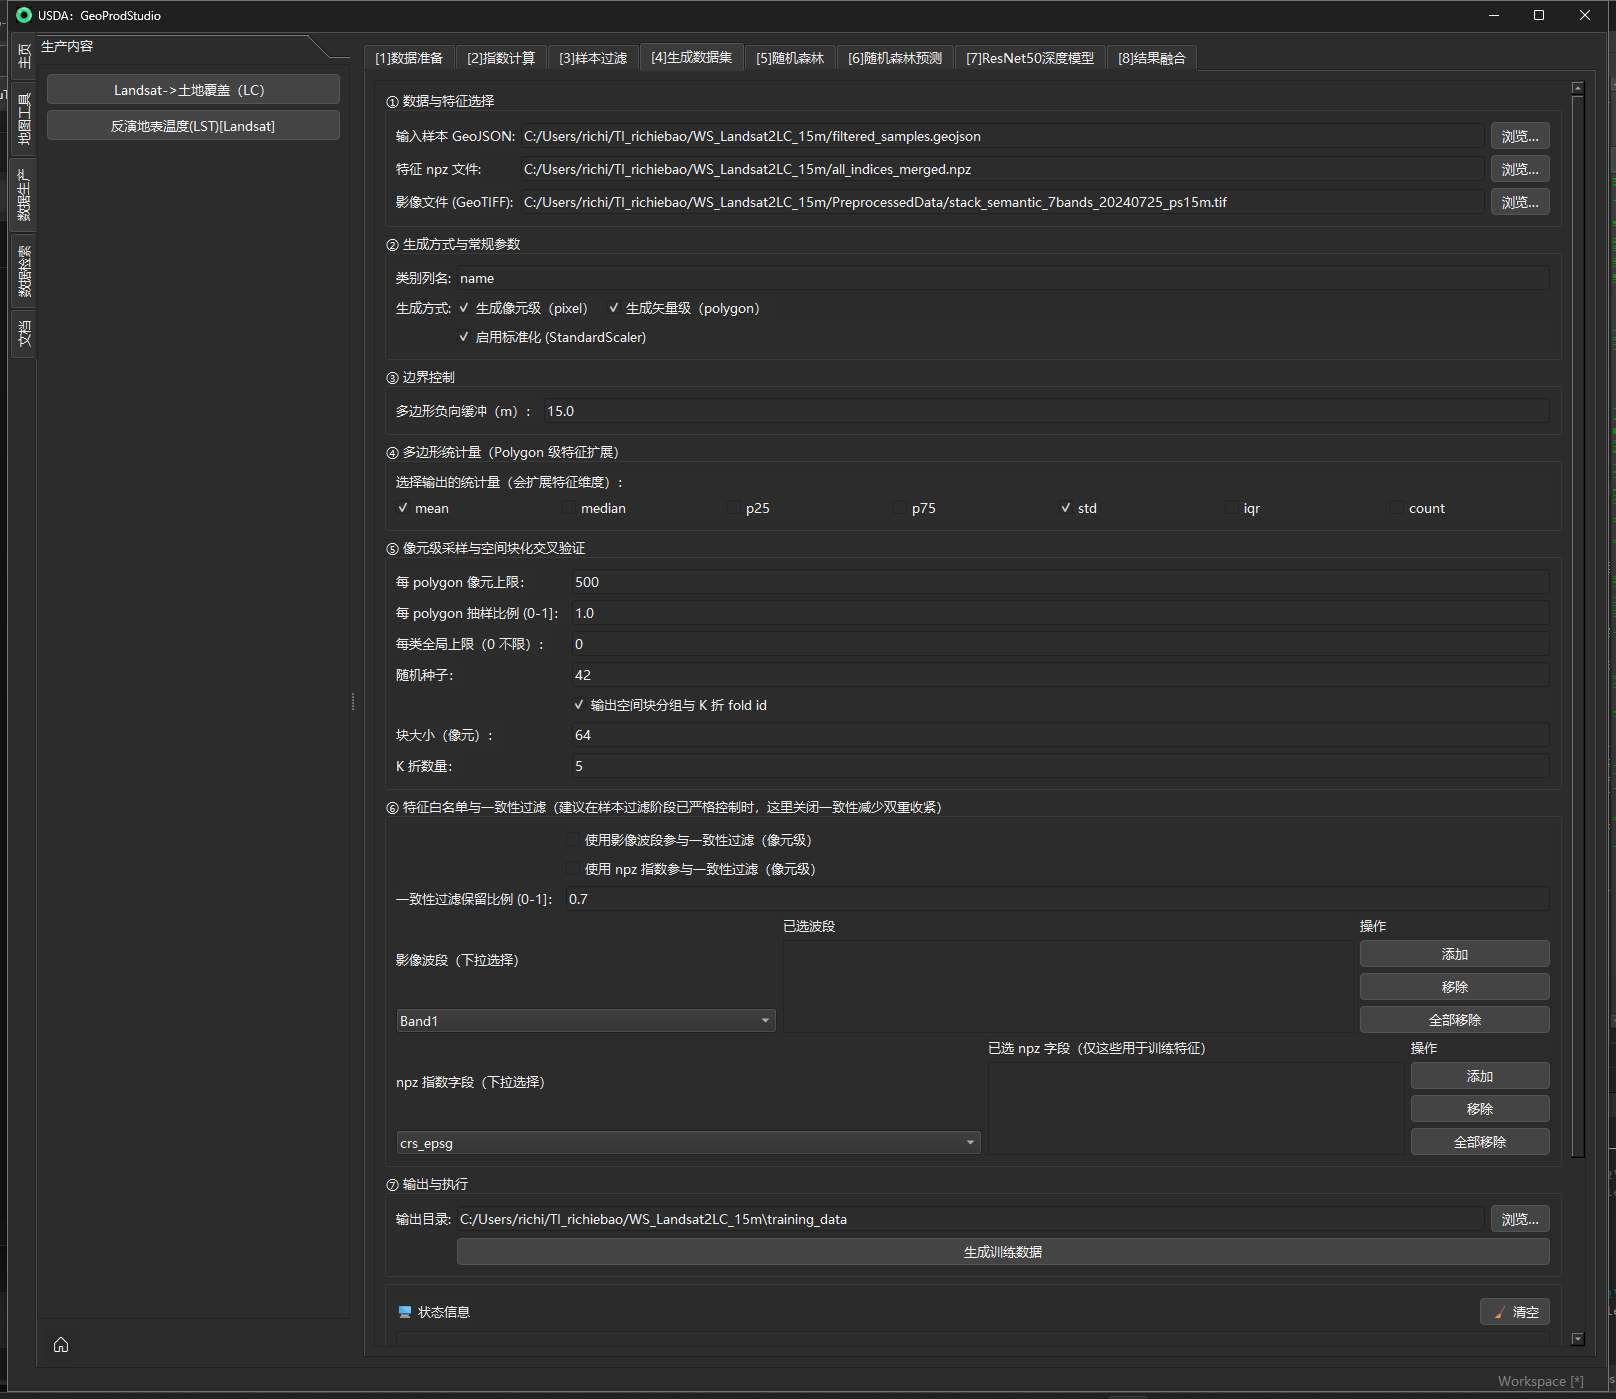
图 5-5 训练数据集生成及样本/特征组织
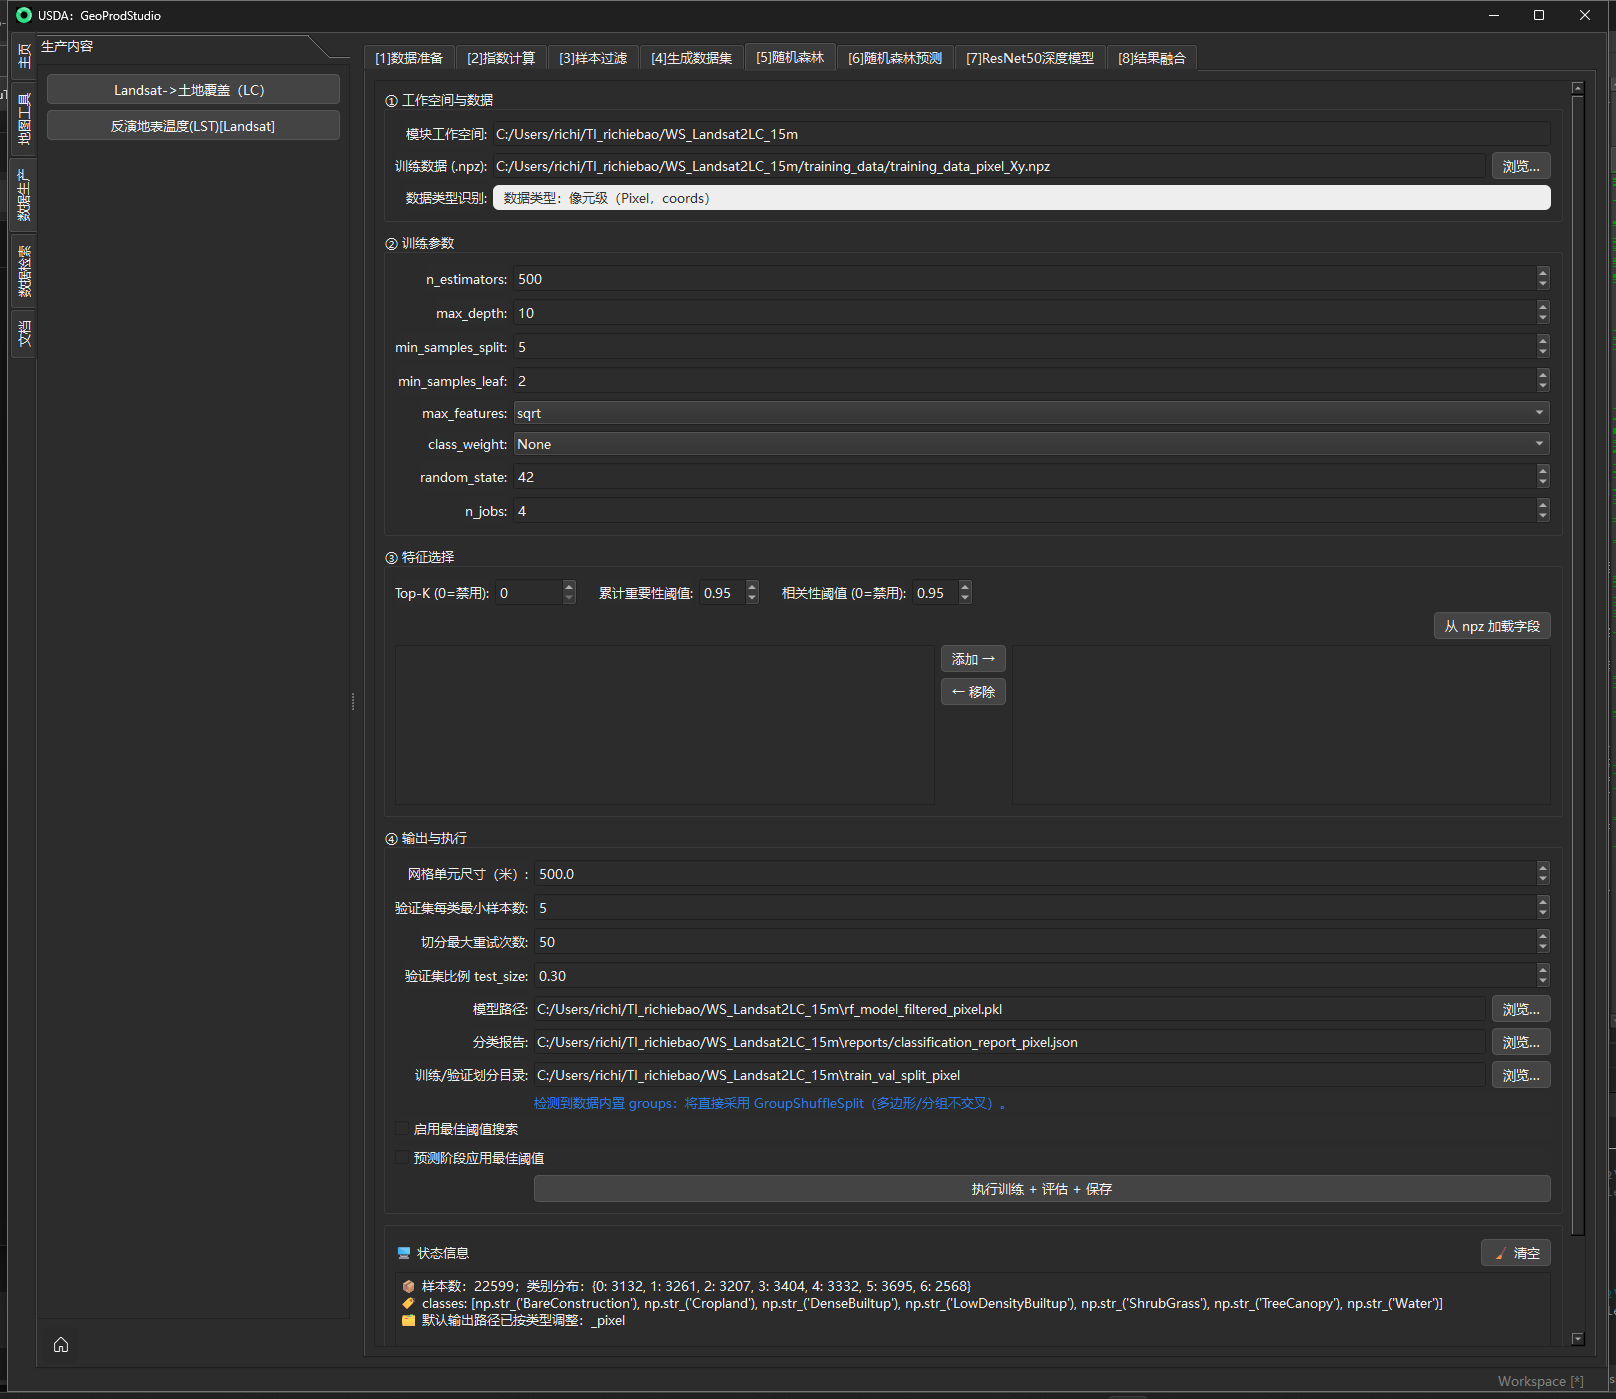
图 5-6 像元级随机森林训练配置
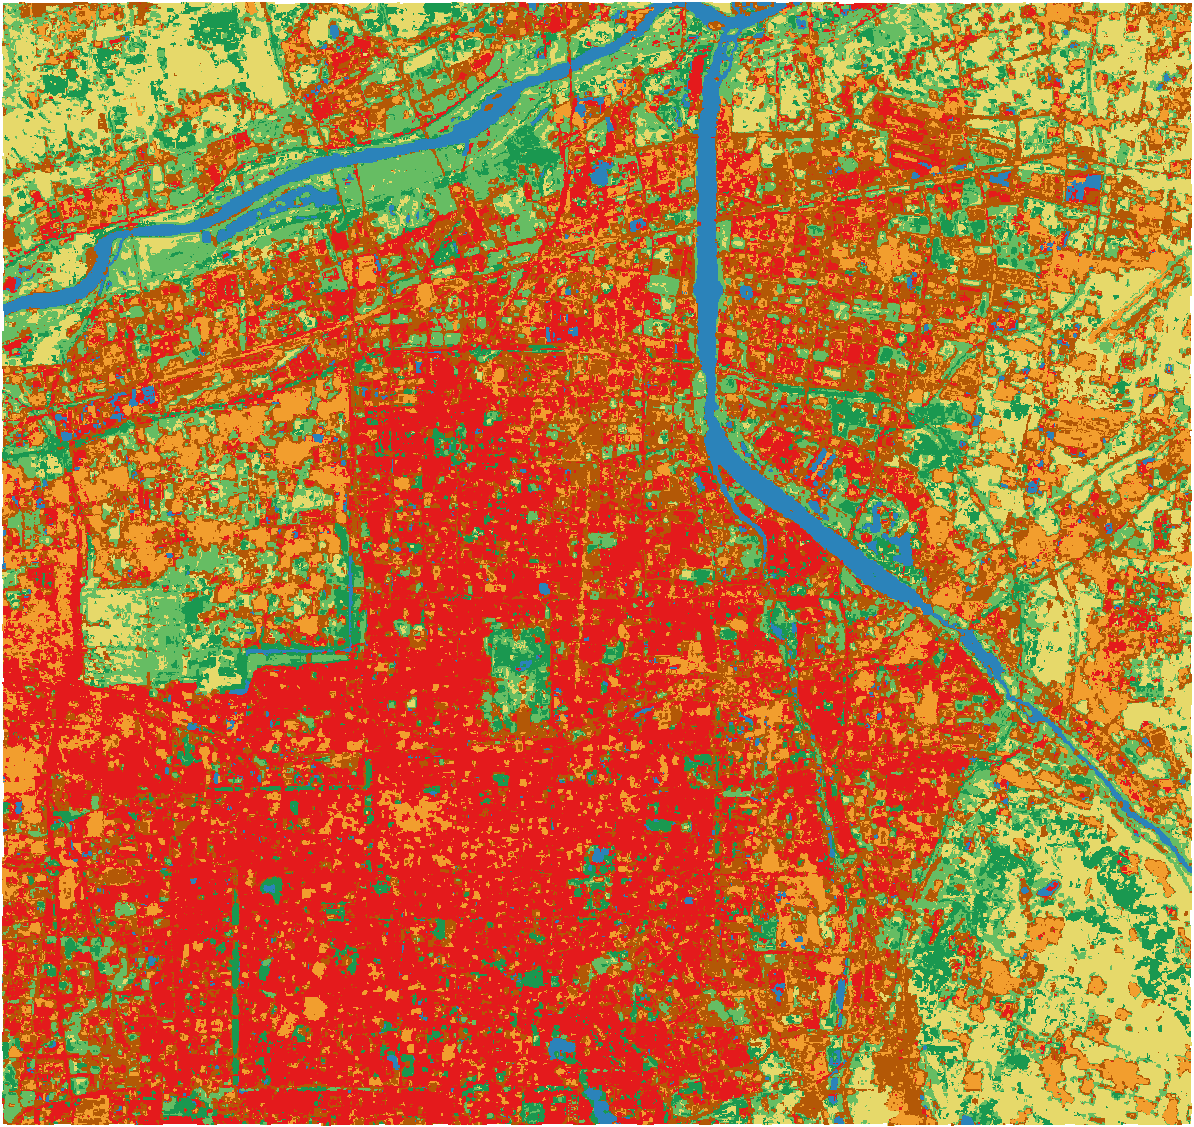
图 5-7 随机森林分类结果的栅格化输出与回显
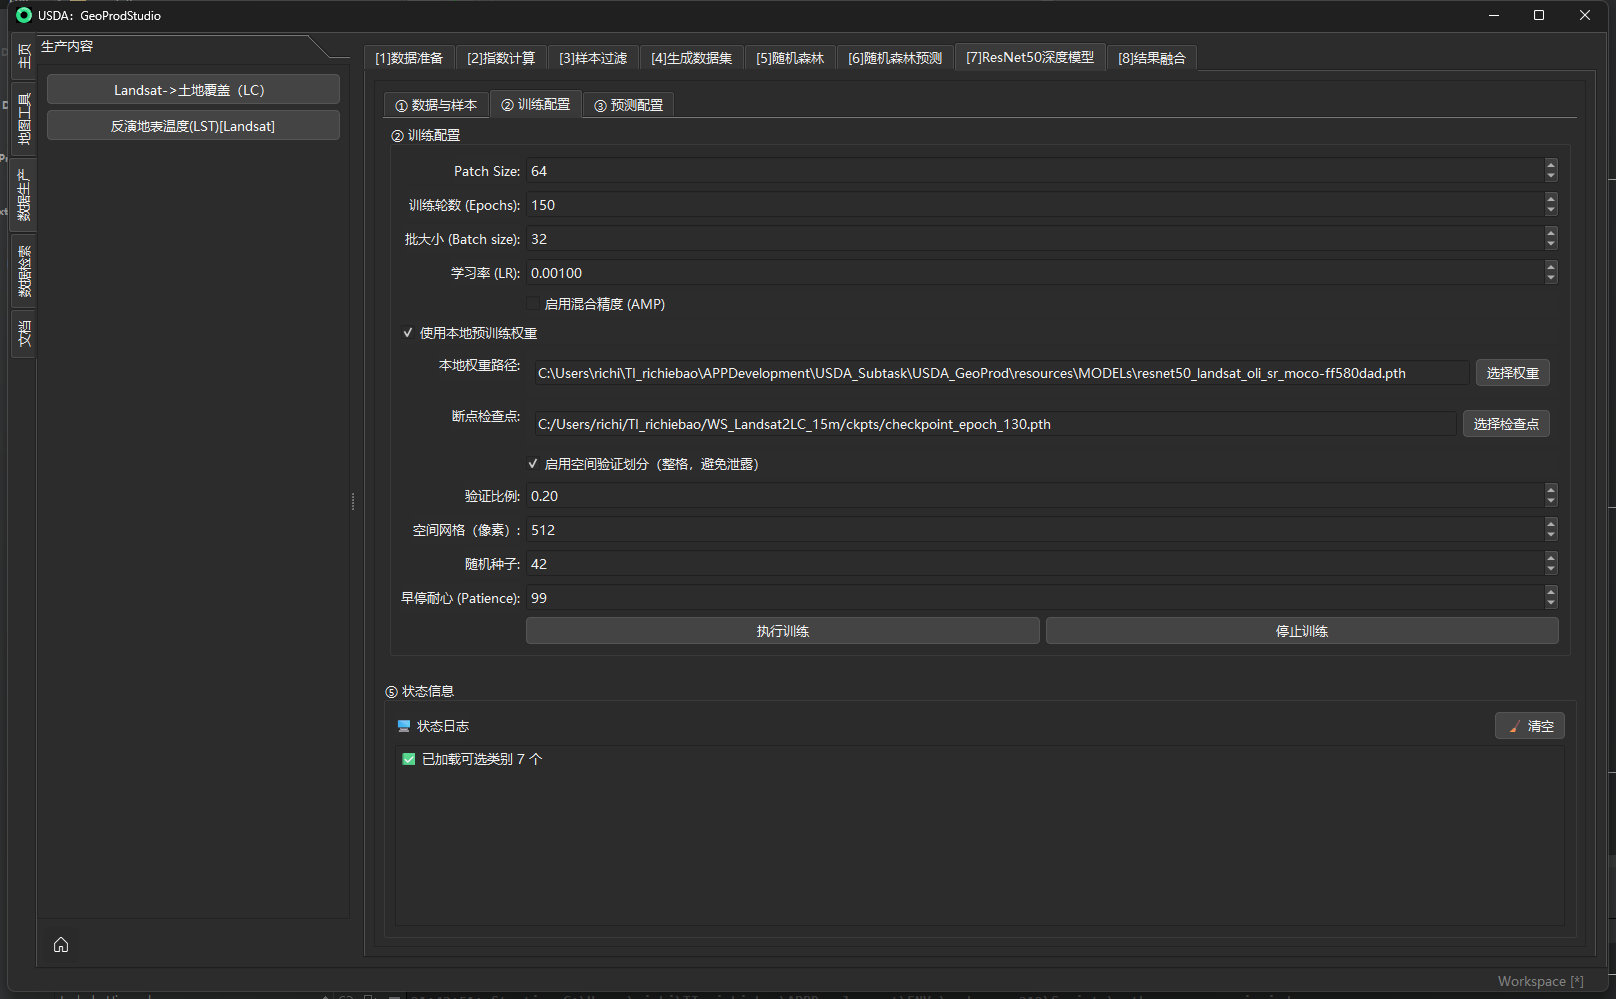
图 5-8 ResNet 数据、训练与模型参数配置
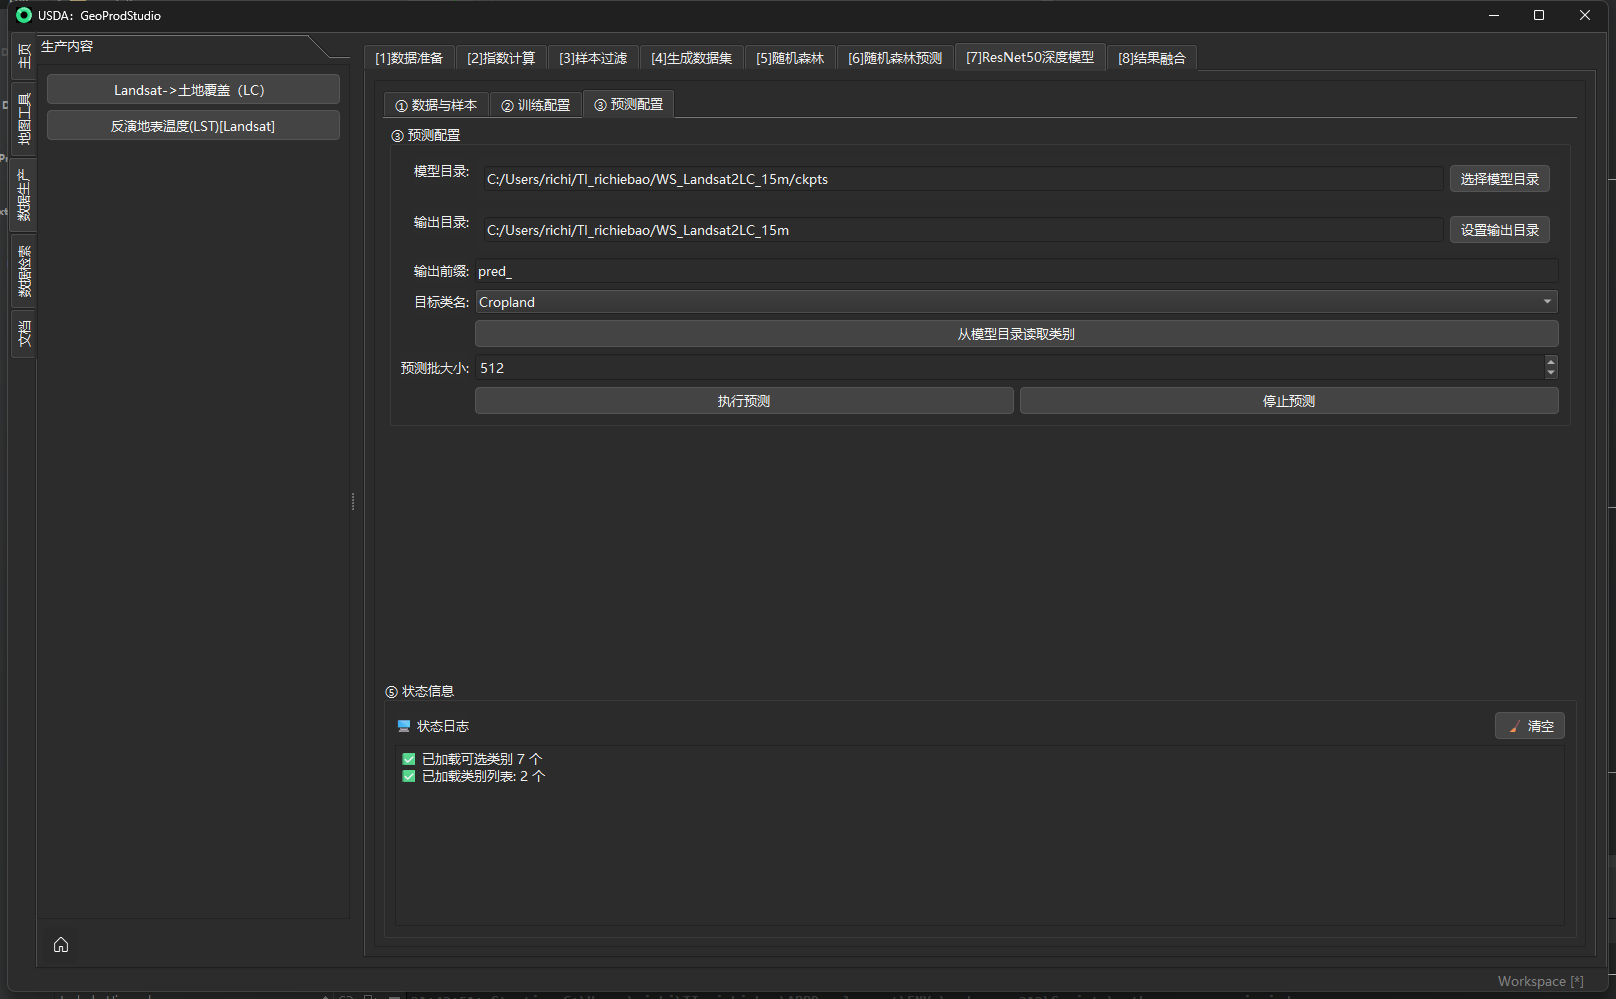
图 5-9 ResNet 块式推理流程
5.4 模型评价、预测与融合
分类流程输出混淆矩阵、总体准确率及按类别的 precision、recall、F1-score 和 support。类别级指标直接对应课题自定义分类体系,如可定位建成区中水体、植被、道路和建设用地等易混类别;分层划分用于维持类别比例,跨区域验证可采用空间块或独立样区。预测模块按影像窗口读取所需特征,只对共同有效像元推理,并保持输入变换、特征顺序和标签编码一致。融合阶段先根据类别名称把不同模型输出映射到统一类别顺序,再执行多数投票、性能加权、概率加权或按类最优选择,避免模型内部编码差异改变土地覆盖语义。
Precisionₖ = TPₖ/(TPₖ+FPₖ); Recallₖ = TPₖ/(TPₖ+FNₖ); F1ₖ = 2PR/(P+R)
式中,k 为类别索引,TPₖ、FPₖ 和 FNₖ 分别为类别 k 的真正例、假正例和假负例数量;P 和 R 分别是该类别 Precisionₖ(精确率)与 Recallₖ(召回率)的简写,F1ₖ 为二者的调和平均。
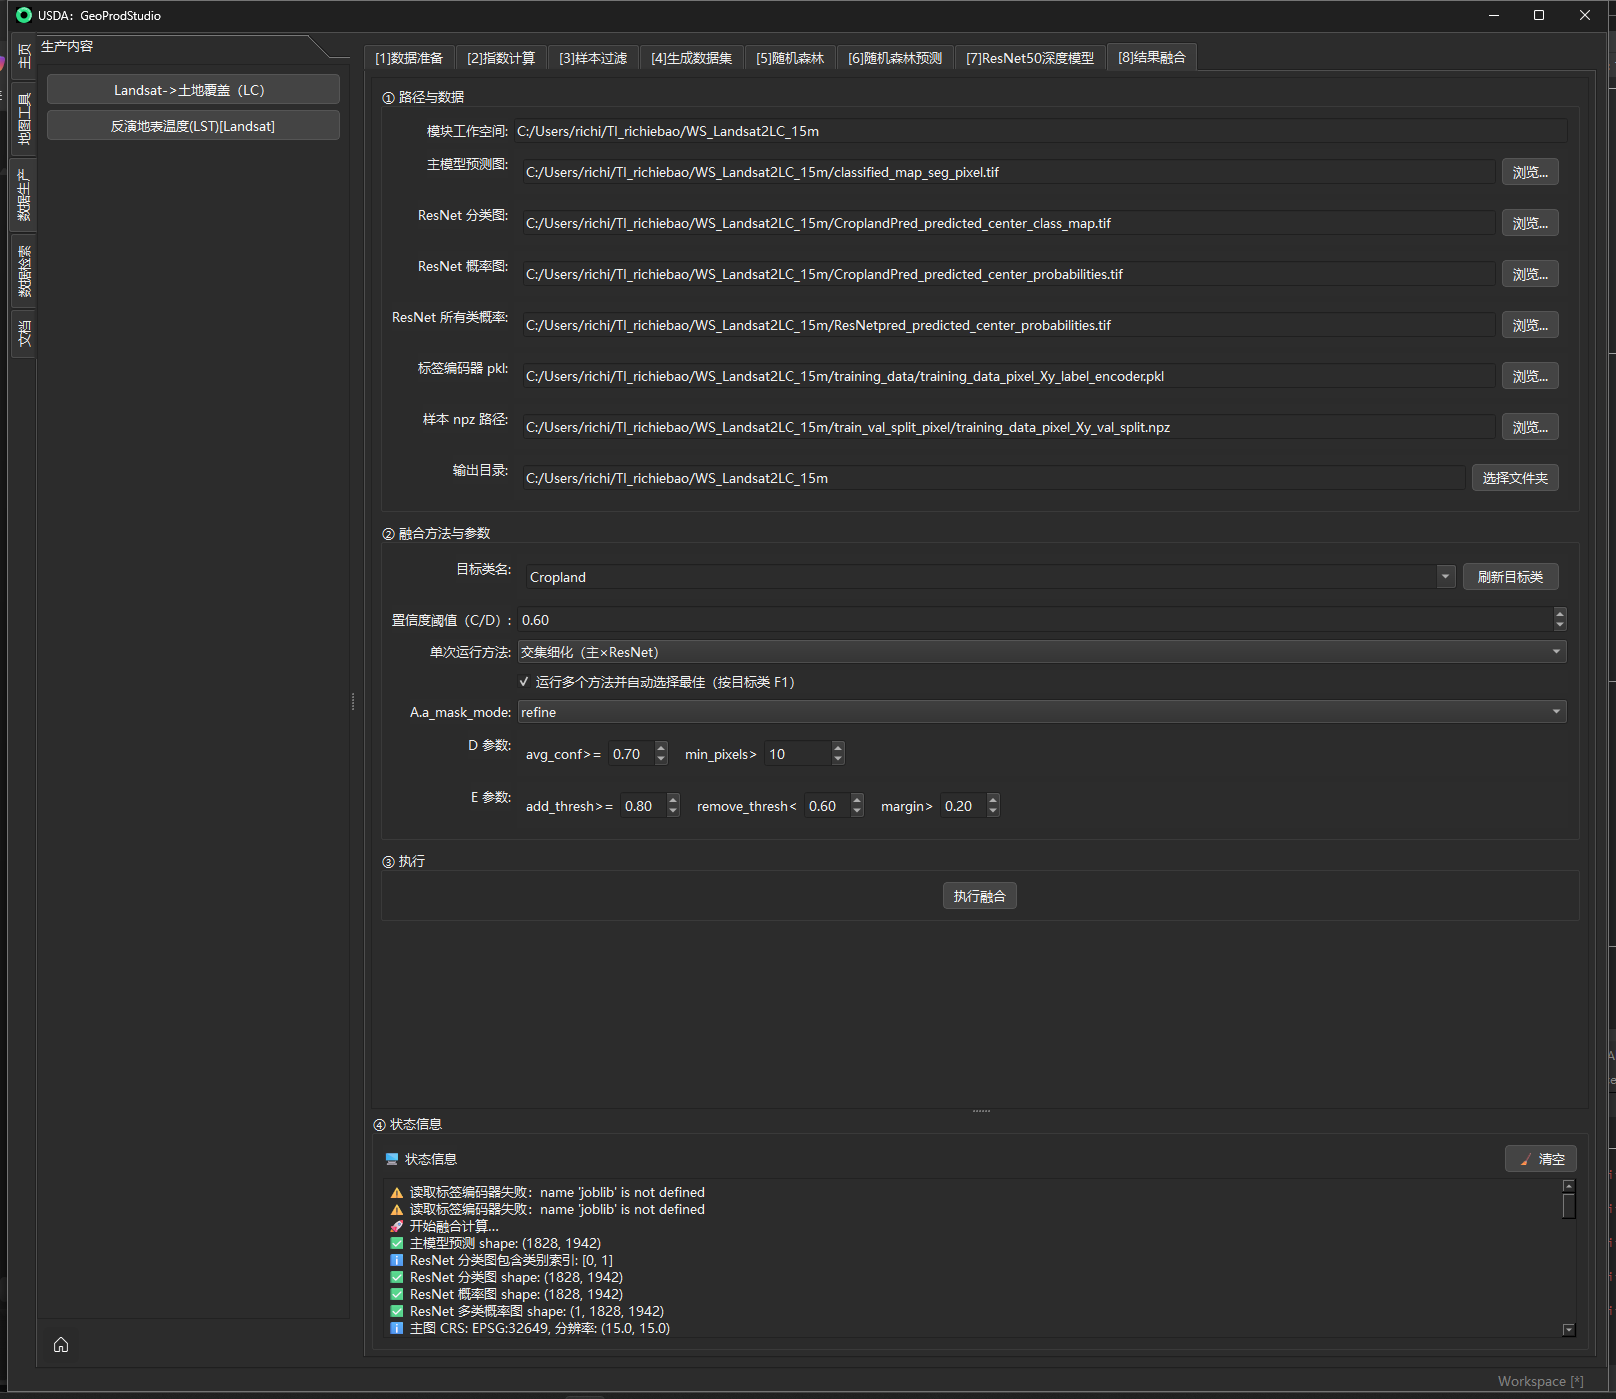
图 5-10 多模型结果融合与最终土地覆盖产品形成
5.5 Landsat 地表温度(LST)
LST 模块面向 Landsat 8/9 Collection 2 Level-2 的 ST_B10 产品,为课题中的热环境响应、降温服务和蓝绿空间热韧性分析提供统一响应层。主计算路径读取 ST_B10 数字量化值,按官方比例因子和偏移恢复开尔文温度,再换算为摄氏度;QA_PIXEL 位用于剔除填充值、膨胀云、卷云、云、云影和雪。实现对 230—360 K 的物理合理区间进行有效值约束,并把温度产品写为 float32 GeoTIFF。NDVI 及发射率估计在当前实现中用于质量诊断/约束,不改变 Level-2 ST_B10 的官方缩放主公式。
LSTK = DN(ST_B10) × 0.00341802 + 149.0;
LST℃ = LSTK − 273.15
invalid = bit₀ ∨ bit₁ ∨ bit₂ ∨ bit₃ ∨ bit₄ ∨ bit₅
式中,DN(ST_B10) 为 Landsat Collection 2 Level-2 地表温度波段 ST_B10 存储的整数量化值,LSTK 为开尔文温度,LST℃ 为摄氏温度,0.00341802 和 149.0 分别为该产品的比例因子和偏移量;bitⱼ 为 QA_PIXEL 第 j 位的布尔标志,∨ 表示逻辑“或”,invalid 为无效像元标志。QA_PIXEL 的第 0—5 位依次对应 Fill、Dilated Cloud、Cirrus、Cloud、Cloud Shadow 和 Snow,只要其中任一位为 1,该像元即进入无效掩膜。输出元数据记录有效像元比例、温度范围和 QA 来源。
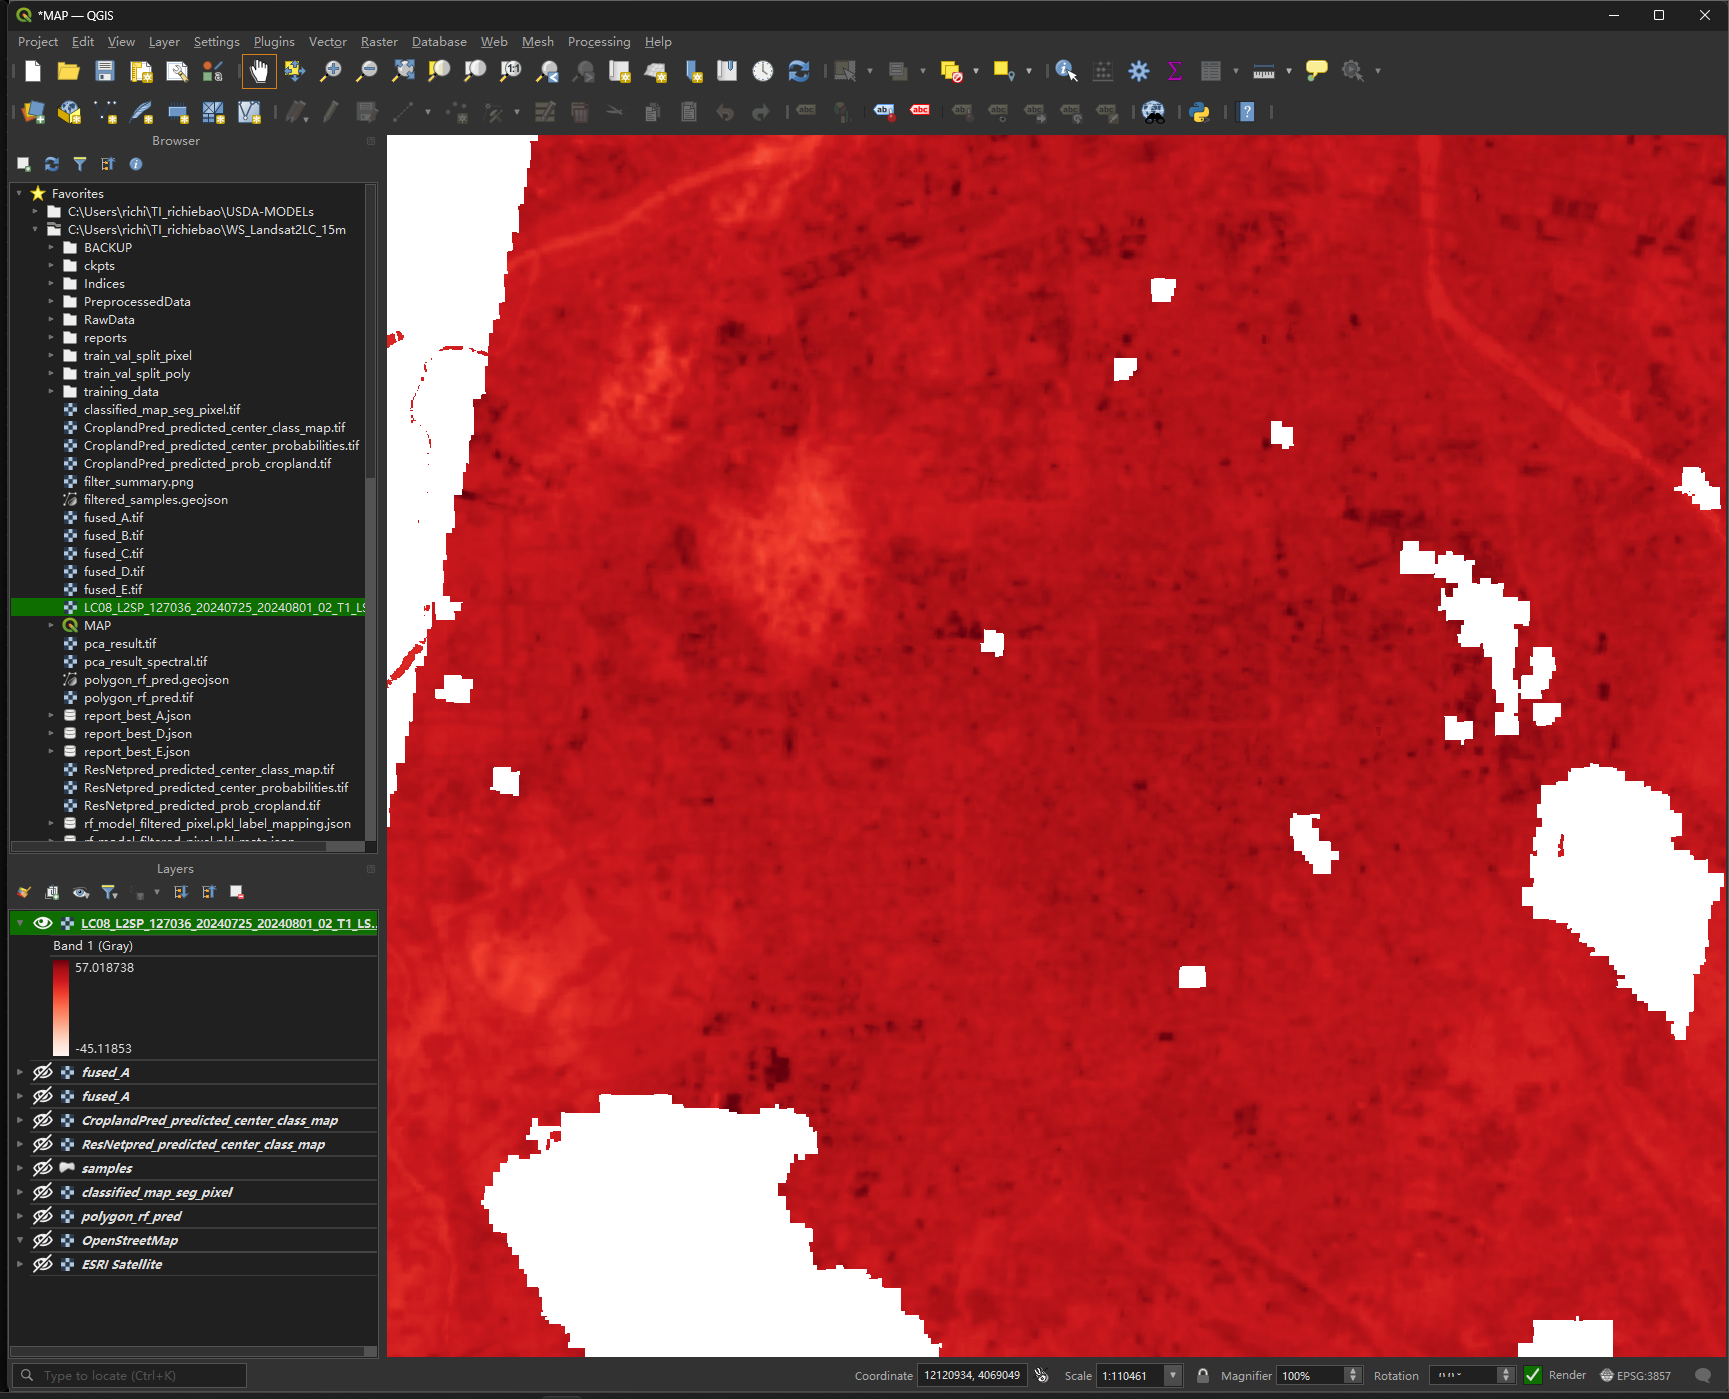
图 5-11 Landsat 8/9 Level-2 地表温度生产示例
5.6 Landsat 实际蒸散发估算(ETa)
ETa 模块采用简化表面能量平衡思想和场景冷热端温度指数,为蓝绿空间水热过程与服务协同分析提供相对响应层。处理器定标 Landsat Collection 2 反射率和温度并计算 NDVI、MNDWI、NDBI;以高植被、非水体候选的低温第 5 百分位为冷端 Tc,以低植被、非水体且具有建设/裸地倾向候选的高温第 95 百分位为热端 Th;地表温度 Ts 在 Tc—Th 间线性映射为 ETf 并截断至 0—1。该实现不求解完整能量平衡各通量,也不同于逐像元、逐日动态 dT、气温校正冷端和标准参考蒸散发驱动的完整 SSEBop 产品,故界定为“基于场景冷热端的实际蒸散发估算”,不作为未经独立验证的高精度绝对耗水量。
ETf = clip[(Th − Ts)/(Th − Tc), 0, 1]; ETa = ETf × ETo
式中,Tc 和 Th 分别为场景冷端与热端地表温度,Ts 为待估像元的地表温度,三者必须采用相同温度单位;clip(u,0,1) 表示把 u 截断到 [0,1] 区间,且计算要求 Th≠Tc;ETf 为蒸散发分数,ETo 为本次任务采用的参考蒸散发输入,ETa 为实际蒸散发估算值,其时间尺度和单位随 ETo 保持一致。
当前按 ETa=ETf×ETo 输出日尺度估算值;8 日单位为日值乘 8 的近似外推。ETo 可取人工输入、季节默认值或 GLDAS 查询结果,其中在线路径依据气温和风速经验估算,并非完整的 FAO-56 Penman—Monteith 计算;公式也不另设 kmax 系数,故须记录 ETo 定义、来源和日期。Tc、Th、ETo、时段、有效像元比例及输入来源写入元数据;城市异质表面仍会影响场景端元代表性。该层适用于同一场景的高低蒸散格局、蓝绿/非蓝绿空间差异及结构—响应分析;用于绝对量、跨季节/跨城市比较、水量平衡或耗水核算时,应采用同日标准参考蒸散发,并以通量塔、蒸渗仪、水量平衡或权威 ET 产品独立校准和评价误差。
分割采样与训练样本体系
6.1 A—E 五阶段工作流
分割采样是建立本地化、可变土地覆盖类别体系的入口,也是从影像到样本的自动化生产链。流程把样本制作分为 A 输入、B 特征、C 分割、D 区划和 E 采样:A 阶段确定城市研究区、工作空间、影像路径和波段映射;B 阶段选择原始波段、光谱指数、标准化和 PCA 等特征;C 阶段执行 SLIC/SLICO、Felzenszwalb、Quickshift、Watershed 或 MeanShift;D 阶段将分割对象矢量化并叠加梯度分区、行政区或规划单元;E 阶段在地图上选择对象、按课题类别体系赋值并保存样本。阶段化文件、对象唯一标识、参数配置和实时/确认样本文件使特征空间、对象边界、分区覆盖和人工判读均可复核,既提高 Landsat 解译与样本制作效率,也保证同一流程可按相同输入和参数重复执行。
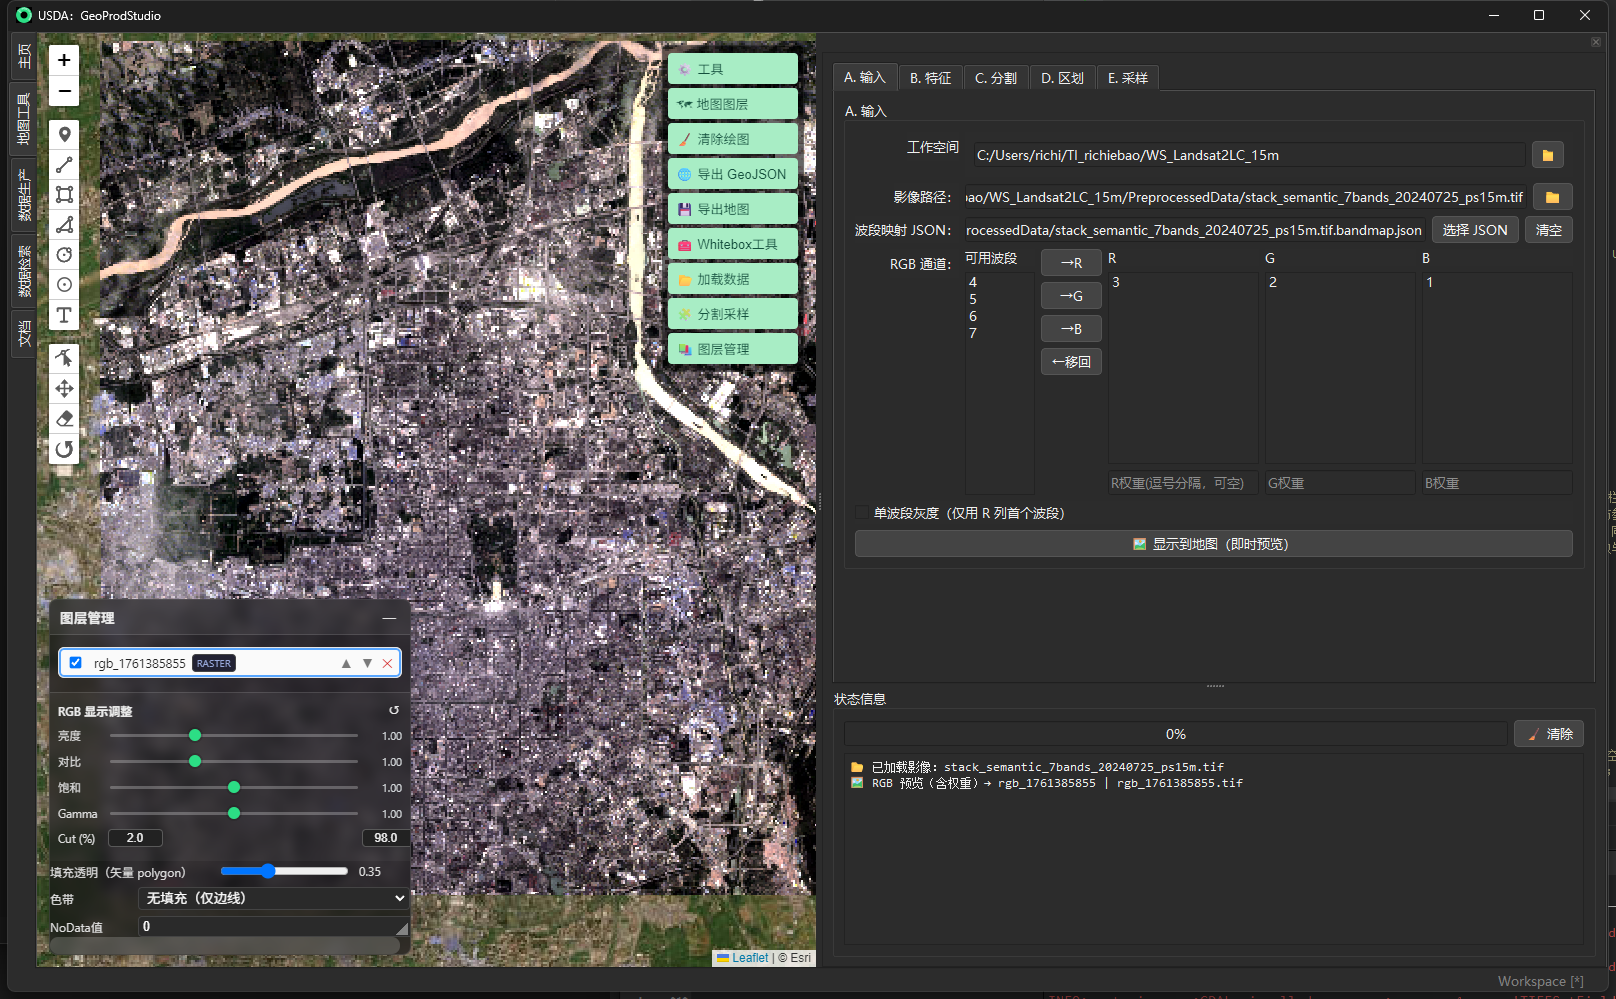
图 6-1 分割采样输入与工作空间配置
6.2 特征空间与对象分割
对象分割在所选特征空间而非单一显示图像上计算。特征可包含原始波段及 NDVI、EVI、SAVI、MNDWI、NDBI 等指数;标准化避免量纲较大的变量支配距离;PCA 可在保留主要方差的同时压缩冗余维度。SLIC 将颜色/特征距离与空间距离联合最小化,compactness 控制对象规则性;Felzenszwalb 基于图边权差异合并区域;Quickshift 采用核密度模式寻优;Watershed 由梯度/标记形成集水盆地;MeanShift 在联合特征空间搜索密度峰。
D = √[d_f² + (m/S)² d_s²]
式中,D 为 SLIC 聚类使用的综合距离,d_f 为标准化特征空间距离,d_s 为空间坐标距离,S 为超像素中心的期望间距,m 为控制空间规整程度的紧致度参数;m/S 用于平衡特征相似性与空间邻近性。不同算法的参数语义在界面注册表和附录 B 中分别给出。
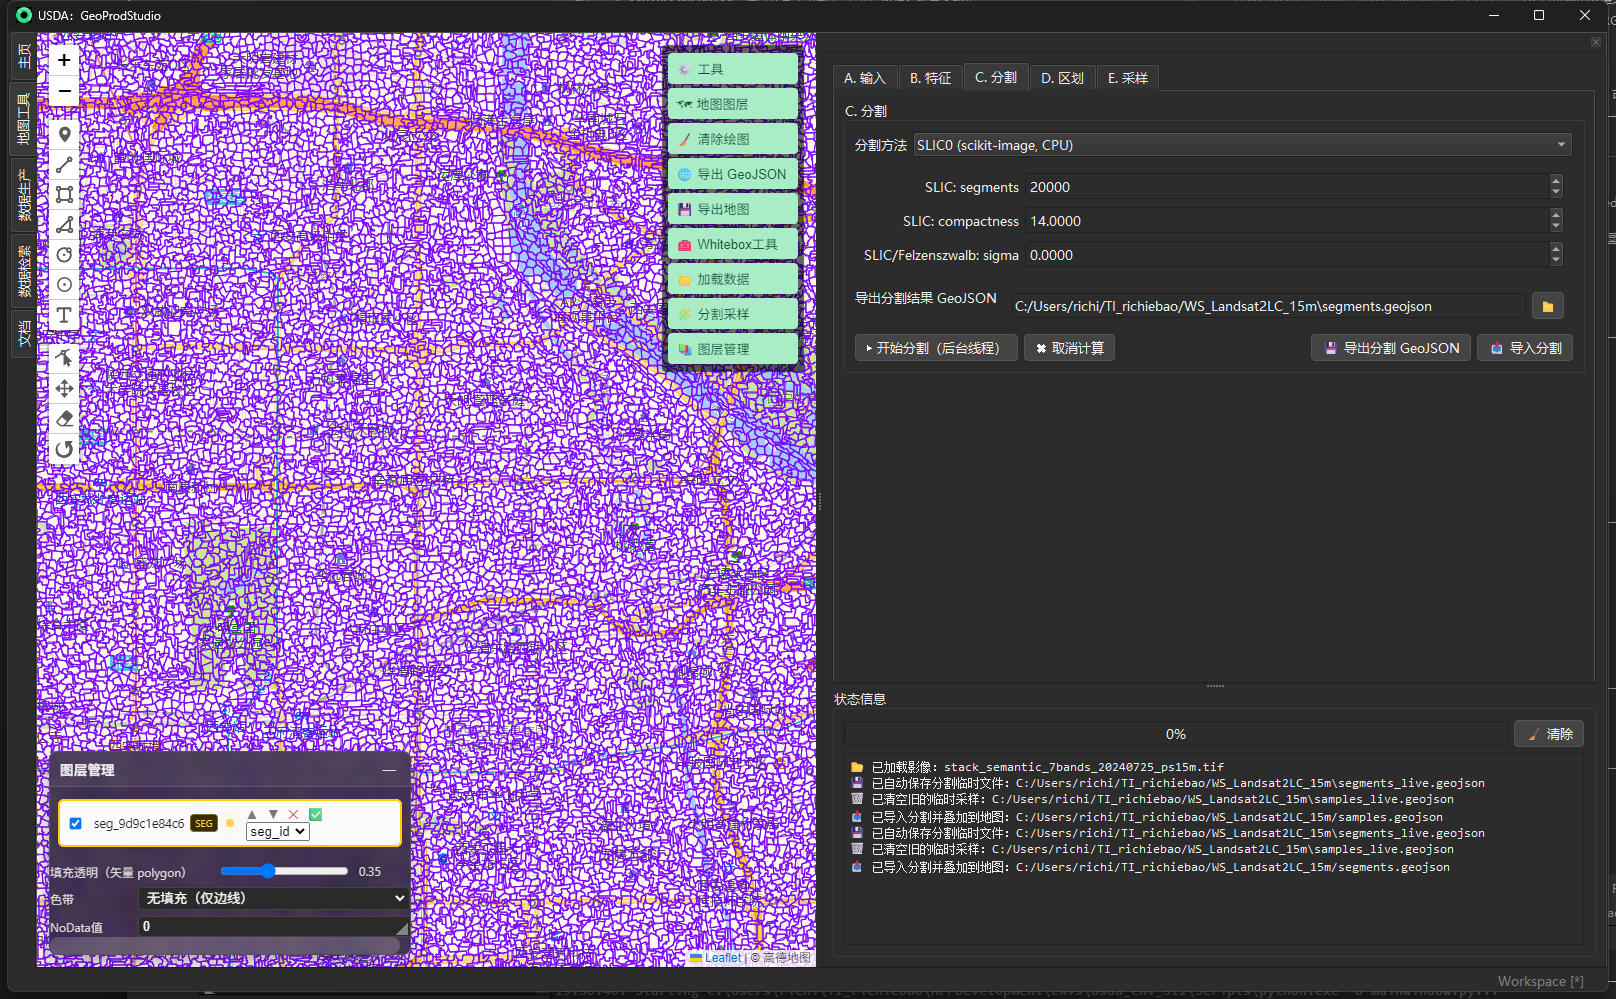
图 6-2 分割算法、参数与结果生成
6.3 对象模型、交互选择与样本输出
分割结果为每个像元分配 segment_id,并矢量化为带唯一标识和属性的对象。引擎维护 segment_id 到图层的映射,使点击选择、取消和类别更新无需遍历全部对象;编辑状态采用脏标记和定时保存机制,实时结果先写 samples_live.geojson,确认后形成 samples.geojson。分割对象、区划结果与样本文件分别保存,因而同一城市对象层可以按不同蓝绿空间分类体系、不同研究时相或不同服务问题重用,类别变化不会迫使底层对象重新生成。
| 阶段 | 输入 | 输出 | 核验重点 |
|---|---|---|---|
| A 输入 | 影像、工作空间、波段映射 | 任务上下文 | 路径、CRS、波段语义 |
| B 特征 | 波段与指数配置 | 分割特征栈 | 有效掩膜、标准化、PCA |
| C 分割 | 特征栈与算法参数 | segment_id 栅格/对象 | 对象大小、边界与过/欠分割 |
| D 区划 | 对象与区划约束 | 分区对象层 | 拓扑、属性与空间覆盖 |
| E 采样 | 对象、类别与交互选择 | samples_live / samples.geojson | 唯一标识、类别完整性与保存状态 |
表 6-1 分割采样阶段的输入输出与核验点
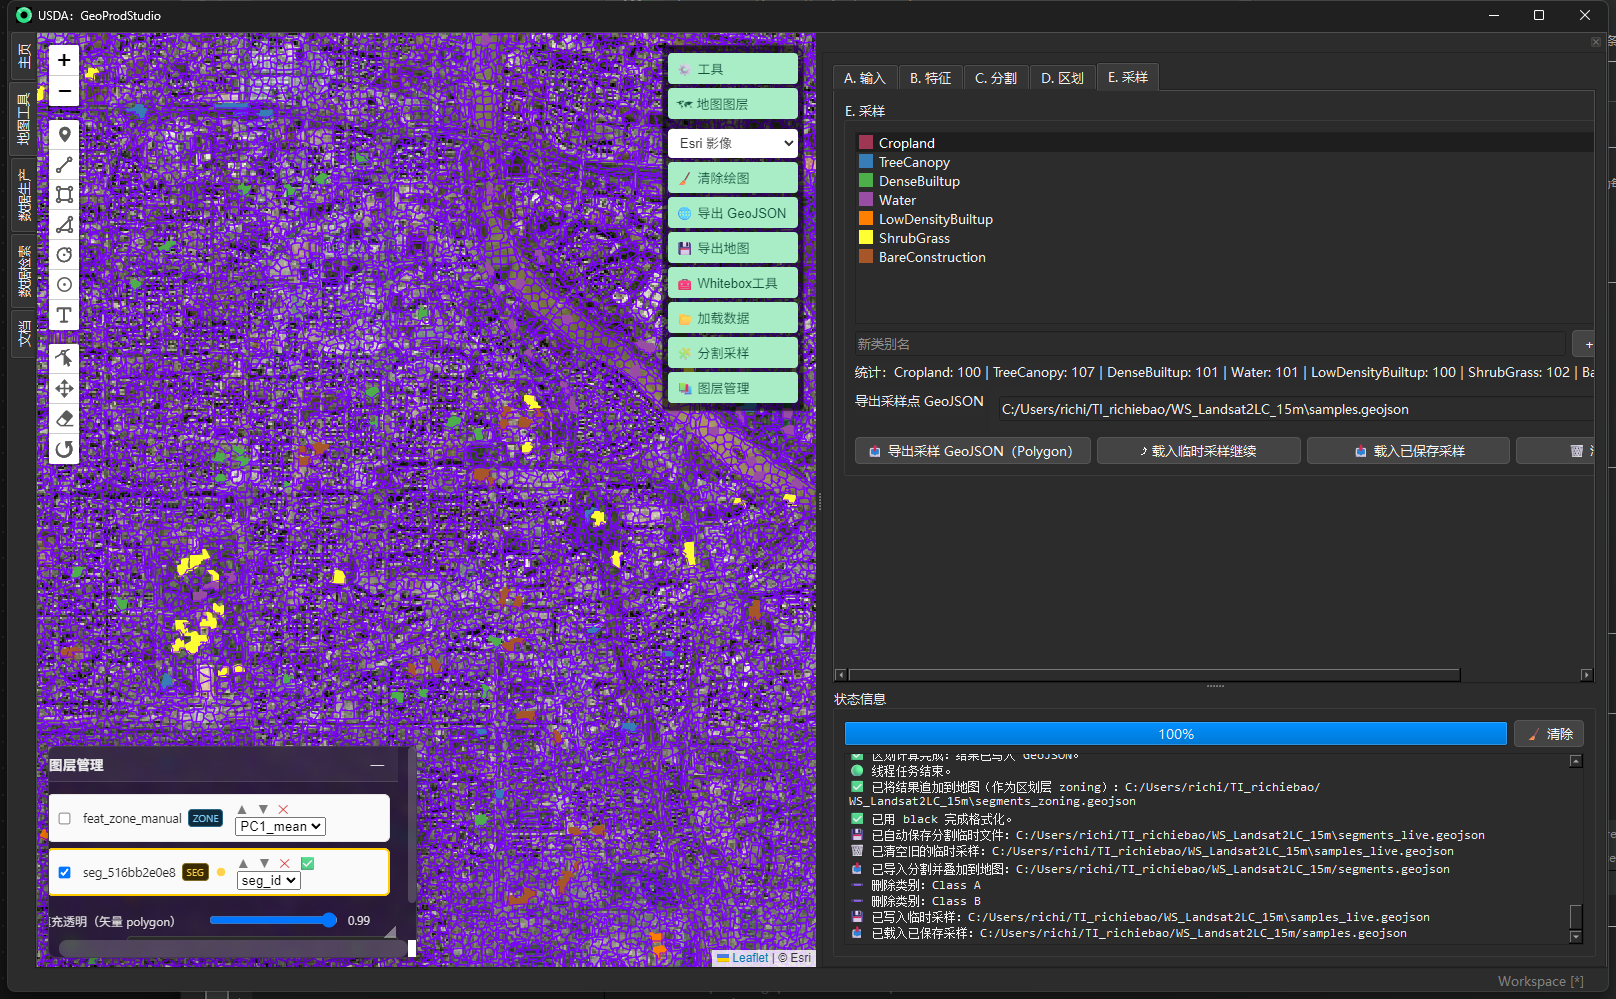
图 6-3 对象级交互采样、类别赋值与样本保存
空间结构—响应与尺度分析
7.1 公共建模数据集与阶段化流程
空间结构关系分析分为数据与对齐、结构/响应特征尺度轴、控制变量/多目标分析和贝叶斯网络分析。正式阶段链为 A-0 公共空间基准、A 主结构及控制特征、B 响应特征、C 按位置对齐的统一样本、D 关系/多变量/多目标及空间输出、E 尺度诊断。A、B、C 及其 schema、positions 构成可核验输入;D 记录方法身份、样本与验证状态;E 仅对可比较的固定对象序列进行诊断。
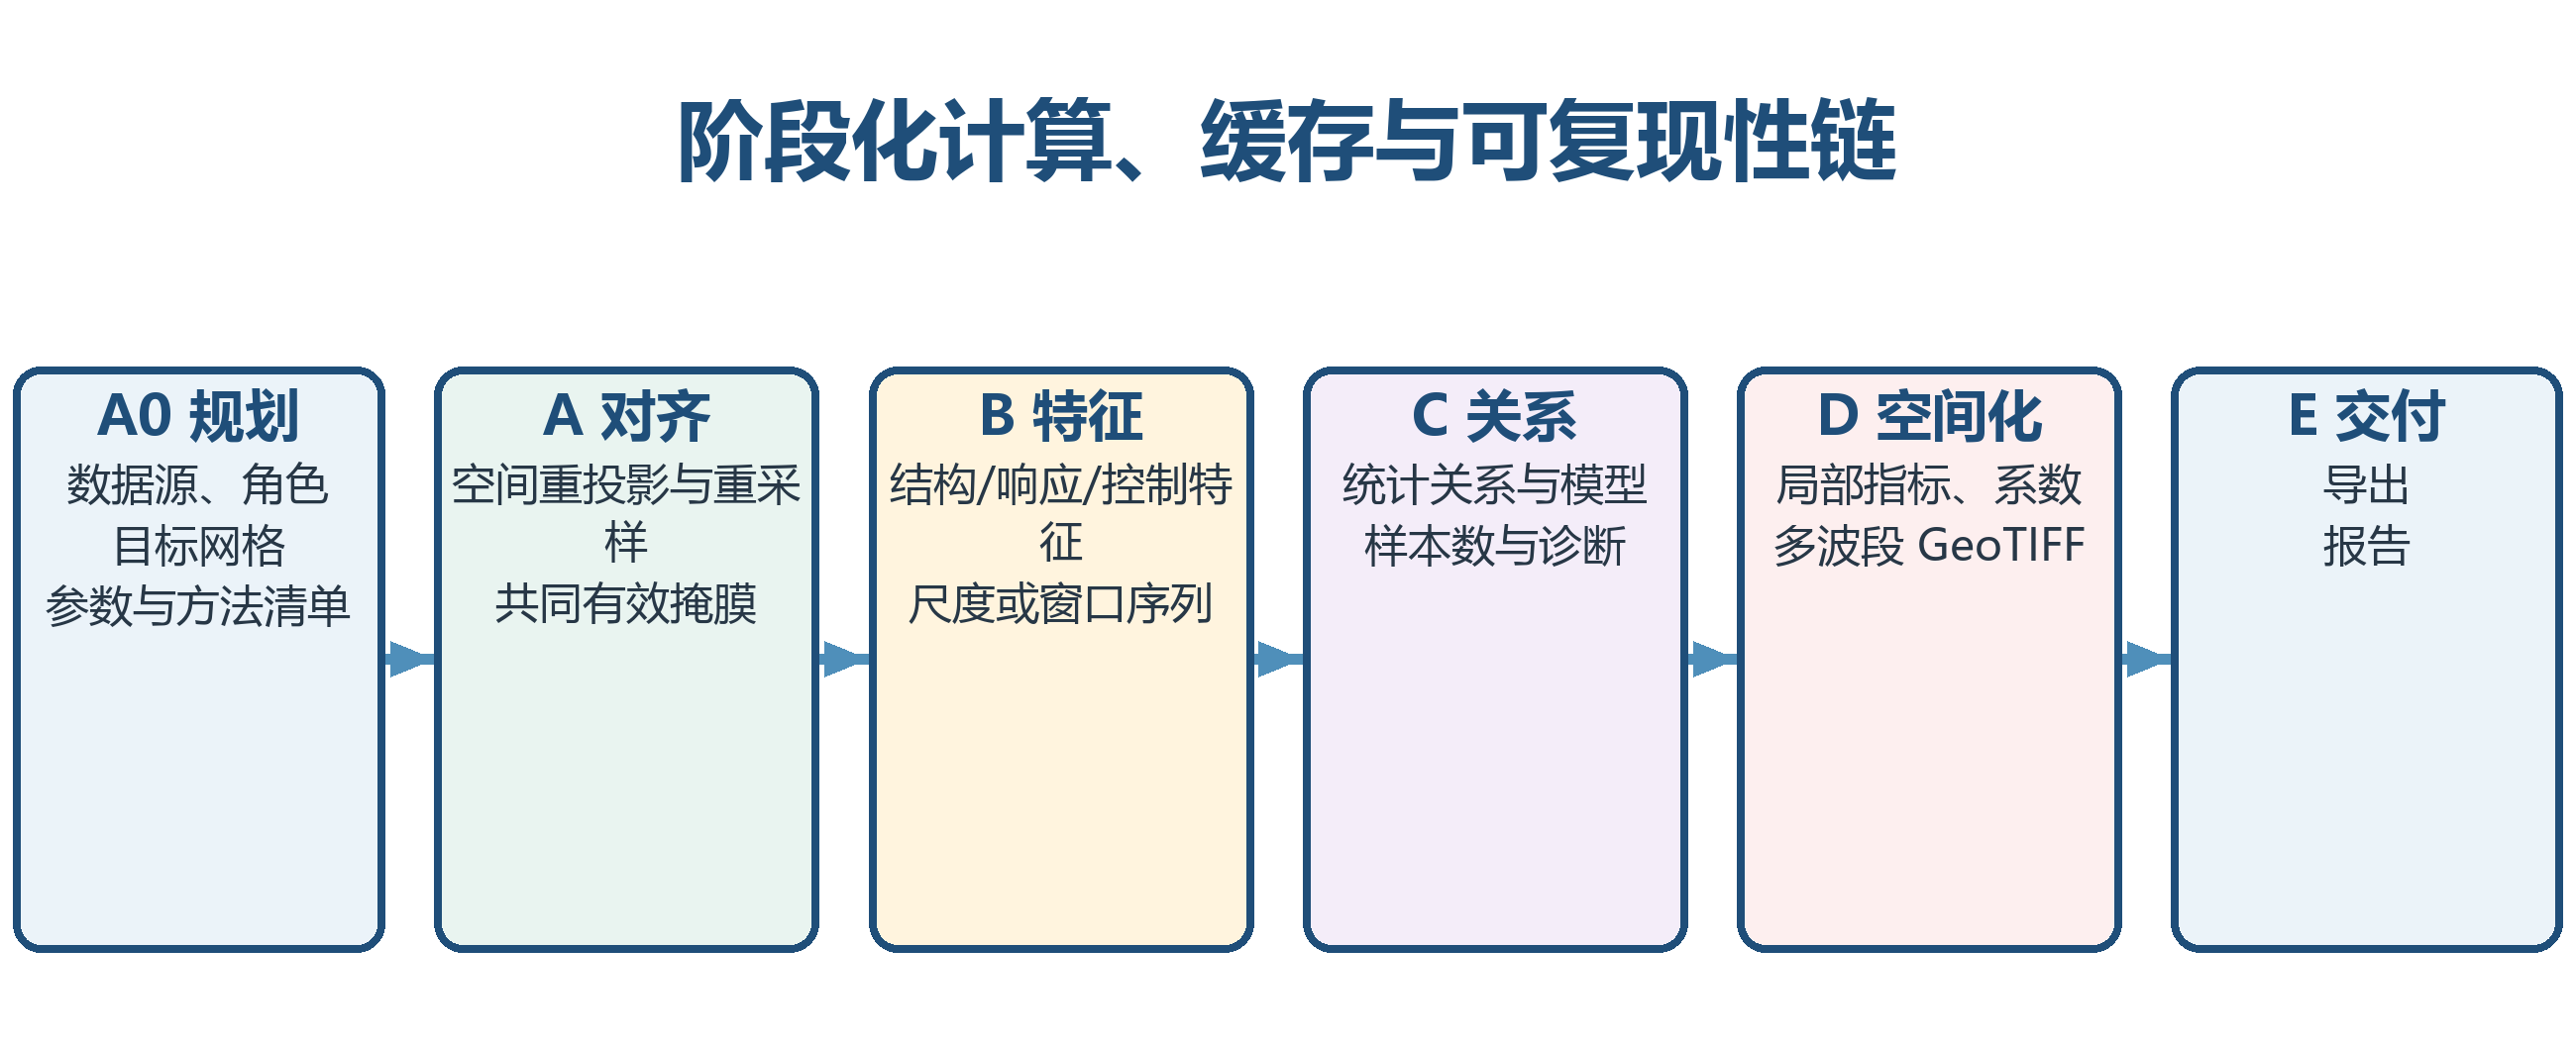
图 7-1 空间结构分析的阶段化处理与成果追踪
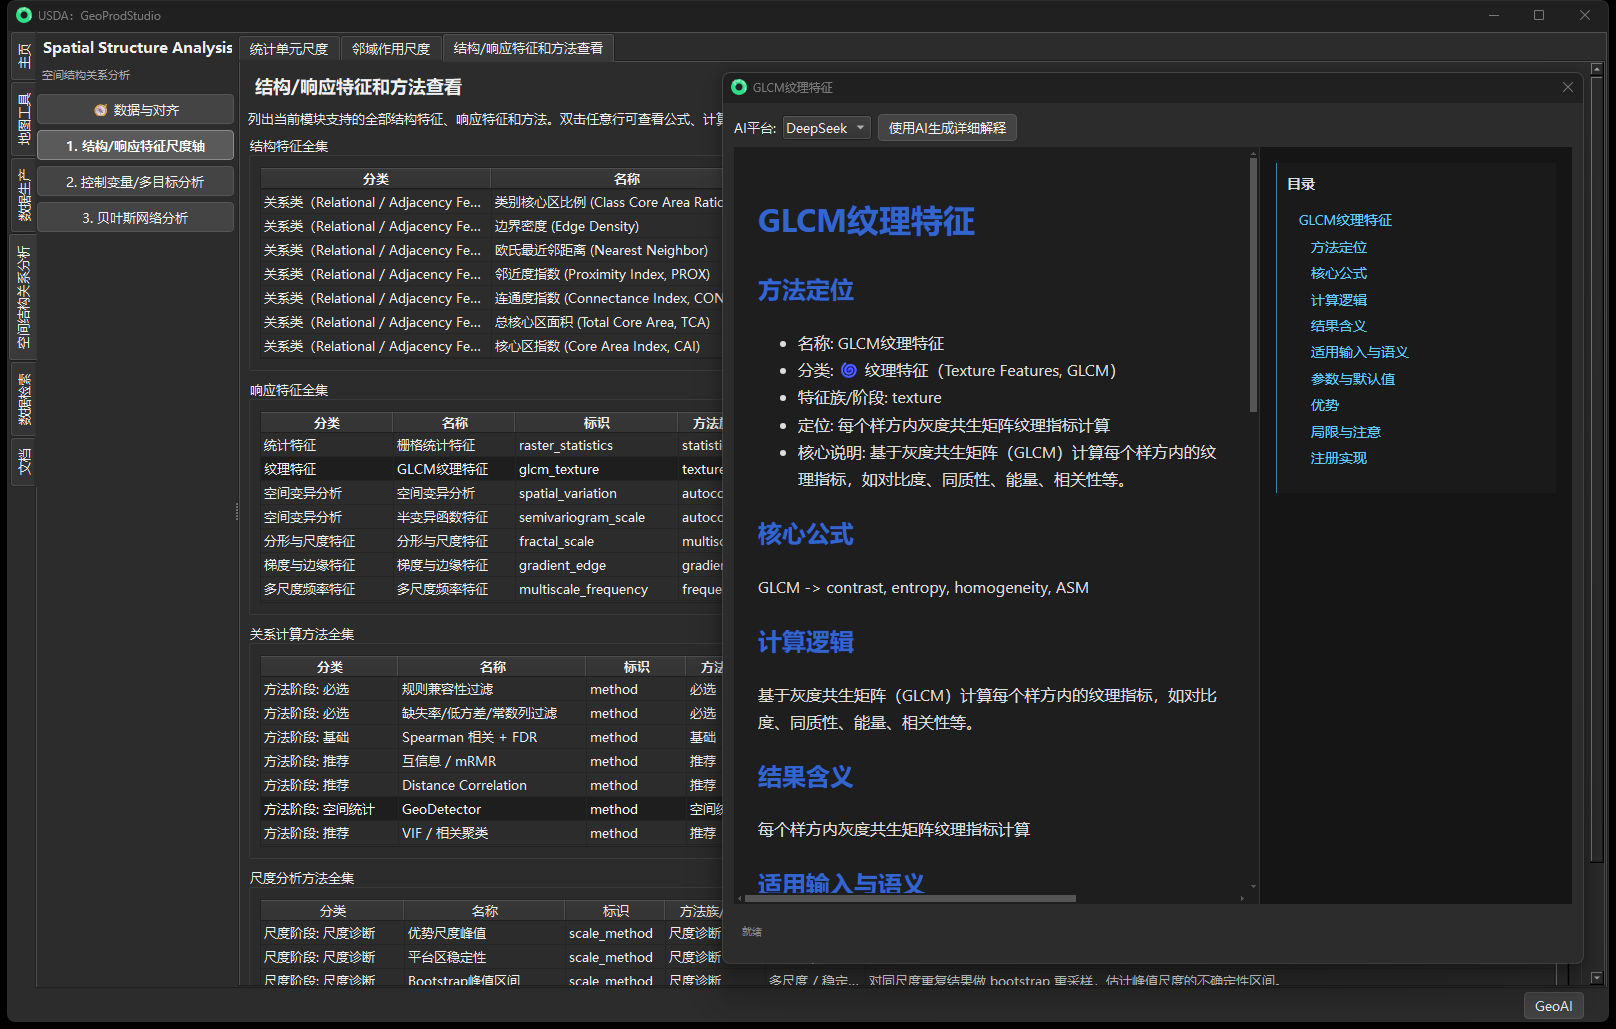
图 7-2 结构特征、响应特征与关系方法的统一配置
7.2 统计单元尺度与邻域作用尺度
统计单元尺度在同一样方内汇总 X、C、Y,改变边长会同时改变支持域与样本量,用于考察聚合尺度及 MAUP。邻域作用尺度保持中心响应支持域,改变周边结构与控制窗口,描述中心响应与周边格局的关联范围。二者独立保存模式、尺度与样本条件。窗口边长以实际公共单元分辨率换算:30 m 网格的 3×3—13×13 为 90—390 m,60 m 网格才为 180—780 m。统计或邻域尺度不直接确定公园面积、廊道宽度、缓冲带宽度或实施节点间距。
b(s) = round(s/r₀)(整数倍序列)
Qᵢ(s) 按实际物理边界构建;连续尺度采用该边界内的原始像元提取与独立局部分辨率记录。
N(s) = floor[Hphys/s] × floor[Wphys/s](规则完整样方的几何上限;有效样本另计)
Nw(i) = {j : |rowⱼ−rowᵢ|≤(w−1)/2, |colⱼ−colᵢ|≤(w−1)/2}
s 为样方物理边长,r₀ 为公共网格分辨率。整数倍模式的实际边长为 b(s)r₀;任意连续尺度按真实物理样方计算,ceil(s/r₀) 仅可用于读取覆盖范围,不能替代实际样方边界。Hphys、Wphys 为公共支持域的物理高和宽。Nw(i) 定义奇数邻域;边界和 NoData 按有效规则处理。150 m 样方在 30 m 公共网格内含 25 个 cell,该数是单样方的空间支持量,不是跨样方建模的总样本数,原始 15 m 分类像元数也须与公共网格区分。
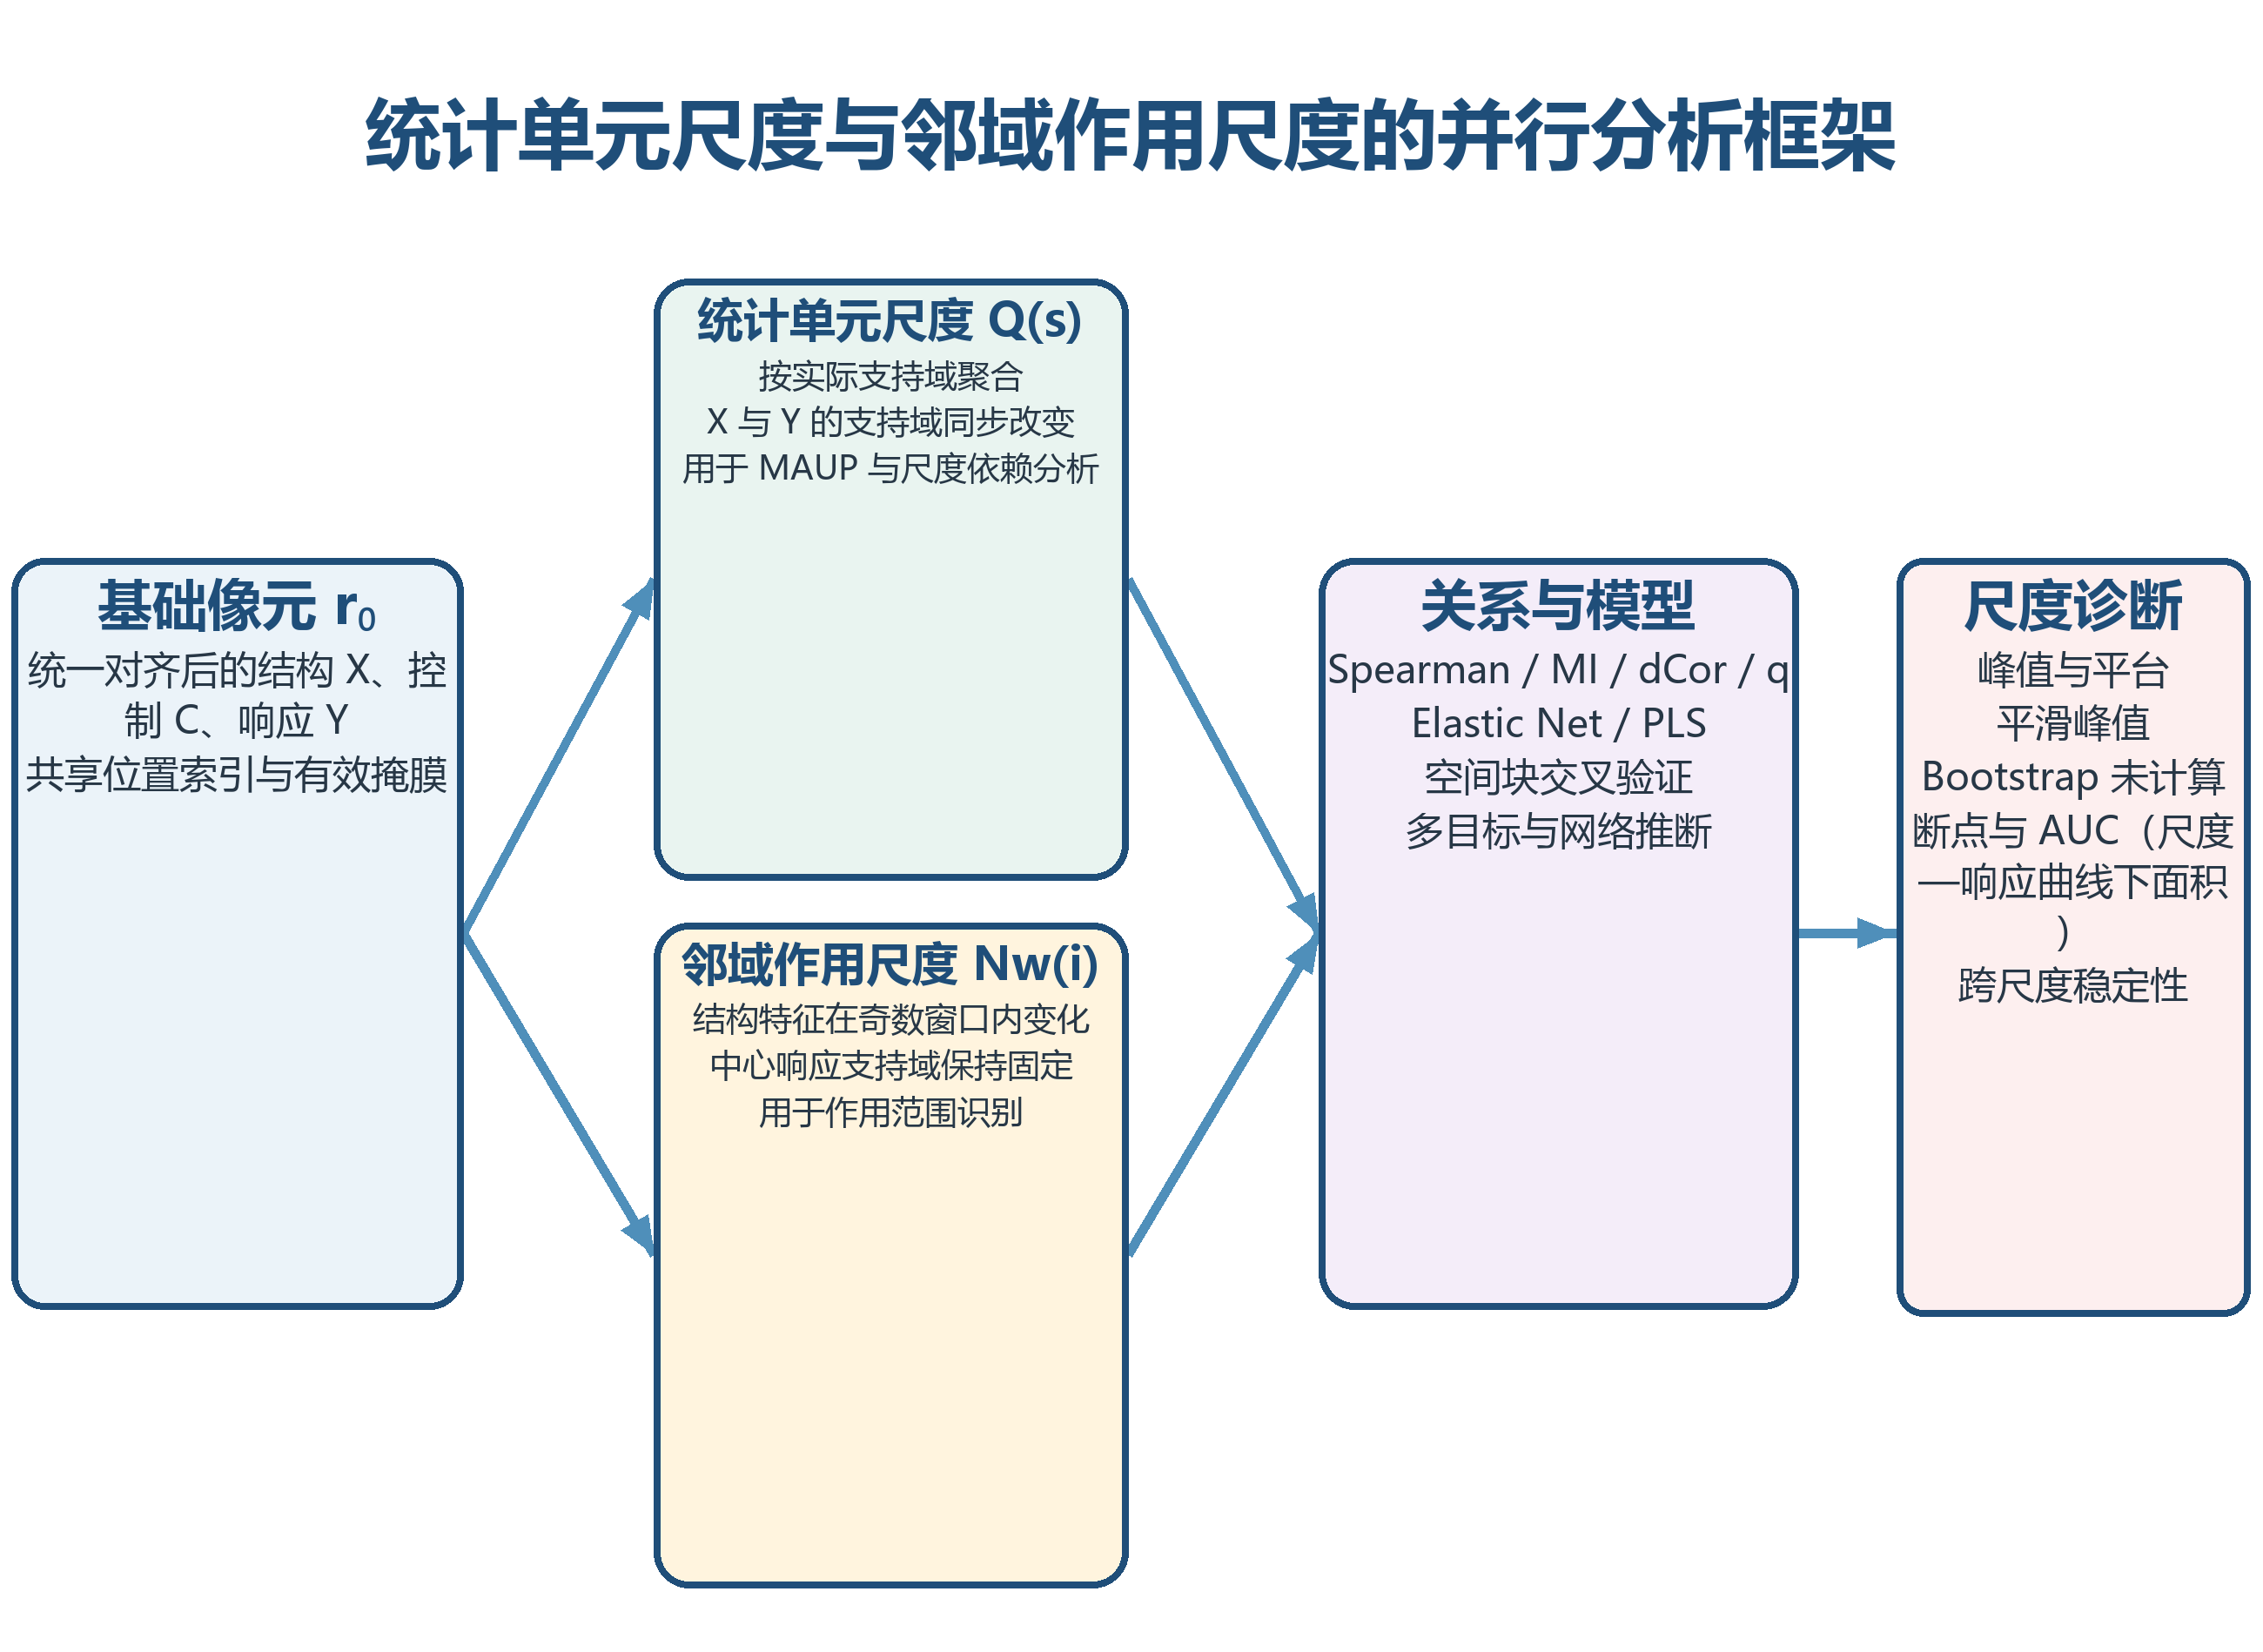
图 7-3 双尺度轴的支持域差异与共同诊断框架
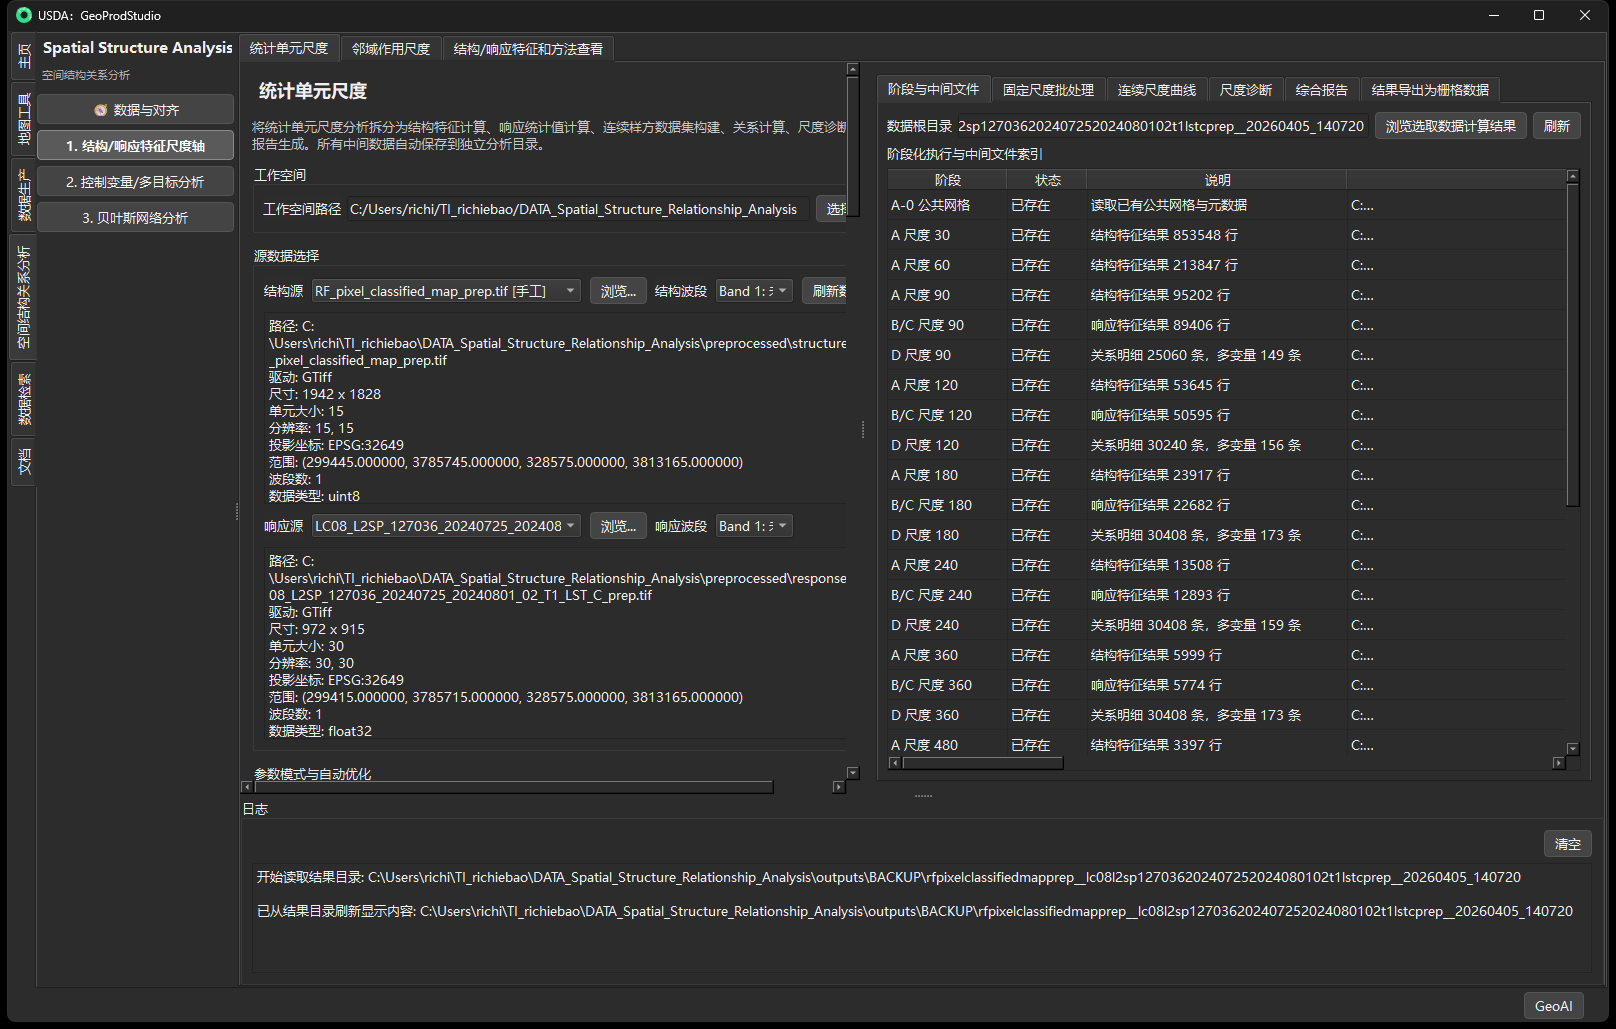
图 7-4 统计单元尺度序列及样方构建
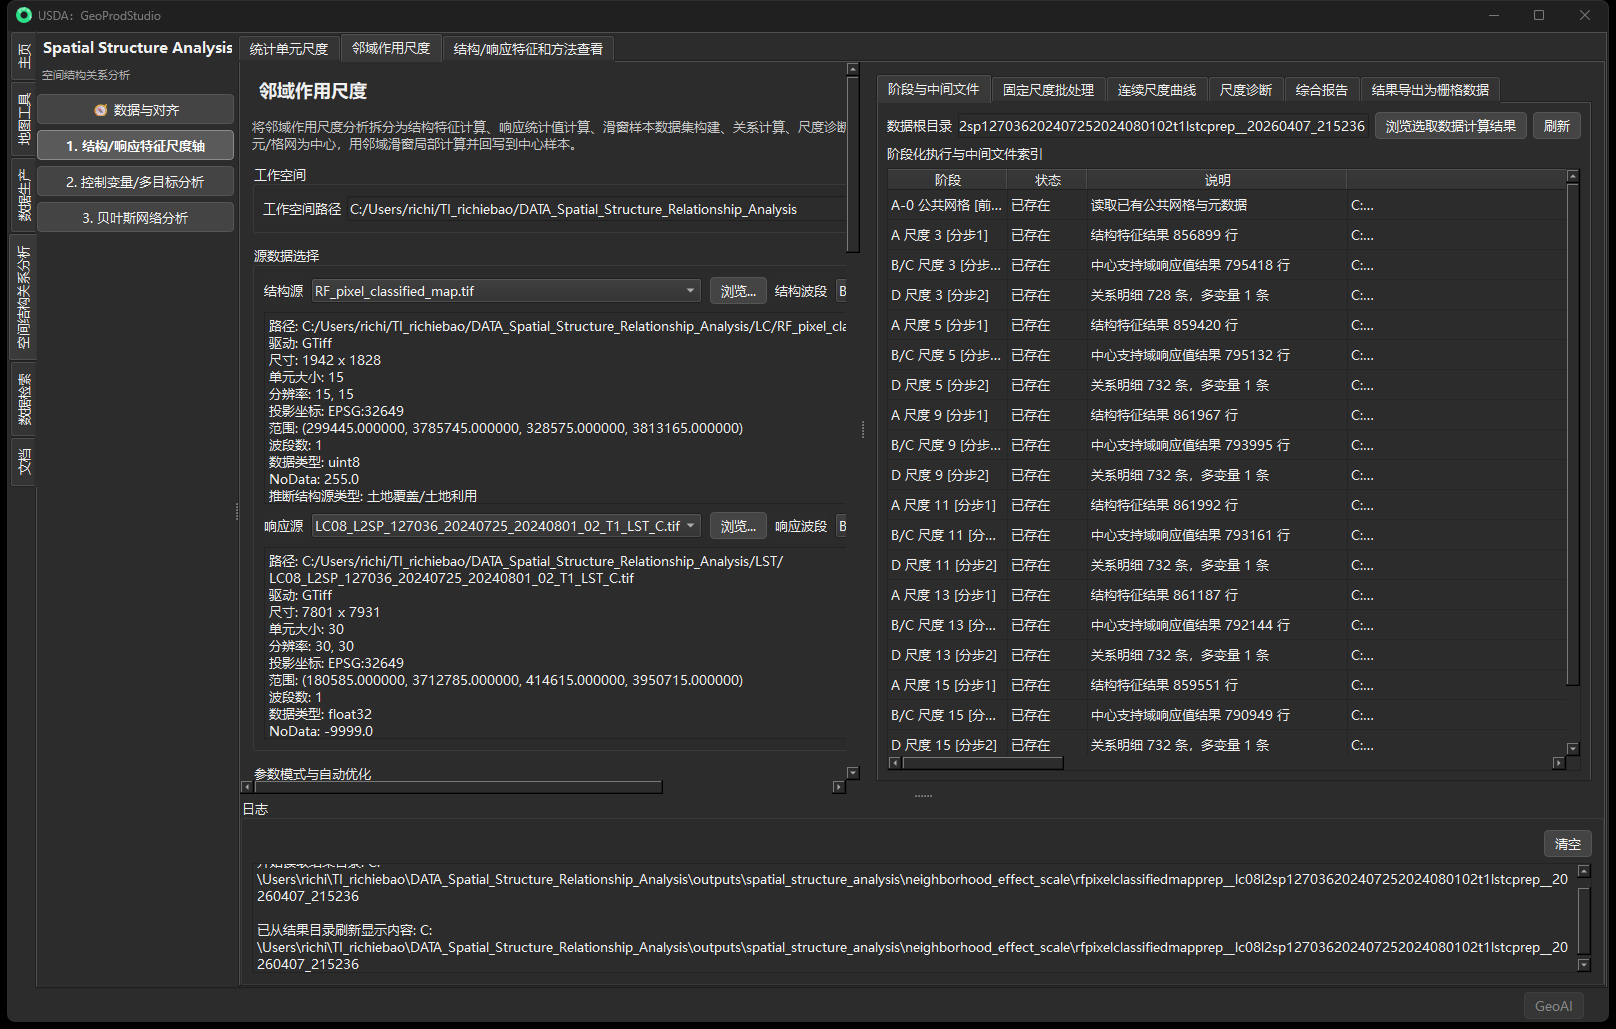
图 7-5 邻域作用窗口及中心响应支持域
7.3 结构与响应特征
特征覆盖组成、多样性、斑块、破碎化、聚集、边界、连接和核心区;响应展开包括统计、纹理、梯度、频率与半变异。V3.5.0 对 11 项标准景观指标使用 PyLandStats:平均斑块面积、斑块面积变异系数、斑块密度、最大斑块指数、有效网格面积、景观形状、Shannon 多样性、边缘密度、蔓延度、镶嵌毗邻和最近邻距离。其余指标按 USDA 明确口径计算并保存定义。类别由输入元数据确定;有效类别未出现时类别占比为 0,无有效支持和未定义的格局指标保留缺失,不能统一填为 0 或中位数。
H = −Σc pc ln(pc);PD = Np/Aha;LPI = 100·max(aⱼ)/A;MESH = Σⱼ aⱼ²/A
p_c 为类别面积份额;Aha 为有效面积(ha),PD 单位为斑块数/ha。斑块平均面积及 MESH 输出 m²,边缘密度为 m/ha,最近邻为 m;计算需统一面积单位。clump_size 对应平均斑块面积,不是完整大小直方图。connectivity=1/2 对应四/八连通。核心区按 USDA 欧氏像元中心到类别边界距离及外边界策略计算,NoData 孔洞参与边界处理,不宣称与所有 FRAGSTATS 指标完全等价。类别 0 是否有效取决于当前输入定义。
| 特征维度 | 主要指标/对象 | 课题解释 |
|---|---|---|
| 组成 | 类别比例、多样性、优势度 | 表征蓝绿空间数量与类型组合,是综合效能的基础条件 |
| 破碎化 | 斑块数/密度、分裂度、MESH | 识别同等面积下的离散程度,支撑高效益单元类型比较 |
| 连通与聚集 | 聚集度、连接度、邻近距离、核心区 | 表征生态网络连续性、核心斑块和潜在过程通道 |
| 边缘与邻接 | 边缘密度、类别邻接、中心—边缘对比 | 表征蓝绿空间与建设环境接触及潜在外溢界面 |
| 形状与方向 | 形状指数、分形、方向连通 | 表征边界复杂性、廊道方向和结构配置 |
| 多尺度组织 | 层级分解、半变异、频率与尺度诊断 | 识别结构组织层次及效应发生的关键尺度区间 |
表 7-1 空间结构特征的课题解释与潜在规划含义
7.4 关系方法与空间验证
单变量方法描述统计依赖,回归模型描述预测关系,空间模型描述异质性或空间滞后。距离相关调用 dcor,半变异拟合调用 SciKit-GStat,空间权重与 Moran 使用 libpysal/esda,空间回归使用 mgwr/spreg。Elastic Net、PLS、Ridge 与树模型通过 scikit-learn Pipeline/GridSearchCV 协议执行折内处理和内层空间调参;外层评估汇总最终有效折的 R²。相关的解析 P 值及 FDR 使用独立同分布假设,不能称为空间置换显著性。模型及验证语义不同,不以原始得分混合排名。
q = 1 − [Σh Nh σh²]/(Nσ²)
β̂ = argminβ { ||y−Xβ||₂²/(2n) + λ[(1−α)||β||₂²/2 + α||β||₁] }
式中,在 GeoDetector 公式中,h 为结构变量离散化后的分层索引,N_h 和 σ_h² 分别为第 h 层的样本数与响应变量方差,N 和 σ² 分别为全部有效样本数与总体响应方差,Σ_h 表示对全部分层求和,q 为分层对响应空间分异的解释力。在 Elastic Net 公式中,y 为包含 n 个样本的响应向量,X 为 n×p 的特征矩阵,β 为包含 p 个回归系数的参数向量,β̂ 为使目标函数最小的估计值,argmin 表示取使目标函数达到最小值的参数;||y−Xβ||₂² 为残差平方和,||β||₁ 和 ||β||₂ 分别为 L1 范数和 L2 范数,λ≥0 为正则化强度,α∈[0,1] 为 L1 与 L2 惩罚的混合比例。
模型评分须同时报告响应来源、物理目标身份、单位、指标类型、质量状态、有效折数及样本量。至少 3 个有效验证折才能形成可用于严格尺度比较的评分;恒定响应、无变异测试集或数值异常排除。负 R² 保留负号,近 1 的训练拟合不能证明外推稳定。邻域分析采用至少一个完整窗口边长的训练—测试隔离,用户缓冲可增加该距离;样本不足时报告失败,不退回存在窗口重叠的划分。MGWR/空间 Durbin 的样本内拟合或伪 R² 标为 descriptive_fit,不作为最佳可靠尺度证据。
7.5 尺度诊断
尺度诊断先固定来源、响应、结构对象、方法、指标和目标集合,并审查逐点质量,避免不同尺度切换代表性高分对象。峰值为合格序列中的候选统计峰值;平台为峰值邻近的连续近峰区间,不证明统计稳定性。三点平滑和有符号 AUC 描述曲线,负 R² 不取绝对值。ruptures 的分段线性候选按真实尺度横轴拟合,含复杂度惩罚并与未分段模型比较,常数或线性曲线不强制产生转折。当前未开展空间重抽样 Bootstrap 峰值区间与独立尺度一致性检验,明确标为未计算;无有效序列不等于目录没有文件。
z̃k = 0.25zk−1 + 0.50zk + 0.25zk+1;平台取峰值周围满足近峰容差的连续尺度区段。
z̃_k 使用相邻尺度的三点加权平滑。平台依据方法的合法得分和峰值容差,在峰值周围取连续区间;孤立峰值、端点峰值、稀疏尺度或样本减少均需说明。AUC 必须保留得分符号和尺度单位。不同方法的峰值一致只是交叉方法描述,不能替代独立验证;未计算的 Bootstrap 不以零宽区间代替。
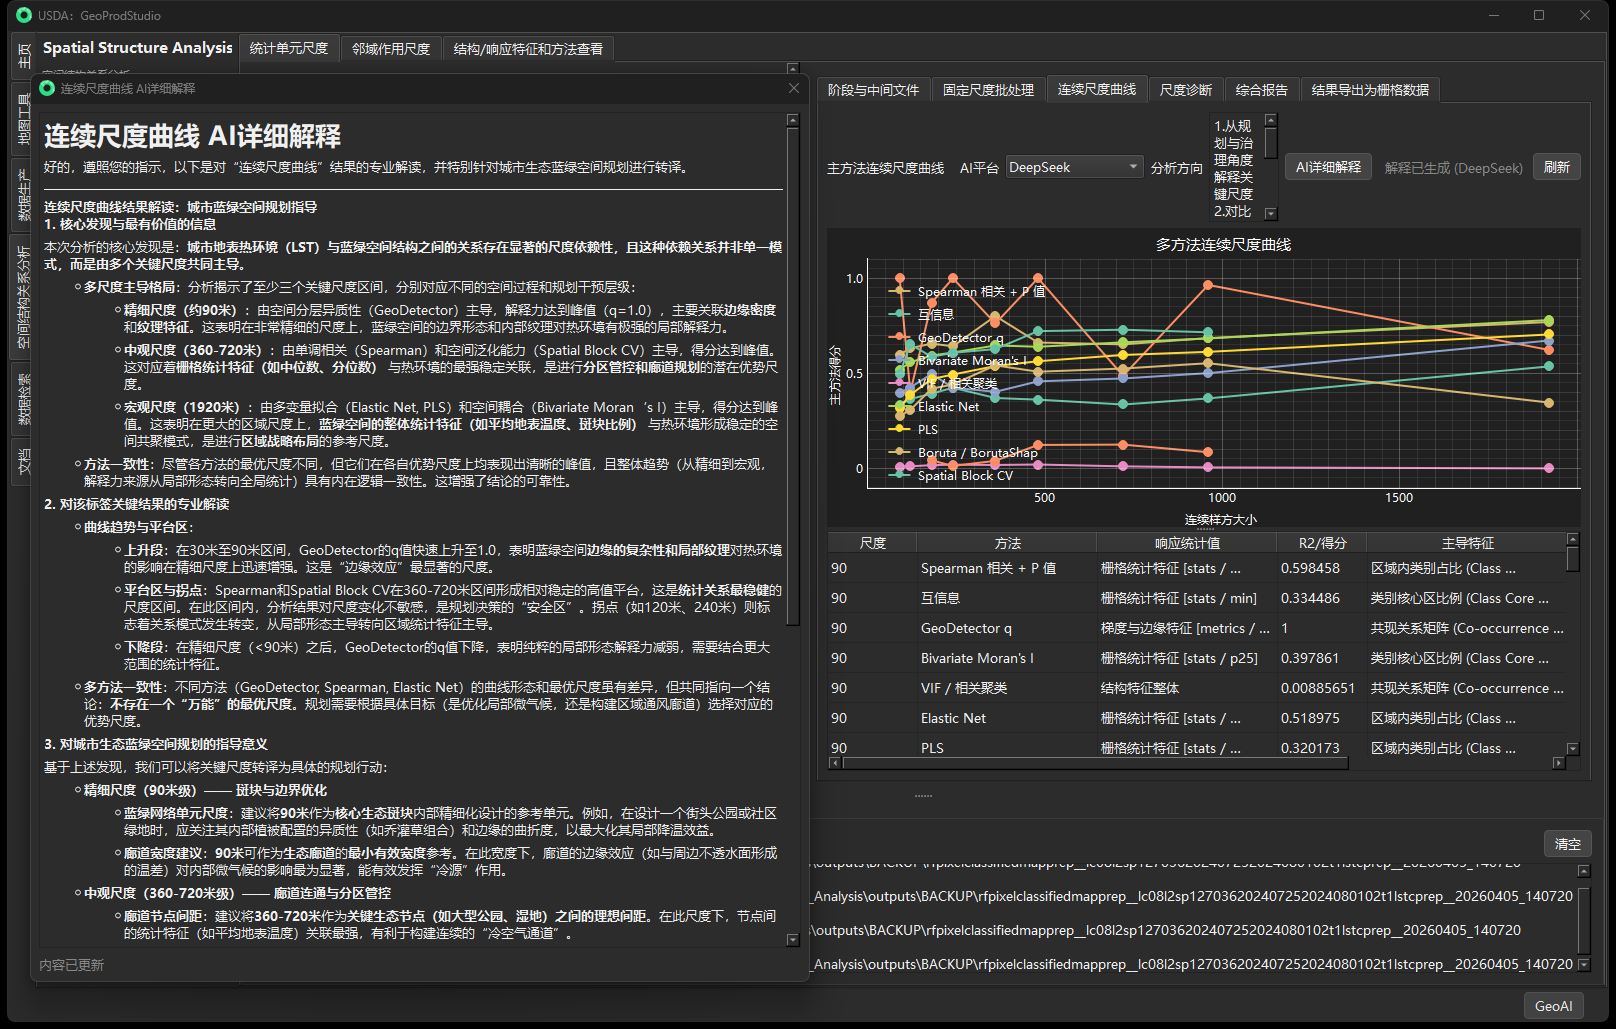
图 7-6 统计单元连续尺度曲线
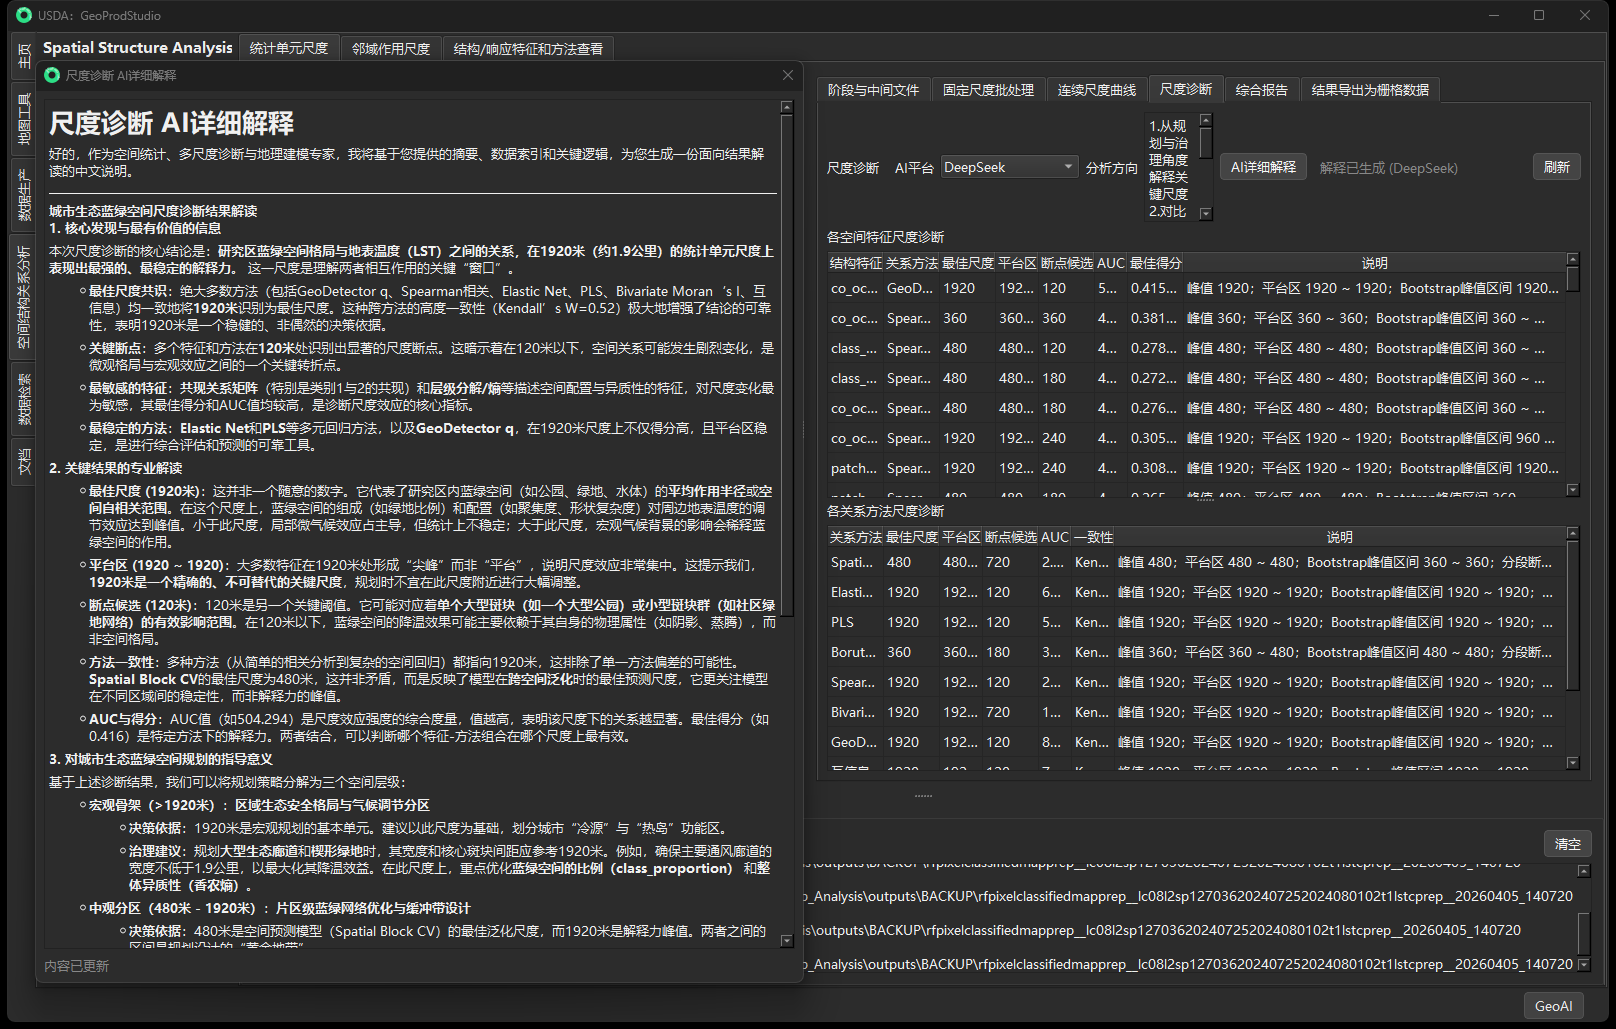
图 7-7 峰值、平台、区间与断点等尺度诊断
7.6 成熟后端与有效计算协议
计算协议 v4 与软件版本 3.5.0 分别记录。PyLandStats 3.1.0、dcor 0.6、SciKit-GStat 1.0.24、pymoo 0.6.2、ruptures 1.1.10 与 pgmpy 1.1.2 形成关键数值后端,回归和预处理使用 scikit-learn。依赖版本、真实模型身份、单位、输入签名和有效性状态随结果保存;可选模型缺失时明确提示,不以替代算法伪装。
小样方中的像元数约束斑块、分形和纹理的可估计程度;跨样方的总数约束回归与空间验证。两种样本量需分别报告。高训练拟合、前沿占比 1、只有 1—2 个有效折或极大负 R² 均不证明稳定关联。严格尺度比较应使用实际可比较、固定物理目标和合格验证记录。
控制变量、多目标与贝叶斯网络
8.1 控制变量与净效应
控制分析明确主结构 X、背景 C 与响应 Y,在同一有效样本和空间划分上拟合 X+C、X-only、C-only 模型。缺失填补、标准化、监督特征选择、抽样和参数搜索在训练折内完成,再用于测试折。控制后解释增量定义为最终共同有效折上完整模型与仅控制模型的 R² 差。偏相关为控制后残差的统计相关,需报告使用的具体结构对象。树重要度说明模型依赖,SHAP、置换和原生重要度各按真实身份记录;缺失依赖不伪装为其他后端。
eX = X − X̂(C);
eY = Y − Ŷ(C);
rXY·C = corr(eX,eY)
ΔR² = R²full(X,C) − R²control(C)
X̂(C)、Ŷ(C) 为控制变量回归预测,偏相关不控制未知混杂。ΔR² 按同一响应、共同有效样本、最终有效折、划分与调参协议计算,负值保留,是加入结构后的预测解释增量,不是因果净效应。多目标方向必须依据数据语义确认:LST 是热环境状态,NPP 是植被生产力而非净碳汇,PM2.5 浓度不是空气净化服务;AWC 按源数据定义和单位解释,不能仅凭缩写认定为水源涵养。
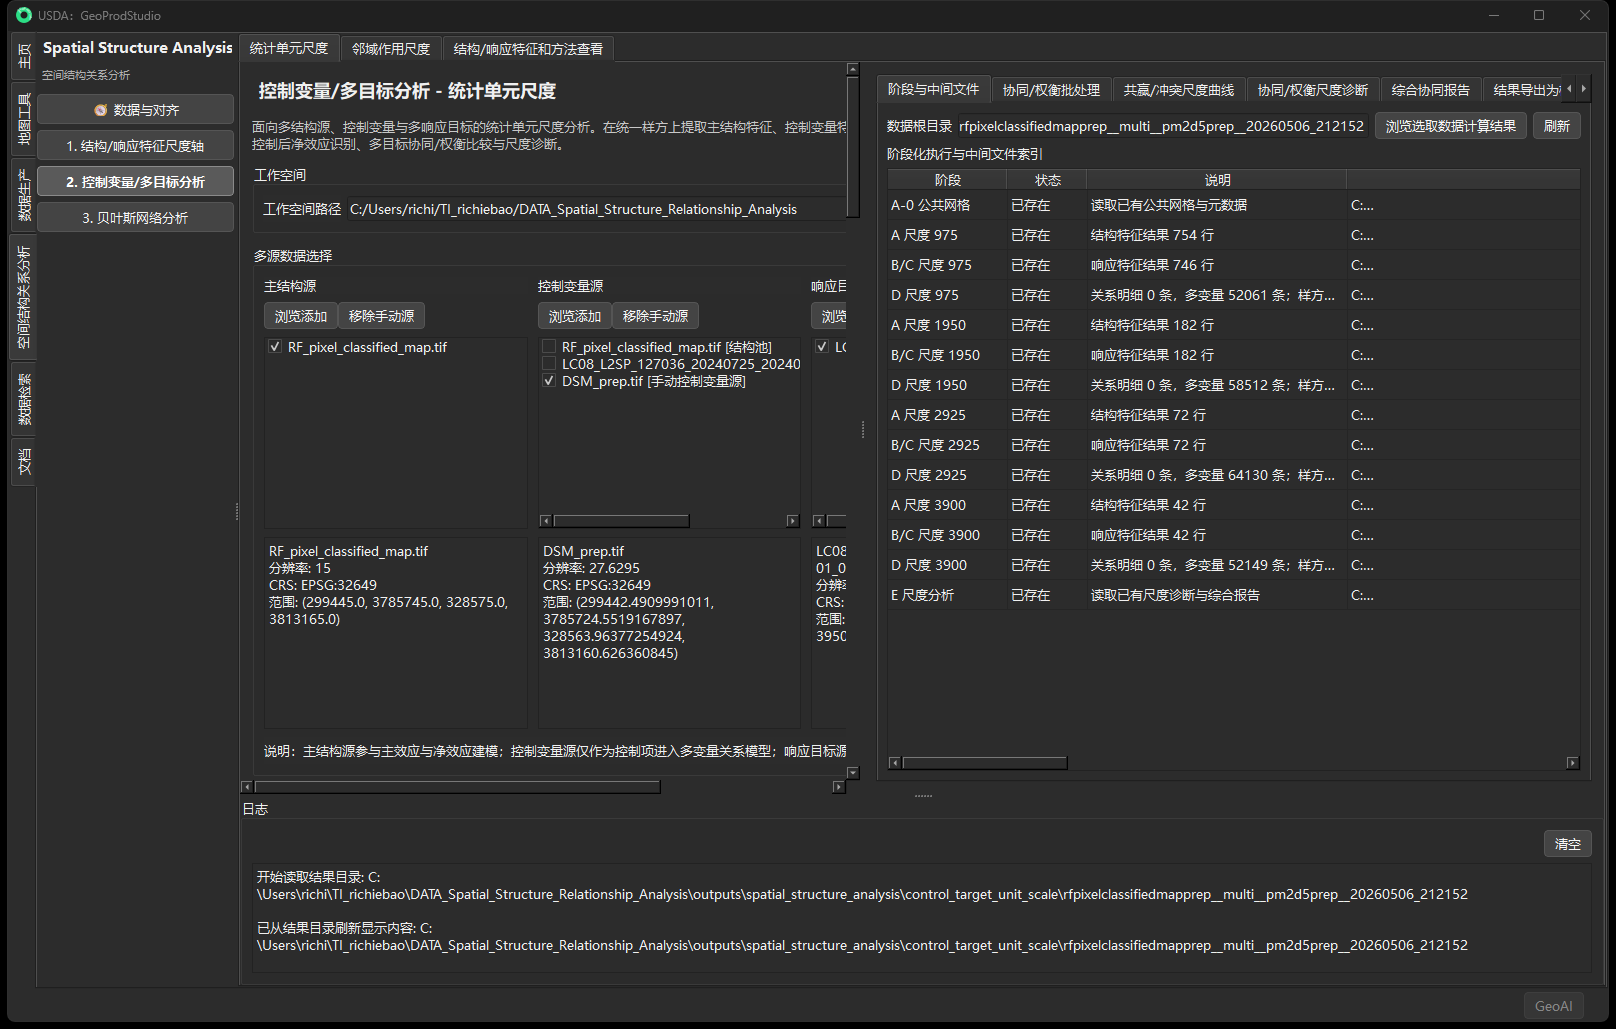
图 8-1 控制变量、多目标方法及尺度配置
8.2 协同、权衡、协调与 Pareto
多目标目标集只纳入至少两个非恒定的物理响应及明确改善方向,纹理、梯度等展开量不是额外生态服务。Synergy Index 为方向校正目标之间 Spearman 相关正部的均值,Trade-off Intensity 为负部强度均值,描述目标关联而非控制 X、C 后的作用。Coupling Coordination 使用固定源数据 2%—98% 参考界限形成 0—1 满意度,避免每尺度重新标准化。Pareto 使用 pymoo 精确计算非支配前沿成员及占比,不输出近似多层排名,也不证明相对基线的真实改善或共赢。
\[{S = mean}_{j < k}{\lbrack max(\rho}_{jk}{,0)\rbrack;\ T}_{conflict}{= mean}_{j < k}{\lbrack max( - \rho}_{jk},0)\rbrack\]
\[T_{i}{= mean}_{j}{(d}_{ij}{);\ C}_{i} = \frac{{geometric\ mean}_{j}{(d}_{ij})}{T_{i}}{;\ D}_{i}{= C}_{i}^{\alpha}T_{i}^{1 - \alpha}\]
ρⱼₖ 在全部目标共同完整样本上计算,目标方向先校正。dᵢⱼ 是按跨尺度固定参考界限截断到 0—1 的目标满意度;反向目标使用 1−d。Tᵢ=0 时 Cᵢ=0;D 为描述性协调评价。回图的 objective_level 为满意度均值,objective_imbalance 为其标准差,两者分别为目标水平与不均衡度,不称局部协同或生态冲突。前沿占比高可来自目标冲突或高维非支配,不代表多个目标同时改善。
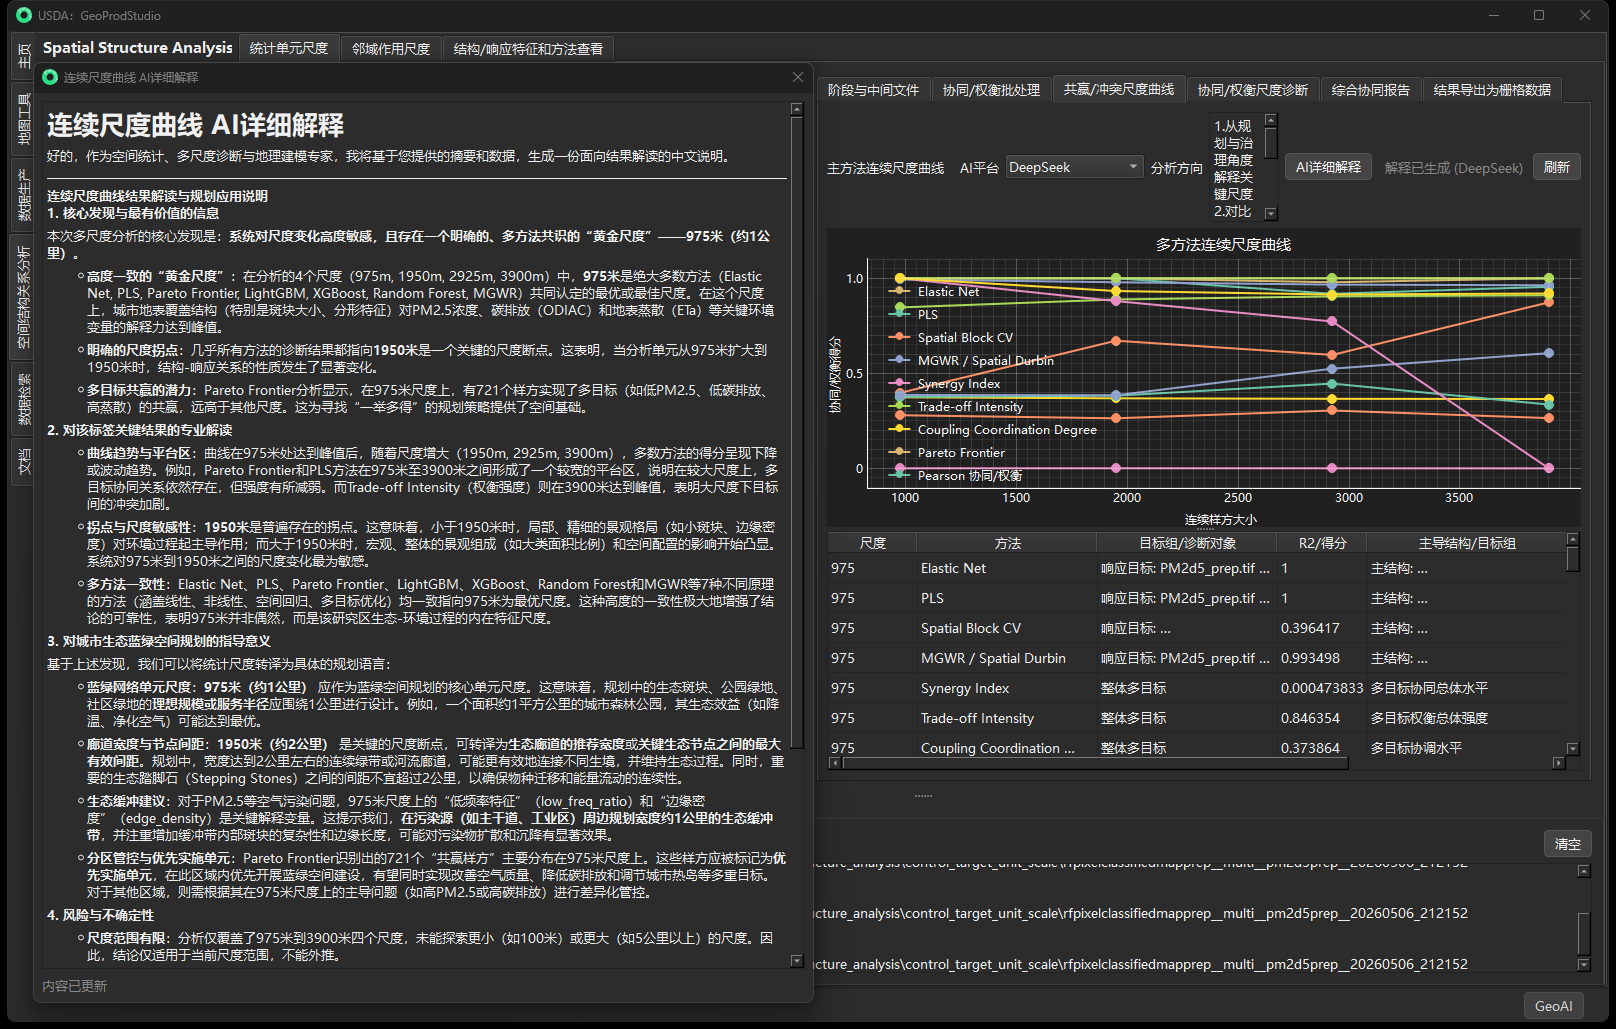
图 8-2 共赢—冲突尺度曲线的联合表达
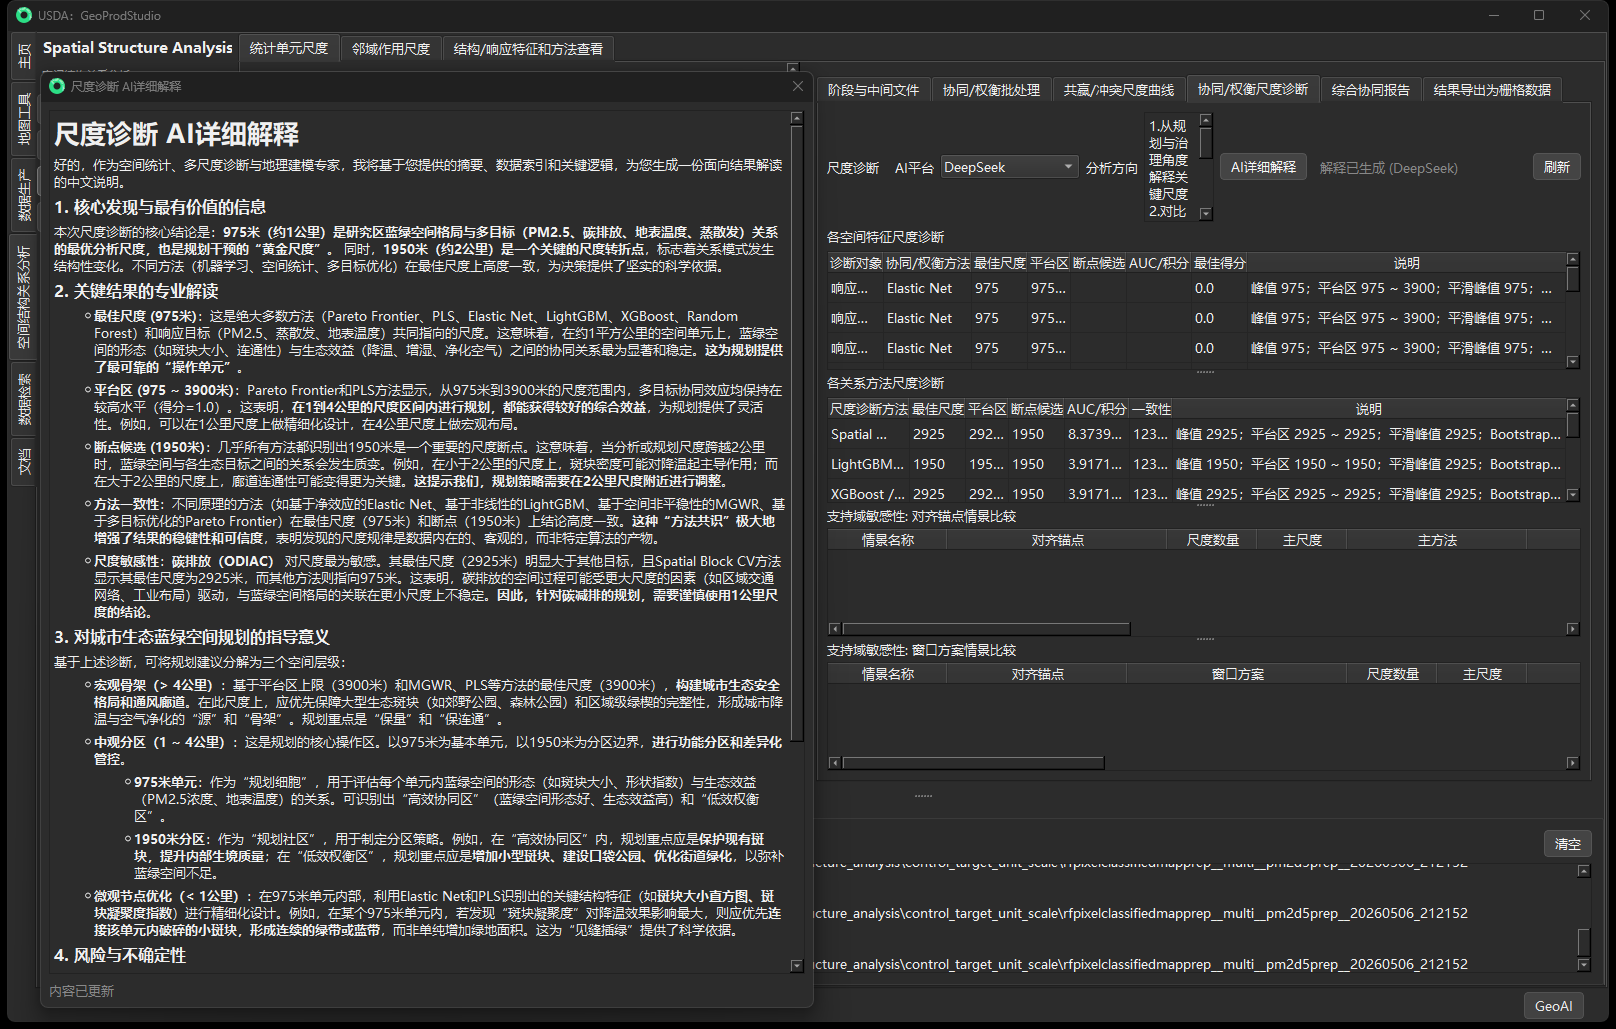
图 8-3 协同、权衡、协调与 Pareto 的尺度诊断
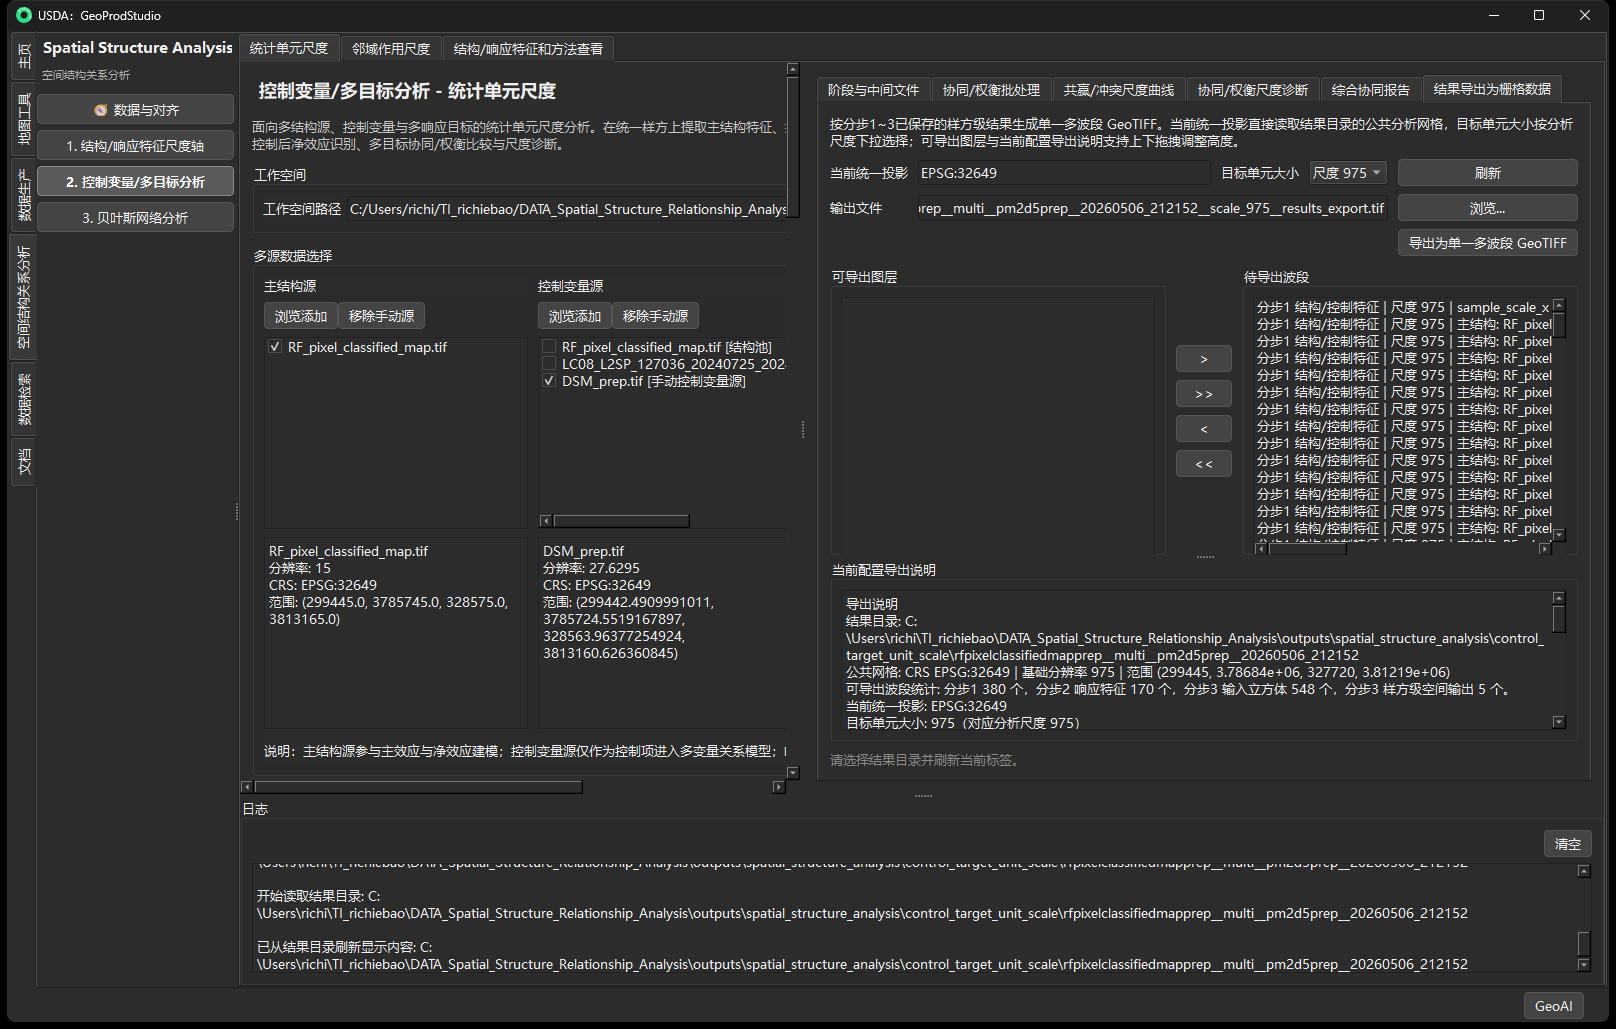
图 8-4 样方级模型预测、目标描述指标与非支配成员的空间化导出示例
8.3 贝叶斯网络的数据离散化
贝叶斯网络读取统计单元尺度的统一样本表,联合组织结构、控制和响应节点,排除行列号等位置索引。高缺失、恒定、非有限或离散状态重复的列记录剔除原因;保留列使用共同完整样本,不做中位数填补。低基数数值按有序状态编码;高基数直接对原始值 qcut 并删除重复边界,同值保持同状态,不先按行序排名;分类高频合并按元数据确认。状态范围、覆盖率、列剔除理由和尺度来源保存在离散化与质量文件中。
8.4 结构学习、参数学习与推断
V3.5.0 锁定 pgmpy==1.1.2,采用 HillClimbSearch 与 BIC 学习 DAG,遵守无环、最大父节点和改进阈值;随机重启固定预算,默认 3 次,基础种子 42,与并行任务数分离。BIC 的似然与惩罚由 pgmpy 计算,只能在同一数据集和离散化条件下比较。固定网络后采用 BDeu 参数先验,等效样本量默认 5,输出完整父状态组合的条件概率、观测计数、先验伪计数及仅先验标记,并通过 check_model 检查概率模型的一致性。
P(X1,…,Xp) = ∏i P[Xi | Pa(Xi)]
BICi = ℓi − 0.5ki ln(n); BIC = Σi BICi
式中,p 为网络节点数,X_i 为第 i 个离散随机变量,Pa(X_i) 为 X_i 的父节点集合,P[X_i|Pa(X_i)] 为给定父节点状态时 X_i 的条件概率,∏_i 表示对全部节点的条件概率连乘。ℓ_i 为节点 X_i 及其父节点对应的局部对数似然,k_i 为该局部条件概率模型的自由参数数目,n 为有效样本数,ln 为自然对数,BIC_i 为局部贝叶斯信息准则得分,BIC 为全部局部得分之和;按本实现的记号,BIC 越大表示评分越优。
有向边跨尺度复现率的分母为该边两端节点均有效的尺度数,至少两个可比较尺度才可标记跨尺度稳定。导出 BIC 增益是从最终 DAG 删除该边的条件得分损失,不是搜索接受顺序、P 值或因果效应。概率推断调用 pgmpy VariableElimination,仅使用一个完整单尺度 DAG、CPT 和保存的状态映射;跨尺度汇总边不是概率网络。非法证据、无支持证据或损坏 CPT 明确报错,不退回均匀概率。跨尺度复现及 check_model 不等于独立预测验证,预测 CV/Bootstrap 未计算时明确说明。
\[Recurrence(a \rightarrow b) = \frac{N_{edge}(a \rightarrow b)}{N_{eligible}(a,b)}{,\ N}_{eligible} \geq 2\]
Nedge 为方向边的出现尺度数,Neligible 为两端节点都有效的尺度数,反向边单独统计。复现率属于同批数据的尺度重复描述,不能作为 Bootstrap 置信度或因果可靠度;跨尺度 BIC 不作直接大小比较。
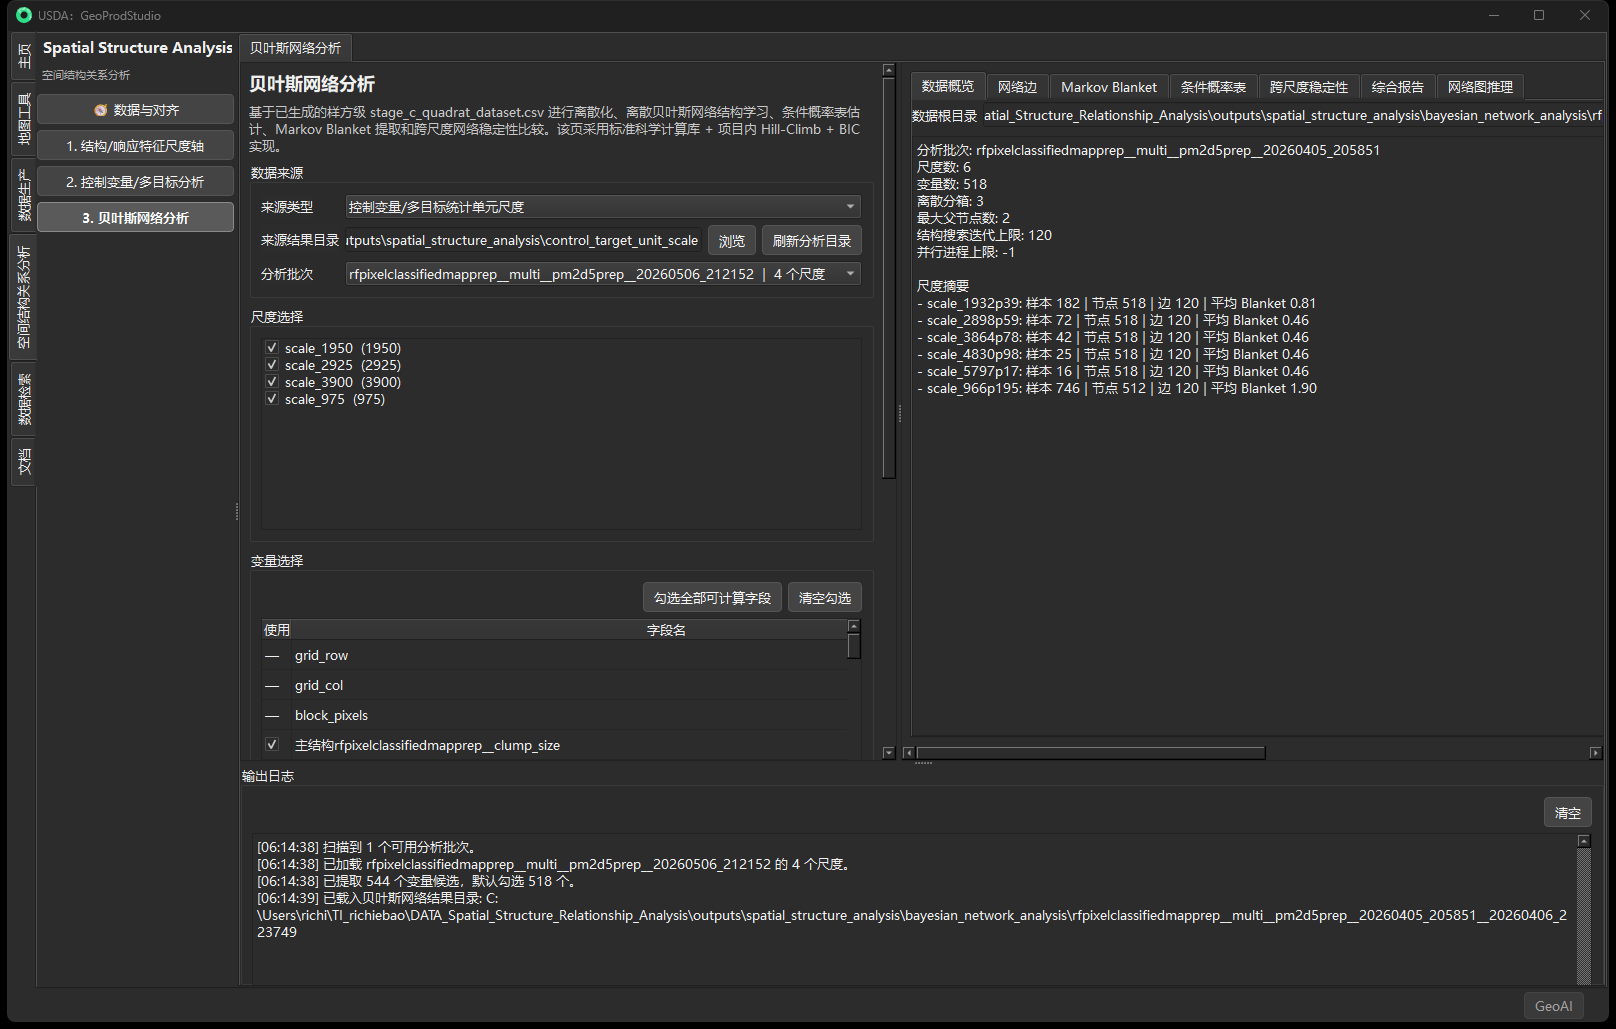
图 8-5 贝叶斯网络变量、尺度与学习参数配置
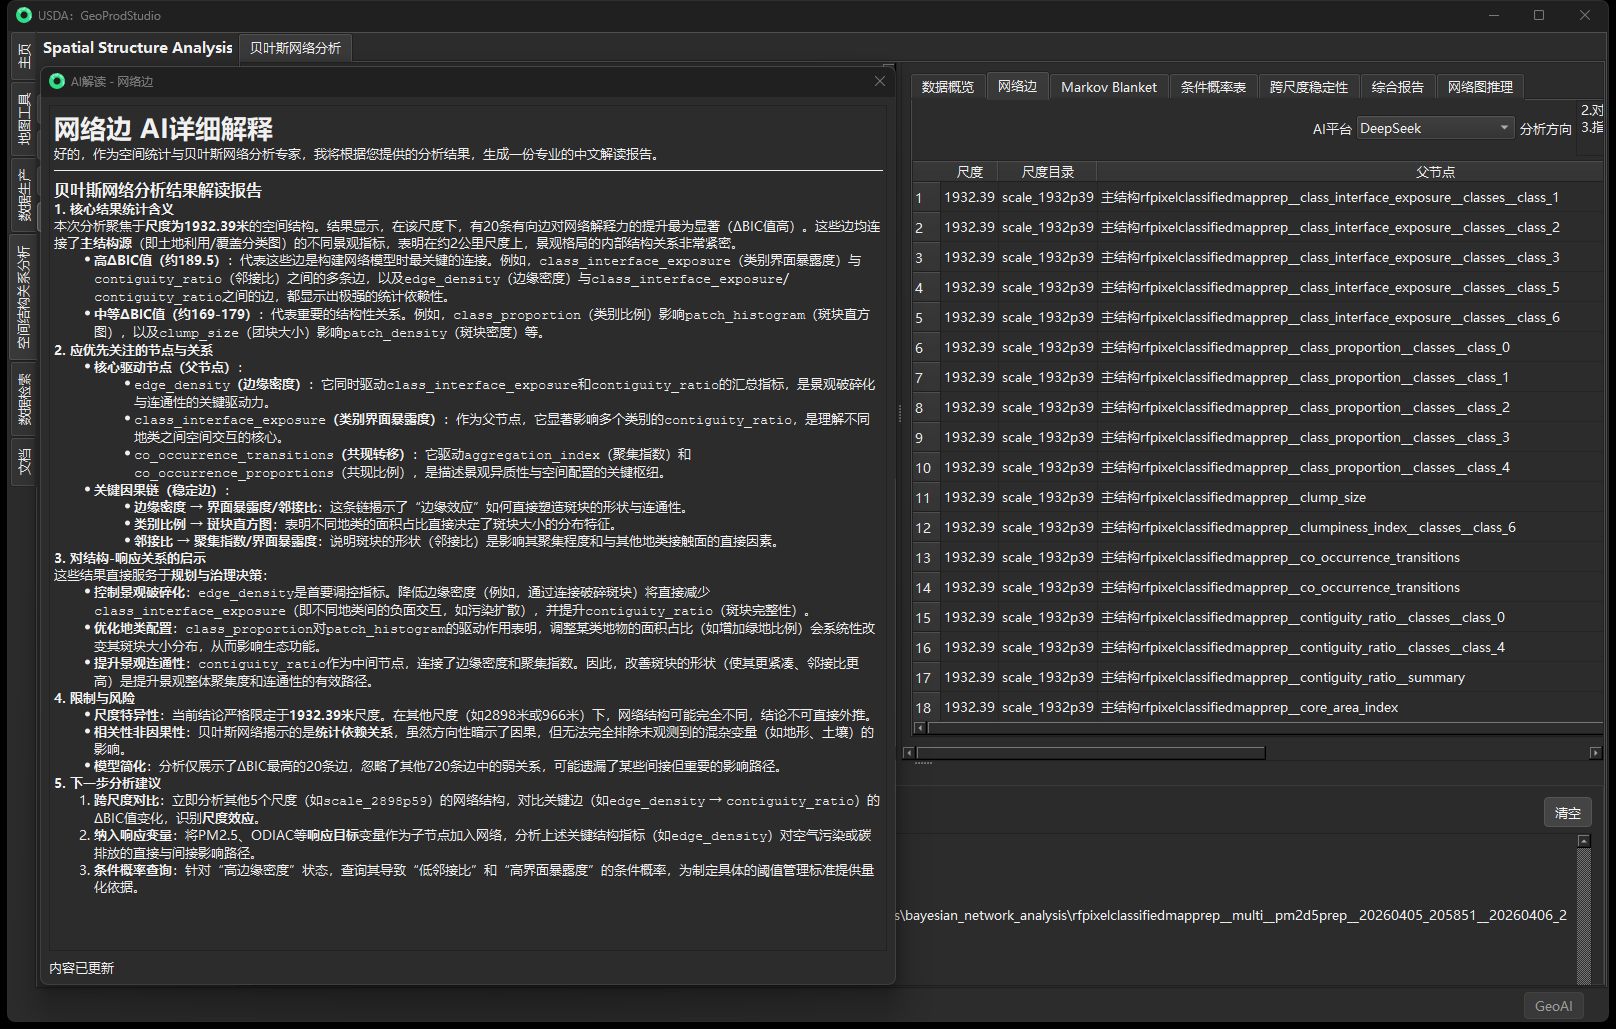
图 8-6 网络边及方向关系结果
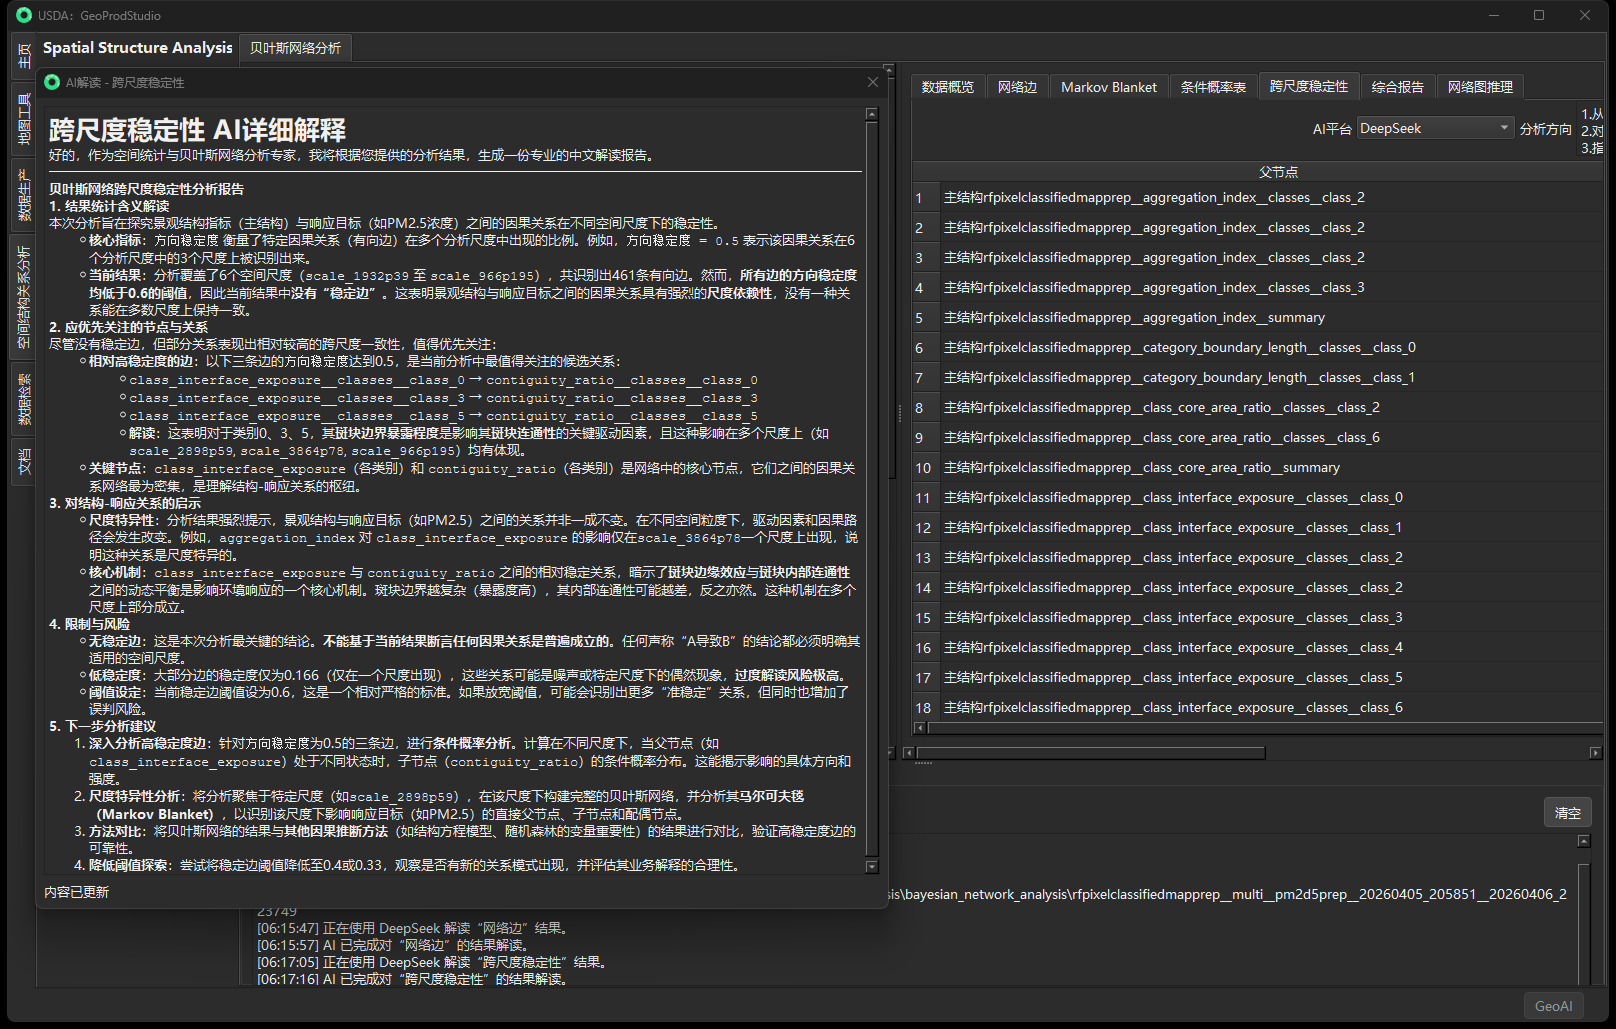
图 8-7 有向边跨尺度稳定性
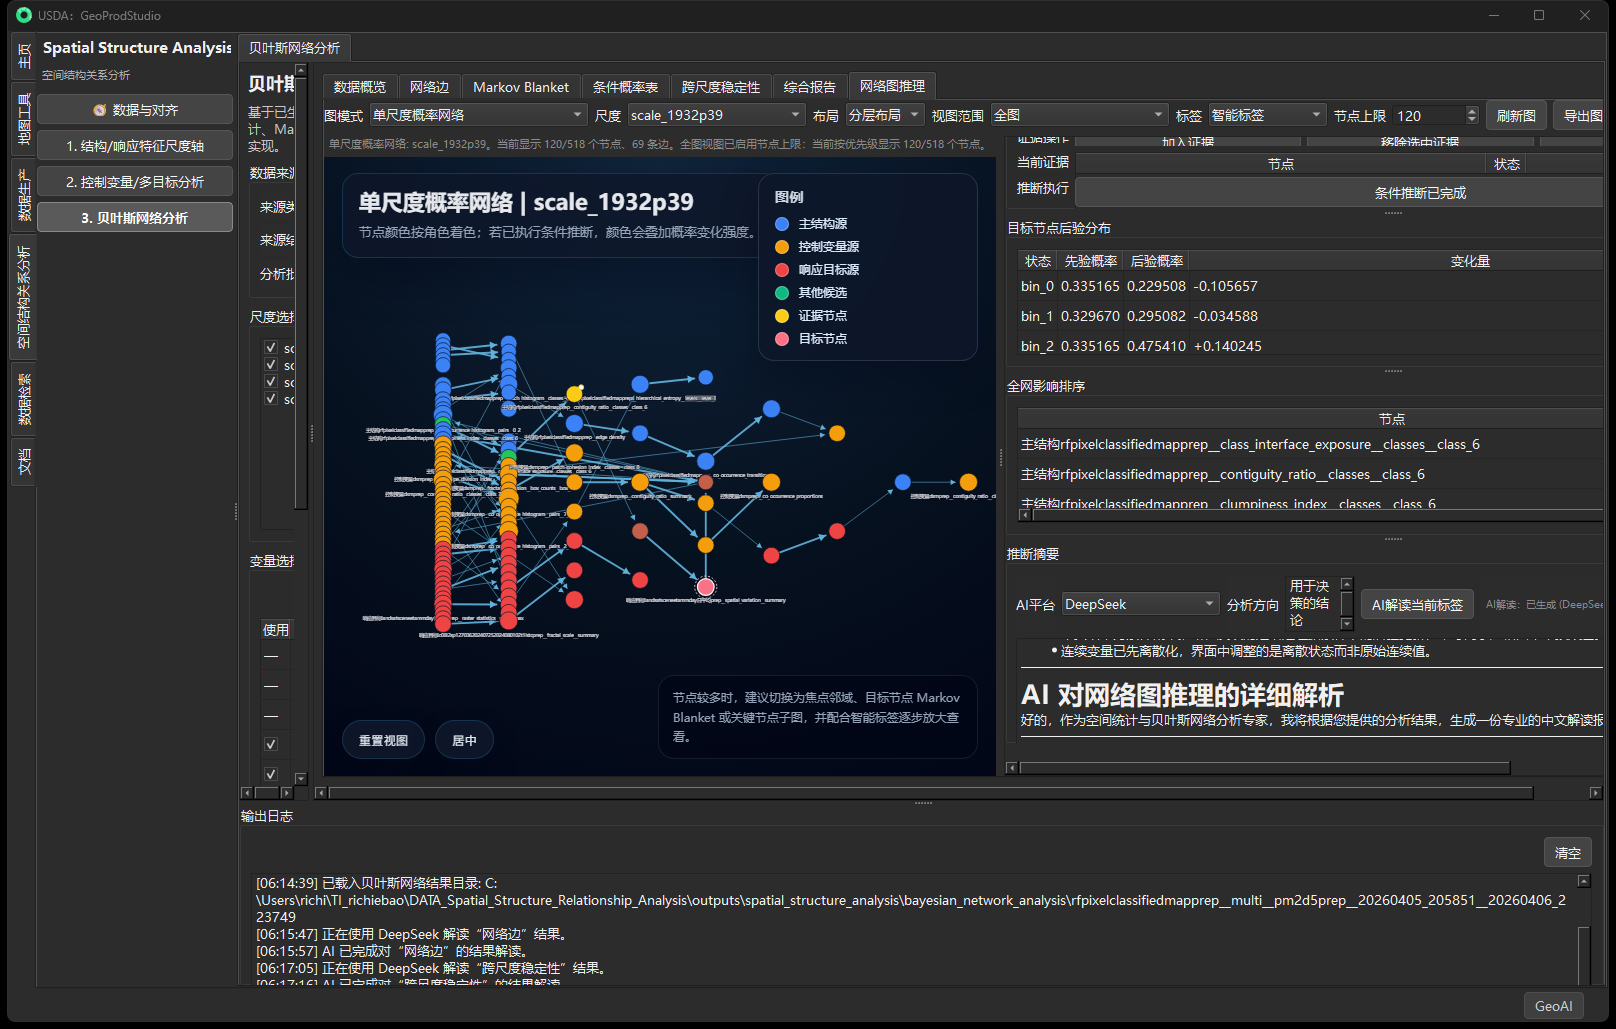
图 8-8 网络图、证据设置与条件概率推断
8.5 从分析指标到课题成果的转换
成果转换采用“来源与支持域—合格统计关系—目标状态—条件依赖—空间位置”的证据链。模型解释增量、目标水平、协调度、非支配成员和贝叶斯条件概率均按各自语义使用。它们可用于候选单元筛选与方案比较,不单独确定最优生态尺度、干预收益或工程尺寸。只有具备空间输出并叠加现状及约束时才定位实施区;未开展方案模拟或独立验证时不承诺改善比例或因果机制。
| 软件结果 | 核心含义 | 课题应用接口 |
|---|---|---|
| 最佳尺度、平台与区间 | 结构—响应关系强且相对稳定的单元或邻域范围 | 规划单元划分、服务作用范围与干预尺度 |
| 控制后净效应与主导特征 | 排除背景条件后仍具有解释贡献的结构维度 | 高效益单元结构组合与营建要素筛选 |
| 协同、权衡、CCD 与 Pareto | 多服务整体水平、内部冲突、协调状态和非支配共赢 | 综合效能评价、优先单元和多目标方案比较 |
| 稳定边、Markov Blanket 与后验变化 | 跨尺度条件依赖及特定结构状态下的概率响应 | 模式机制解释、情景推演和优化技术组合依据 |
| 局部多波段 GeoTIFF | 指标在原分析网格上的空间位置与字段语义 | 与规划分区、项目库和示范区叠加形成应用图件 |
表 8-1 分析结果向课题应用成果的转换关系
8.6 结果组合与跨城市比较
跨尺度比较固定响应源、物理统计对象、方法、指标、目标方向和有效性条件,再分别讨论序列形态及多方法支持。模型的 OOF 预测、描述性目标指标与前沿成员经 positions 回写;高值并不自动代表干预贡献。旧结果按实际元数据和有限性说明能支持的描述,不统一标为未核验,也不因文件多或汇总分数高认定其通过现行验证协议。软件升级不会自动重算历史城市批次。
跨城市比较以同一类别 schema、服务响应定义、期望方向和分析尺度口径为前提。软件保留城市、梯度分区、基础分辨率、样本数和有效域,既可比较高密度中心城区与外围区域,也可按城市类型归纳结构—服务关系。若不同城市采用本地化土地覆盖细类,可先在成果层建立上位蓝绿空间类别映射,再比较组成、破碎化、连通性及多目标状态,保持本地识别精度与跨区域可比性。
AI技术与GeoAI智能分析实现
9.1 技术定位、总体架构与职责边界
USDA V3.5.0 将 AI 分为项目知识对话、参数辅助与 Harness Agent 数据分析。正式数值核心由可复现的 Python 后端执行;Agent 作为 USDA 能力延伸,可在用户问题驱动下编写并运行本地脚本、检查完整结果表、复算或建立新的验证模型,再把证据摘要交给大模型解释。新分析保存在独立工作目录,不能与原批处理正式结果混写;知识问答本身不执行本地工具。
界面采集当前页面、分析模式、参数、结果根目录和允许读取的源数据清单,经 USDA MCP stdio 桥接与 Harness 运行时连接。平台与模型复用 AI API 配置中的 Key、Base URL、模型或 Endpoint ID,支持实际可用的 Chat Completions/Responses 接口。DeepSeek、Kimi、火山方舟和 OpenAI 按模型能力提供工具调用及多模态选择,名称存在不等于具备 Agent 或图像能力。密钥不写入轨迹和报告。
| 功能层 | 代表实现 | 主要输入 | 输出及边界 |
|---|---|---|---|
| 模型与配置 | utils/ai_config.py;AI API 配置页 | 平台、Base URL、API Key、模型/Endpoint ID | 建立可切换的模型连接;不参与空间数值计算 |
| 项目级 GeoAI | assistant_dialog.py;utils/project_ai_assistant.py | 用户问题、对话历史、相关本地代码与文档片段 | 知识对话检索版本化项目知识和当前页面状态;Harness 标签可生成、执行和核查本地分析工具 |
| 参数与特征辅助 | ai_param_optimizer_worker.py;feature_screening_ai_worker.py | 数据概况、当前参数、允许修改字段、筛选载荷 | 给出参数候选、特征取舍和验证步骤;由用户确认后采用 |
| 结果智能解释 | statistical_unit_scale.py;control_target_unit_scale.py;bayesian_network_analysis.py | 当前结果根目录及真实文件索引、元数据、小样本、当前页面、方法与源数据清单 | 多轮解释与本地工具分析,保存新脚本和证据;原始批次默认只读 |
表 9-1 AI功能层、实现入口与输出边界
9.2 GeoAI项目级助手
GeoAI 项目助手提供“项目知识对话”和“Harness Agent · USDA 能力延伸”两个工作方式。知识对话检索随版本构建的项目知识包与可读源码,结合当前页面和参数回答功能、方法与操作问题;它不启动本地执行,也不显示 Agent 工作目录和执行进度。Agent 工作方式使用同一平台配置,额外取得当前项目及数据上下文,生成本地工具并执行分析。二者均支持多轮记录,但执行能力及证据要求不同。
项目知识包由第一方源码、方法文档和实现定位组成,具有软件版本、源文件清单和内容哈希;源码模式和冻结 EXE 均可读取相应快照。检索片段用于解释实现,不能证明某个数据批次已计算或验证。Agent 使用真实目录建立文件索引,按需读取部分 CSV 行、列及栅格小窗口来理解结构,完整数据留在本机由生成的脚本处理;工具返回摘要、异常、统计表与文件位置。
9.3 参数建议、类别配色与特征筛选
土地覆盖数据生成、样本筛选、随机森林、XGBoost、LightGBM 和 ResNet 等面板提供“AI分析更新参数”操作。调用时,软件把影像或样本概况、任务类型、当前参数、参数允许范围及可修改字段封装为载荷,大模型只需返回严格 JSON;工作器完成 JSON 提取、字段约束与异常处理后,才把建议呈现在界面。该机制可根据样本量、类别不平衡、特征维度、块大小或训练目标给出候选配置,也可为土地覆盖类别生成区分度较好的颜色方案。建议不会直接启动训练,用户仍可比较原参数、数据规模和计算资源后决定是否应用。
空间结构特征筛选的 AI 工作者读取结构源、响应源、候选特征、推荐与排除结果、冗余或共线性信息等筛选载荷,生成中文实施报告。报告依次概述数据源和字段结构,解释主要推荐特征及排除原因,给出建议的方法执行顺序,并列出数据风险、冗余风险和验证步骤。正式筛选结果仍由既定算法、阈值与样本计算得到;AI 的作用是把机器可读的筛选载荷转译为可检查的实施逻辑,帮助研究人员发现变量语义不一致、重复特征或验证不足。
9.4 空间结构分析的阶段化AI数据解析
阶段化 AI 核对当前根目录的 manifest、schema、positions、完成状态、数据角色、物理目标、有效性与尺度覆盖,不以最高分摘要替代完整证据。初始仅提供索引和有限样本;全量检验、曲线重建及原始栅格复算由 Agent 按问题生成本地 Python 工具,再引用计算证据解释。未获得数据或未实际执行的分析明确标为缺证据,不补造结果。
| 阶段 | AI读取的数据结构 | 解析重点 | 形成的解释 |
|---|---|---|---|
| A-0 公共基准 | 数据源/类别元数据、公共网格、manifest、阶段文件索引 | 核对 CRS、分辨率、范围锚点、类别语义、有效域和运行参数 | 说明不同数据是否处于可比支持域,并指出来源、口径或缺失风险 |
| A 结构特征 | stage_a_structure_features.csv、结构 schema、positions | 识别组成、破碎化、连通、边缘、邻接、形状等字段及其分量 | 概括主导结构维度、空间含义和需联合解释的多维特征 |
| B 响应、C 统一样本 | stage_b_response_features.csv、stage_c_quadrat_dataset.csv | 解析响应统计、结构—响应字段连接、样本量、缺失值与位置索引一致性 | 说明可用响应、数据充分性、冗余与对齐风险,以及后续方法适用条件 |
| D 关系与空间结果 | stage_d_relations.csv、stage_d_multivariate.csv、stage_d_spatial_outputs.csv、stage_d_control_target.csv | 比较关系方向、得分、验证指标、控制后增量、多目标状态与局部空间结果 | 说明控制后关联、预测解释增量、目标关联与描述性空间异质性,附真实文件依据 |
| E 尺度诊断 | stage_e_feature_scale_diagnostics.csv、stage_e_method_scale_diagnostics.csv、stage_e_scale_report.txt | 核对可比较的固定对象序列、峰值和连续平台、候选断点、AUC 与未计算项 | 提出候选分析范围和验证要求;不直接转译为规划工程尺寸 |
表 9-2 空间结构分析各阶段的AI读取对象与解释任务
9.5 固定尺度、连续曲线与尺度诊断的AI解释
单目标结果链和多目标结果链在统计单元及邻域页面使用共享多轮对话组件,分别对应批处理、尺度曲线、尺度诊断和综合报告。批处理解释数据角色、具体对象、得分含义和质量;曲线核对固定序列的变化;诊断审查连续平台、断点、有效折和未计算项目;综合报告连接结构、目标和候选策略。贝叶斯页面使用相同组件并增加状态、CPT、条件推断及复现证据。各轮应明确回答问题、证据、未解决项和后续验证。
统计尺度只能作为单元比较和后续规划验证的分析依据,邻域窗口描述周边关联支持范围。任何峰值、近峰平台、训练高拟合或前沿成员数量都不独立证明生态最优或稳定,更不能直接换算廊道、缓冲带或绿地率阈值。规划指标转译需结合用地边界、标准定义、分类精度、当前规范和单独阈值验证;原数据不足时应说明边界,而非从最高分反推出确定参数。
| 结果页面 | 重点读取内容 | AI解释用途 |
|---|---|---|
| 固定尺度结果 | 方法、结构特征、响应统计、关系得分、验证指标、样本数 | 解释当前尺度的主要关联、方法差异和空间支撑 |
| 连续尺度曲线 | 固定来源、响应、结构对象、方法和指标的逐点序列、质量状态及样本条件 | 识别上升、下降、平台、突变与跨方法一致性 |
| 尺度诊断 | 合格峰值、连续近峰平台、平滑与断点、AUC;Bootstrap/独立一致性未计算状态 | 提出候选范围并说明证据限制,避免唯一最优尺度断言 |
| 综合报告 | 阶段摘要、方法字典、文件清单、实现片段和诊断建议 | 将数据证据转化为研究结论、复核清单和规划语言 |
| 空间化结果 | positions、波段/字段 schema、局部指标及空间输出说明 | 解释模型预测、目标水平、不均衡度、协调度和非支配成员的实际波段含义 |
表 9-3 结果页面的AI解释焦点与结论用途
9.6 控制变量、多目标与贝叶斯网络的AI解释
多目标解释分别核查控制后预测增量、方向校正目标关联、固定参考协调评价及精确非支配性。树重要度模式相似主要反映共同依赖的结构,不能把无符号重要度当作生态协同方向。P 值及 FDR 需说明检验假设;高得分、孤立峰值、对象切换、目标冗余、时相差异和有效折不足均列为限制。界面任务与报告使用当前城市和输入语义,不预设西安、150 m 或类别 0 的含义。
贝叶斯 AI 核对离散化与共同完整样本、pgmpy/BIC、BDeu 先验及完整 CPT,引用最终 DAG 边、两端节点有效的跨尺度复现率和合法证据下的概率推断。解释概率变化时给出状态范围、观测支持与仅先验配置,不将箭头或概率差写为因果效应。输入或参数变化后需核对存档来源与当前网络身份;完成状态不等于已回答用户全部问题,仍需检查交付清单和未解决问题。
9.7 可信使用、数据安全与可复现性
AI 结论必须引用实际读取或运行形成的证据文件与必要行、列、参数。每轮保存平台、模型、提示词、状态、执行轨迹、用量、证据引用和交付清单,允许后续核验和追问。脚本生成与模型推断也可能出错,正式研究结论需回到结果表、空间输出和独立验证。建议参数或新复算不是原计算已验证的证明。
Agent 默认只读当前结果及勾选允许的原始数据,将脚本与派生结果写入独立目录。初始只提供索引、元数据和有界样本,不将庞大表格或整幅栅格全部上传。外部模型仍会接收必要的问题、样本或摘要,敏感内容应在调用前自行核查。路径权限由本地桥接及工具工作区约束,不能宣称提供操作系统级完整隔离。
Windows 使用短 Agent 工作路径并保留 workspace.json 与根目录映射,无需移动或重算原始结果。对话可复制为 Markdown、加载历史、清空并新建会话;清空界面不删除已有存档。轮次小横杠支持悬停摘要和点击定位,提示词保留原始换行,AI Markdown 渲染保留完整原文。执行进度显示运行时间、模型请求、用量及工具事件,成果入口指向当前会话目录。
9.8 Harness Agent 本地工具与任务交付
集成使用本地导入的官方 Harness 源码及已构建运行组件,Harness 版本独立于 USDA 版本管理。共享 Qt 对话界面通过运行时协议及 USDA MCP 桥接接入,并非直接嵌入官方浏览器界面。Agent 在首次任务时启动,获取当前页面、结果根目录、参数与输入清单,调用自身读取、检索、编写、编辑和 PowerShell 工具,按问题生成适合数据结构的 Python 等分析脚本;不是只执行 USDA 预先列出的固定检验。
初始上下文由数据索引、方法语义和有界样本组成。默认勾选“可使用原初数据”,允许读取来源清单中与当前批次关联的原始栅格或表;关闭后仅使用已计算结果。已有批次保存的来源优先,当前页面新选源另行区分。原始源与分析路径的映射写入 source_inputs.json,样本可用于识别格式与字段,完整数据由本地脚本读取。缺失文件、权限或证据不足必须说明。
默认以任务完成、用户停止或明确无法继续结束;请求数、压缩次数和总时间上限为用户可选,0 表示不设上限。单次网络与命令超时仍独立设置。连续工具失败或重复调用无新增证据采用纠正提示和阻塞检测,不将达到固定请求次数作为正常完成。运行时意外退出只在确认退出后进行有限恢复,保存已有成果与诊断,避免盲目重放未知执行状态的命令。
Windows 优先采用短工作目录,必要时回退到当前用户 LOCALAPPDATA/USDA/Agent/w/<hash>,通过 workspace.json 和根目录索引连接原始结果目录。每轮保存 events.jsonl、model_requests.jsonl、脚本、证据、source_inputs.json、analysis_contract.json、task_plan.json、task_delivery.json 及检查点。执行进度展示时长、请求与用量;任务 completed 只说明运行结束,报告完整性仍需核对用户问题、交付清单和未解决项。
对话组件保存用户原文换行与 AI 完整 Markdown,支持每轮定位、悬停摘要、历史加载、复制 .md 和清空新建。结果区与 AI 标签分开,配置、日志和详情折叠,窄窗口滚动;表格分页只限制显示,不截断数据文件。对话内容更新使用完整存档身份,避免不同会话、刷新或流式显示混淆。
软件工程实现
10.1 技术栈与运行组织
软件以 Python 为主要开发语言,Qt/PySide6 构建桌面交互,Qt WebChannel 连接地图页面;NumPy/Pandas 承担数组与表格计算,rasterio/GDAL 与 GeoPandas/Shapely 处理栅格、矢量和空间参考,scikit-learn 组织传统模型和统计学习,PyTorch 支撑 ResNet,空间统计和贝叶斯网络模块按依赖可用性启用。主线程只处理交互和轻量状态更新,计算任务进入 QThreadPool/工作线程并通过信号回传进度、日志和结果。
10.2 大数据与性能策略
栅格生产与推理采用窗口读取和分块写出,避免将整景多波段特征全部驻留内存;预览显示使用 2%—98% 拉伸并可对超大 CSV 抽样至 5 万个点,仅影响显示,不改变分析数据;分割采样维护 segment_id 的常数时间图层映射;空间关系方法根据样本量提供 sample_cap、最大控制特征数和快速参数;阶段缓存使已完成的对齐和特征结果可复用。计算开销在方法注册信息中分级展示,便于在数据规模和方法复杂度之间做显式配置。
10.3 参数、日志、异常与可复现性
参数、来源路径及指纹、软件与数值协议版本、随机种子、有效样本和输出状态落盘。训练处理和网络重启使用可记录种子;未实际开展的 Bootstrap 不记录为已有检验。正式结果必须完成原子提交及文件哈希校验后才能复用,中断快照单独保存并核对签名。Agent 会话与原批次分别归档,保持每轮新分析和正式阶段文件的来源边界。
10.4 输出结构与互操作
空间结果以 GeoTIFF/GeoJSON 为主要交换格式,统计结果以 CSV/JSON/TXT 表达,数组中间结果以 NPY/NPZ 保存,模型以对应框架格式保存。地图加载器将矢量转换为 GeoJSON 并以 EPSG:4326 供 Web 地图显示,栅格按空间参考生成渲染图层;导出结果保留原分析网格和 NoData,支持在 QGIS/ArcGIS 等环境中复核。多波段 GeoTIFF 同步保存波段说明和 schema,防止局部指标的波段语义丢失。
| **追溯对象 **manifest 重建输入、尺度、方法、参数与阶段状态;schema 解释变量角色、字段和栅格波段;positions 把表格结果写回空间;模型文件、类别编码与特征顺序保证训练—推理一致;评价/QC 文件记录分类指标、有效比例、值域和 QA 来源。 |
|---|
10.5 发布资源与可升级运行时
冻结 EXE 的设计同时携带固定 Harness 运行版本、Node、Python SDK 与科学计算运行环境,以及第一方可读源码快照和版本化知识包。资源按安装位置相对解析,用户会话与升级目录位于用户可写路径,不能依赖开发者机器的绝对资源目录。源码快照用于理解计算实现,不代表 Agent 可以直接修改运行中的二进制。
用户可导入新的本地 Harness 源码,或通过按钮从官方 GitHub 获取候选版本。候选构建与健康探测成功后才原子切换,失败提示原因并保留当前可运行版本,支持回退。源码升级所需编译工具与安装后运行所需组件分别检查。OrthoPlan-AI 开发入口在本次发布关闭。此次技术报告修订未生成或验证新的 EXE 安装包,发布前仍需跨机器安装和运行检查。
系统验证与课题应用链
11.1 验证框架
系统验证分为输入、计算、结果和追溯四层,并与课题成果链对应。输入层检查土地覆盖样本、服务响应和背景控制数据的文件格式、空间参考、时相、波段/字段语义、范围和有效值;计算层检查参数落盘、随机种子、类别编码、样本数量、特征有限性、尺度支持域、方法适用条件和异常日志;结果层根据任务类型检查分类指标、空间块交叉验证、尺度稳定性、多目标概率分布及空间叠加;追溯层检查高效益单元、局部净效应或网络关系能否关联到 schema、positions、manifest、模型和 QC 标签。
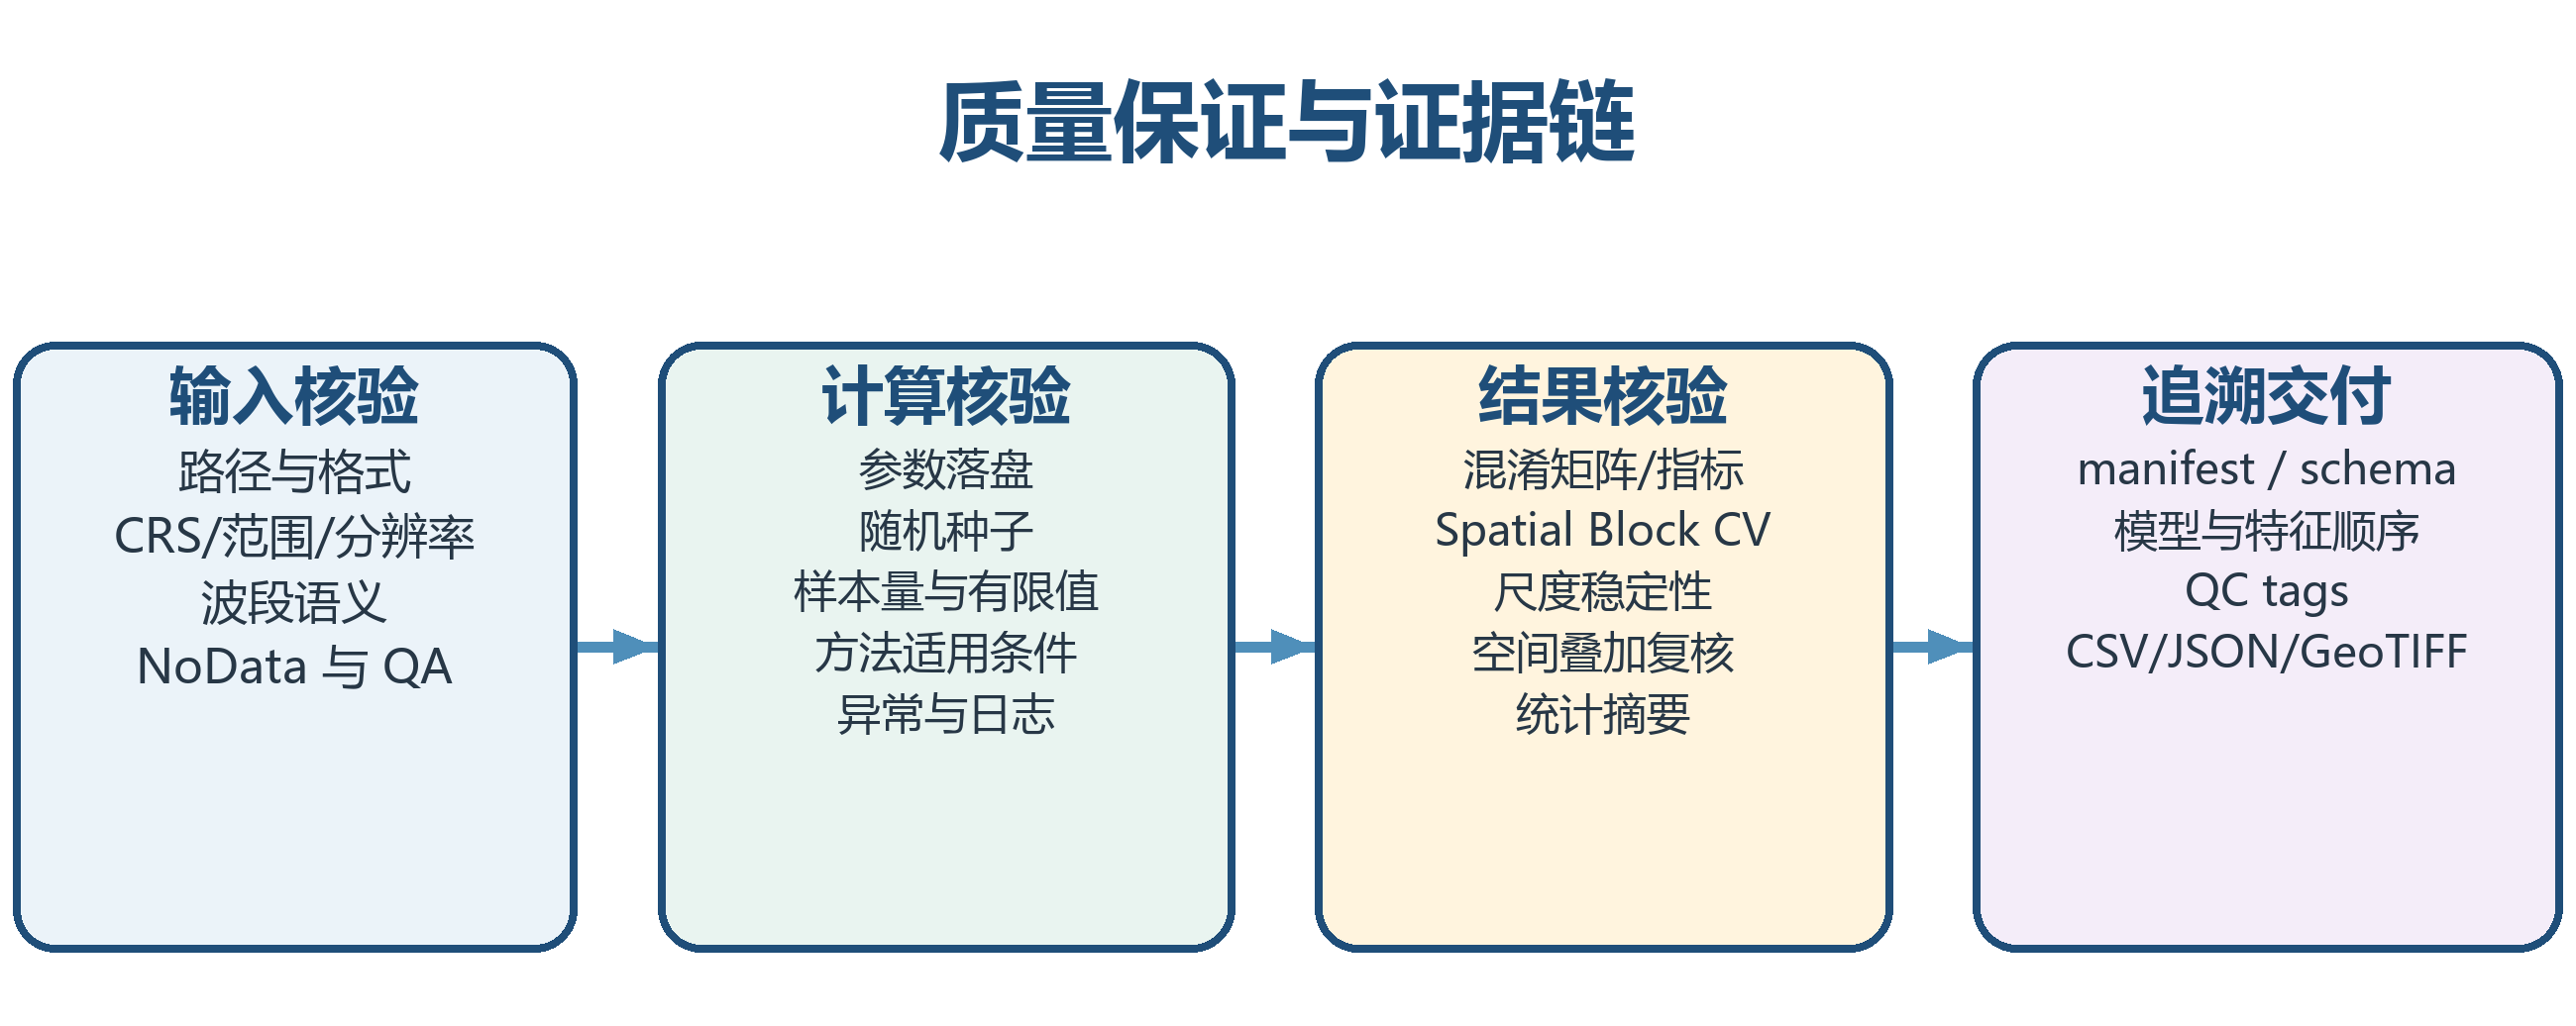
图 11-1 从输入到交付的质量保证与证据链
11.2 报告级一致性核验
本版报告依据当前 V3.5.0 源码、方法注册、配置及工程验证记录同步更新,不以旧版静态源文件数量替代当前回归证据。2026-10-07 的双尺度修复记录报告 151 项测试通过,并记录四种模式、三种屏幕、三种 DPI 与两种详情状态共 72 次离屏布局检查;pgmpy 迁移记录报告 30 项测试通过。版本一致性记录核验软件与知识包为 3.5.0。以上是指定测试和工程检查结果,未在此次报告修订中重算全部城市结果,未开展真实付费 API 全流程或新 EXE 安装包测试。
| 核验对象 | 核验内容 | 结果 |
|---|---|---|
| 工程源文件 | V3.5.0 版本信息、知识包版本与第一方源码清单核验 | 版本一致性记录通过;不沿用旧版 162 文件计数 |
| 空间基准 | CRS、目标网格、公共范围、NoData 和位置索引链 | 实现与文档一致 |
| 分割采样 | A—E 阶段、特征、算法、segment_id 与输出文件 | 实现与界面一致 |
| Landsat LST | ST_B10 缩放、摄氏转换、QA_PIXEL 0—5 位与 230—360 K | 与代码及 USGS 定义一致 |
| Landsat ETa 估算 | 反射率/温度缩放、场景冷热端、ETf 截断与 ETa 估算 | 公式与处理器一致 |
| 土地覆盖 | 样本字段动态类别、15 m 融合、多域/时序特征、模型、块式预测、评价与类别重映射融合 | 形成可配置类别与重复生产闭环 |
| 双尺度分析 | 物理尺度、指标单位、折内处理、空间隔离、固定对象序列及布局回归 | 已记录 151 项测试、72 次离屏布局;案例数据需另验证 |
| 多目标/贝叶斯 | 方向目标、精确 Pareto、匹配解释增量及 pgmpy/BDeu/CPT/合法证据 | BN 迁移 30 项测试通过;预测 CV/Bootstrap 未计算 |
表 11-1 核心技术链核验结果
验证记录:output/reports/空间结构关系分析_两个模块修复与验证_20261007.md;output/reports/贝叶斯网络_pgmpy后端迁移与修复验证_20261007.md;output/reports/版本升级_3.5.0_一致性核验_20261007.json。相应测试范围是数值后端、质量语义、复用及布局等工程行为;不能外推为全部输入、全部城市或所有模型 API 的验证。
11.3 课题应用结果的表达与判读
正文和附录图谱保留既有界面示例,用于说明工作流程与成果组织;部分图为历史批次或旧布局,不证明当前版本在该案例上的算法验证、峰值或泛化性能。V3.5.0 的按钮、模型身份、指标定义、质量门和对话能力以本报告更新文字及当前软件为准。实例数值需回到原目录、生成版本及有效性记录独立核验。
| **结果评价口径 **分类精度、尺度得分和概率变化均由具体数据、样本、空间划分和参数决定。软件将每次运行的评价文件与成果共同保存,不把某一案例数值固化为软件的通用性能;技术报告展示的是完整、可核验的评价机制和实现闭环。 |
|---|
11.4 面向课题成果的典型研究链
典型研究链先完成城市与时相、类别字典、样本及遥感产品质量核查,再组织结构 X、控制 C 和物理响应 Y 的共同支持域;分别执行统计单元与邻域分析,检查有效样本、空间验证、关系表与目标集。多目标成果包含关联强度、固定参考协调评价及精确非支配成员;贝叶斯成果包含离散状态、完整 CPT、条件依赖及跨尺度复现。Harness Agent 可在独立目录补充质量检查、复算和规划指标转译依据;候选方案仍需空间约束、外部规范和独立验证。
| 研究环节 | 输入与分析 | 可交付成果 |
|---|---|---|
| 蓝绿空间现状底板 | Landsat、DEM、对象样本、自定义类别与模型融合 | 可追溯土地覆盖产品、类别 schema、精度评价 |
| 生态系统服务响应 | LST/ETa 估算层生产,其他服务模型/监测结果接入 | 同网格响应 GeoTIFF、有效域和 QC 信息 |
| 高效益单元识别 | 统计单元尺度、结构特征、控制后关系与综合效能 | 关键尺度、单元指标、主导结构和空间分布 |
| 邻域作用与优化范围 | 固定中心响应、结构窗口、空间关系和尺度诊断 | 作用范围、溢出关系、局部优化指标 |
| 营建/优化模式归纳 | 多目标协同权衡、Pareto、稳定网络和条件推断 | 候选模式比较、非支配成员、条件概率情景和验证需求;不直接承诺改善 |
表 11-2 软件成果与子课题研究环节的衔接
11.5 高效益单元与优化模式的归纳规则
高效益候选单元需同时审查目标水平、质量状态、空间支持、控制后验证增量和实际用地约束。目标关联、协调描述和前沿成员只支持各自含义;前沿份额并不代表全部目标达标或同时改善。先划定可比较的对象与有效范围,再进行空间叠加和方案验证,保留未证实收益和数据不足项。
优化模式先作为待验证的结构配置假设。多尺度关联与条件概率可指导选择比较变量和分析范围,干预方向、阈值、作用半径及工程尺寸需另行情景试验、独立样本或实地验证。模式记录城市与时相、类别语义、支持域、参考目标、控制背景、候选策略、可能权衡和引用文件,不将统计关系写成因果增益。
技术特点与总结
12.1 技术特点
• 面向课题建立可配置土地覆盖生产机制:类别由样本字段定义,结合对象分割、15 m 全色融合、多域/时序特征和多模型融合,服务建成区细粒度蓝绿空间底板生产。
• 统一空间基准贯穿土地覆盖、环境响应、城市背景和空间统计,使结构—控制—响应变量在同一位置索引和有效域上计算。
• 严格落实 Landsat Collection 2 Level-2 的缩放和 QA 语义,以 LST 和口径明确的 ETa 估算层衔接城市热环境与水热过程响应。
• 以双尺度支持域、固定对象序列和带质量状态的诊断组织候选峰值、连续平台及转折,明确未开展的独立不确定性检验。
• 以组成、破碎化、连通、边缘、邻接、形状和多尺度组织系统表征蓝绿空间,而非仅以面积比例解释生态系统服务。
• 采用成熟后端、折内处理与嵌套空间验证,区分预测增量、目标关联、描述性协调、精确非支配性和 pgmpy 条件概率。
• 集成 Harness Agent、USDA MCP 桥接、多轮对话和可追溯本地工具分析;版本化知识、短路径映射与证据存档支持复核。
12.2 总结
USDA GeoProdStudio V3.5.0 将遥感数据生产、结构—响应双尺度分析、控制与多目标比较、贝叶斯网络及 AI 本地分析组织为可追溯研究流程。成熟后端、质量状态、空间验证、签名复用与异步界面降低计算误配风险;Agent 依据真实数据生成本地工具并保存脚本、轨迹和交付证据。系统支持蓝绿空间候选结构、分析尺度和规划方案比较;干预收益、规划阈值与工程尺寸仍需城市案例复核、独立生态验证及情景试验。
参考文献
[1] The Qt Company. Qt for Python Documentation [EB/OL]. https://doc.qt.io/qtforpython-6/ (accessed 2026-07-17).
[2] GDAL/OGR Contributors. GDAL Documentation [EB/OL]. Open Source Geospatial Foundation. https://gdal.org/ (accessed 2026-07-17).
[3] Gillies S, Ward B, Petersen A S, et al. Rasterio: Geospatial Raster I/O for Python Programmers [EB/OL]. https://rasterio.readthedocs.io/ (accessed 2026-07-17).
[4] Jordahl K, Van den Bossche J, Fleischmann M, et al. GeoPandas Documentation [EB/OL]. https://geopandas.org/ (accessed 2026-07-17).
[5] Pedregosa F, Varoquaux G, Gramfort A, et al. Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 2011, 12: 2825-2830.
[6] Paszke A, Gross S, Massa F, et al. PyTorch: An Imperative Style, High-Performance Deep Learning Library. Advances in Neural Information Processing Systems, 2019, 32: 8024-8035.
[7] Open Geospatial Consortium. OGC GeoTIFF Standard 1.1. OGC 19-008r4, 2019. https://docs.ogc.org/is/19-008r4/19-008r4.pdf.
[8] U.S. Geological Survey. Landsat 8-9 Collection 2 Level 2 Science Product Guide. Version 6.0, 2024. https://www.usgs.gov/media/files/landsat-8-9-collection-2-level-2-science-product-guide.
[9] Tucker C J. Red and Photographic Infrared Linear Combinations for Monitoring Vegetation. Remote Sensing of Environment, 1979, 8(2): 127-150. DOI: 10.1016/0034-4257(79)90013-0.
[10] Huete A R. A Soil-Adjusted Vegetation Index (SAVI). Remote Sensing of Environment, 1988, 25(3): 295-309. DOI: 10.1016/0034-4257(88)90106-X.
[11] Huete A, Didan K, Miura T, Rodriguez E P, Gao X, Ferreira L G. Overview of the Radiometric and Biophysical Performance of the MODIS Vegetation Indices. Remote Sensing of Environment, 2002, 83(1-2): 195-213. DOI: 10.1016/S0034-4257(02)00096-2.
[12] McFeeters S K. The Use of the Normalized Difference Water Index (NDWI) in the Delineation of Open Water Features. International Journal of Remote Sensing, 1996, 17(7): 1425-1432. DOI: 10.1080/01431169608948714.
[13] Xu H. Modification of Normalised Difference Water Index (NDWI) to Enhance Open Water Features in Remotely Sensed Imagery. International Journal of Remote Sensing, 2006, 27(14): 3025-3033. DOI: 10.1080/01431160600589179.
[14] Zha Y, Gao J, Ni S. Use of Normalized Difference Built-up Index in Automatically Mapping Urban Areas from TM Imagery. International Journal of Remote Sensing, 2003, 24(3): 583-594. DOI: 10.1080/01431160304987.
[15] Feyisa G L, Meilby H, Fensholt R, Proud S R. Automated Water Extraction Index: A New Technique for Surface Water Mapping Using Landsat Imagery. Remote Sensing of Environment, 2014, 140: 23-35. DOI: 10.1016/j.rse.2013.08.029.
[16] Qi J, Chehbouni A, Huete A R, Kerr Y H, Sorooshian S. A Modified Soil Adjusted Vegetation Index. Remote Sensing of Environment, 1994, 48(2): 119-126. DOI: 10.1016/0034-4257(94)90134-1.
[17] Gao B C. NDWI - A Normalized Difference Water Index for Remote Sensing of Vegetation Liquid Water from Space. Remote Sensing of Environment, 1996, 58(3): 257-266. DOI: 10.1016/S0034-4257(96)00067-3.
[18] Haralick R M, Shanmugam K, Dinstein I. Textural Features for Image Classification. IEEE Transactions on Systems, Man, and Cybernetics, 1973, SMC-3(6): 610-621. DOI: 10.1109/TSMC.1973.4309314.
[19] Breiman L. Random Forests. Machine Learning, 2001, 45(1): 5-32. DOI: 10.1023/A:1010933404324.
[20] Friedman J H. Greedy Function Approximation: A Gradient Boosting Machine. The Annals of Statistics, 2001, 29(5): 1189-1232. DOI: 10.1214/AOS/1013203451.
[21] Chen T, Guestrin C. XGBoost: A Scalable Tree Boosting System. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 2016: 785-794. DOI: 10.1145/2939672.2939785.
[22] Ke G, Meng Q, Finley T, et al. LightGBM: A Highly Efficient Gradient Boosting Decision Tree. Advances in Neural Information Processing Systems, 2017, 30: 3146-3154.
[23] Prokhorenkova L, Gusev G, Vorobev A, Dorogush A V, Gulin A. CatBoost: Unbiased Boosting with Categorical Features. Advances in Neural Information Processing Systems, 2018, 31: 6638-6648.
[24] He K, Zhang X, Ren S, Sun J. Deep Residual Learning for Image Recognition. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2016: 770-778. DOI: 10.1109/CVPR.2016.90.
[25] Zou H, Hastie T. Regularization and Variable Selection via the Elastic Net. Journal of the Royal Statistical Society: Series B, 2005, 67(2): 301-320. DOI: 10.1111/j.1467-9868.2005.00503.x.
[26] Wold S, Sjostrom M, Eriksson L. PLS-Regression: A Basic Tool of Chemometrics. Chemometrics and Intelligent Laboratory Systems, 2001, 58(2): 109-130. DOI: 10.1016/S0169-7439(01)00155-1.
[27] Roberts D R, Bahn V, Ciuti S, et al. Cross-Validation Strategies for Data with Temporal, Spatial, Hierarchical, or Phylogenetic Structure. Ecography, 2017, 40(8): 913-929. DOI: 10.1111/ecog.02881.
[28] Lundberg S M, Lee S I. A Unified Approach to Interpreting Model Predictions. Advances in Neural Information Processing Systems, 2017, 30: 4765-4774.
[29] U.S. Geological Survey. Landsat Collection 2 Surface Reflectance [EB/OL]. https://www.usgs.gov/landsat-missions/landsat-collection-2-surface-reflectance (accessed 2026-07-17).
[30] U.S. Geological Survey. Landsat Collection 2 Surface Temperature [EB/OL]. https://www.usgs.gov/landsat-missions/landsat-collection-2-surface-temperature (accessed 2026-07-17).
[31] U.S. Geological Survey. How Do I Use a Scale Factor with Landsat Level-2 Science Products? [EB/OL]. https://www.usgs.gov/faqs/how-do-i-use-a-scale-factor-landsat-level-2-science-products (accessed 2026-07-17).
[32] U.S. Geological Survey. Landsat Collection 2 Quality Assessment Bands [EB/OL]. https://www.usgs.gov/landsat-missions/landsat-collection-2-quality-assessment-bands (accessed 2026-07-17).
[33] Senay G B, Bohms S, Singh R K, et al. Operational Evapotranspiration Mapping Using Remote Sensing and Weather Datasets: A New Parameterization for the SSEB Approach. Journal of the American Water Resources Association, 2013, 49(3): 577-591. DOI: 10.1111/jawr.12057.
[34] Senay G B. Satellite Psychrometric Formulation of the Operational Simplified Surface Energy Balance (SSEBop) Model for Quantifying and Mapping Evapotranspiration. Applied Engineering in Agriculture, 2018, 34(3): 555-566. DOI: 10.13031/aea.12614.
[35] Senay G B, Friedrichs M, Singh R K, Velpuri N M. Actual Evapotranspiration Modeling Using the Operational Simplified Surface Energy Balance (SSEBop) Approach. U.S. Geological Survey Scientific Investigations Report 2013-5126, 2013. DOI: 10.3133/sir20135126.
[36] Allen R G, Pereira L S, Raes D, Smith M. Crop Evapotranspiration: Guidelines for Computing Crop Water Requirements. FAO Irrigation and Drainage Paper 56. Rome: FAO, 1998.
[37] Rodell M, Houser P R, Jambor U, et al. The Global Land Data Assimilation System. Bulletin of the American Meteorological Society, 2004, 85(3): 381-394. DOI: 10.1175/BAMS-85-3-381.
[38] Achanta R, Shaji A, Smith K, Lucchi A, Fua P, Susstrunk S. SLIC Superpixels Compared to State-of-the-Art Superpixel Methods. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2012, 34(11): 2274-2282. DOI: 10.1109/TPAMI.2012.120.
[39] Felzenszwalb P F, Huttenlocher D P. Efficient Graph-Based Image Segmentation. International Journal of Computer Vision, 2004, 59(2): 167-181. DOI: 10.1023/B:VISI.0000022288.19776.77.
[40] Comaniciu D, Meer P. Mean Shift: A Robust Approach toward Feature Space Analysis. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2002, 24(5): 603-619. DOI: 10.1109/34.1000236.
[41] Vincent L, Soille P. Watersheds in Digital Spaces: An Efficient Algorithm Based on Immersion Simulations. IEEE Transactions on Pattern Analysis and Machine Intelligence, 1991, 13(6): 583-598. DOI: 10.1109/34.87344.
[42] Vedaldi A, Soatto S. Quick Shift and Kernel Methods for Mode Seeking. In: Computer Vision - ECCV 2008. Lecture Notes in Computer Science, vol. 5305: 705-718. DOI: 10.1007/978-3-540-88693-8_52.
[43] Openshaw S. The Modifiable Areal Unit Problem. Concepts and Techniques in Modern Geography 38. Norwich: Geo Books, 1984.
[44] Fotheringham A S, Wong D W S. The Modifiable Areal Unit Problem in Multivariate Statistical Analysis. Environment and Planning A, 1991, 23(7): 1025-1044. DOI: 10.1068/a231025.
[45] McGarigal K, Marks B J. FRAGSTATS: Spatial Pattern Analysis Program for Quantifying Landscape Structure. USDA Forest Service General Technical Report PNW-GTR-351, 1995.
[46] McGarigal K, Cushman S A, Ene E. FRAGSTATS v4: Spatial Pattern Analysis Program for Categorical and Continuous Maps. Amherst: University of Massachusetts, 2012.
[47] Shannon C E. A Mathematical Theory of Communication. Bell System Technical Journal, 1948, 27(3): 379-423. DOI: 10.1002/j.1538-7305.1948.tb01338.x.
[48] Jaeger J A G. Landscape Division, Splitting Index, and Effective Mesh Size: New Measures of Landscape Fragmentation. Landscape Ecology, 2000, 15(2): 115-130. DOI: 10.1023/A:1008129329289.
[49] Riitters K H, O’Neill R V, Hunsaker C T, et al. A Factor Analysis of Landscape Pattern and Structure Metrics. Landscape Ecology, 1995, 10(1): 23-39. DOI: 10.1007/BF00158551.
[50] Spearman C. The Proof and Measurement of Association between Two Things. The American Journal of Psychology, 1904, 15(1): 72-101. DOI: 10.2307/1412159.
[51] Kraskov A, Stogbauer H, Grassberger P. Estimating Mutual Information. Physical Review E, 2004, 69(6): 066138. DOI: 10.1103/PhysRevE.69.066138.
[52] Szekely G J, Rizzo M L, Bakirov N K. Measuring and Testing Dependence by Correlation of Distances. The Annals of Statistics, 2007, 35(6): 2769-2794. DOI: 10.1214/009053607000000505.
[53] Wang J F, Li X H, Christakos G, et al. Geographical Detectors-Based Health Risk Assessment and Its Application in the Neural Tube Defects Study of the Heshun Region, China. International Journal of Geographical Information Science, 2010, 24(1): 107-127. DOI: 10.1080/13658810802443457.
[54] Moran P A P. Notes on Continuous Stochastic Phenomena. Biometrika, 1950, 37(1/2): 17-23. DOI: 10.2307/2332142.
[55] Fotheringham A S, Yang W, Kang W. Multiscale Geographically Weighted Regression (MGWR). Annals of the American Association of Geographers, 2017, 107(6): 1247-1265. DOI: 10.1080/24694452.2017.1352480.
[56] LeSage J, Pace R K. Introduction to Spatial Econometrics. Boca Raton: CRC Press, 2009. DOI: 10.1201/9781420064254.
[57] Matheron G. Principles of Geostatistics. Economic Geology, 1963, 58(8): 1246-1266. DOI: 10.2113/gsecongeo.58.8.1246.
[58] Kendall M G. A New Measure of Rank Correlation. Biometrika, 1938, 30(1/2): 81-93. DOI: 10.1093/biomet/30.1-2.81.
[59] Schwarz G. Estimating the Dimension of a Model. The Annals of Statistics, 1978, 6(2): 461-464. DOI: 10.1214/aos/1176344136.
[60] Pearl J. Probabilistic Reasoning in Intelligent Systems: Networks of Plausible Inference. San Francisco: Morgan Kaufmann, 1988.
[61] Koller D, Friedman N. Probabilistic Graphical Models: Principles and Techniques. Cambridge: MIT Press, 2009.
[62] Chickering D M. Optimal Structure Identification with Greedy Search. Journal of Machine Learning Research, 2002, 3: 507-554.
[63] Lin J. Divergence Measures Based on the Shannon Entropy. IEEE Transactions on Information Theory, 1991, 37(1): 145-151. DOI: 10.1109/18.61115.
文献依据按软件当前实现组织,覆盖地理数据标准与开发框架、Landsat 官方产品、光谱指数、图像分割、机器学习、景观格局与尺度效应、空间统计及概率图模型。所有条目均对应正文方法或工程依赖;在线资料统一注明最近访问日期。
附录 A 公式与数学表达目录
本附录对应用内文档及项目代码中的数学表达进行去重、规范和实现核对。显示公式目录按方法链排列,每条保留编号、依据代码输出键、方法注册名或类/函数语义确定的具体指数或方法名称、规范化公式,并说明理论依据、变量作用、实现方式和结果判读;同一公式联合定义多个直接相关量时,并列保留相应代码键。行内表达作为符号与短式索引收录。方法的完整输入、输出和适用语义在正文相应章节说明,质量控制、单位、阈值和实现约束继续保留专门注释。
A.1 显示公式目录
平台总览与模块导航
A-001 平台数据处理与分析链
\[\text{原始数据} \rightarrow \text{预处理与对齐} \rightarrow \text{样本/特征生成} \rightarrow \text{关系或模型计算} \rightarrow \text{空间输出与回显}\]
**理论与方法:**该链条概括软件从原始空间数据到可回写成果的总体处理顺序,箭头表示数据、参数和空间基准逐阶段传递。**实现与判读:**每一阶段的输出均作为下一阶段的显式输入,并通过路径、元数据和清单维持可追溯性;它是系统流程表达,不是数值指数。
地图工作台(Leaflet × Qt × Dock)
A-002 Web 地图交互桥接链
\[\text{Qt Widget} \leftrightarrow \text{QWebEngineView} \leftrightarrow \text{HTML/JS Map} \leftrightarrow \text{QWebChannel} \leftrightarrow \text{Python Bridge}\]
**理论与方法:**该式描述 Qt 桌面界面与网页地图之间的双向消息链,双向箭头表示 Python 与 JavaScript 均可发起状态同步。**实现与判读:**QWebChannel 暴露桥接对象,地图事件返回 Python,Python 的图层、视图和选择命令再传入 Leaflet 页面,由此实现桌面控件与地图交互一致。
数据管理与质量控制
A-003 文件—索引—预览协同数据管理模型
\[\text{文件系统} + \text{索引数据库} + \text{可视化预览}\]
**理论与方法:**文件系统保存原始数据和成果,SQLite 索引保存可查询元数据,可视化预览负责空间核查,三者共同构成数据管理模型。**实现与判读:**数据库不替代栅格或矢量文件,而是记录其位置、类型和检索字段;预览始终回到原文件或其轻量载荷。
按数据类型检索
A-004 数据目录检索与预览数据流
\[\text{目录} \rightarrow \text{InventoryWorker} \rightarrow \text{inventory.csv / grouped\_info} \rightarrow \text{分类展示} \rightarrow \text{预览载荷} \rightarrow \text{预览组件}\]
**理论与方法:**该数据流从目录扫描开始,经后台清单生成、分组索引和分类展示,最终形成地图或表格可消费的预览载荷。**实现与判读:**InventoryWorker 避免扫描阻塞界面,inventory.csv 与 grouped_info 承担阶段交换,预览组件只读取已解析的标准化记录。
数据生产总览
A-005 遥感专题产品生产链
\[\text{观测影像} \rightarrow \text{特征构建} \rightarrow \text{模型学习/反演} \rightarrow \text{专题产品}\]
**理论与方法:**观测影像首先转换为可解释特征,再由统计、机器学习或反演方法形成专题产品。**实现与判读:**该链条用于界定土地覆盖、地表温度和蒸散发等产品的共同方法结构;不同产品在特征、模型和质量控制上分别实现。
Landsat -> 土地覆盖(LC)
A-006 归一化植被指数(NDVI / ndvi)
\[NDVI = \frac{\rho_{NIR} - \rho_{RED}}{\rho_{NIR} + \rho_{RED}}\]
**理论与方法:**NDVI 利用健康植被在红光强吸收、近红外强反射的差异,归一化后通常随绿色植被覆盖和活力增加而升高。**实现与判读:**代码输出键为 ndvi;本组比值指数统一通过安全除法处理近零分母,无效值写为 NaN。高覆盖区可能饱和,裸土背景强时应与 SAVI、MSAVI2 等共同判断。
A-007 增强植被指数(EVI / evi)
\[EVI = 2.5 \cdot \frac{\rho_{NIR} - \rho_{RED}}{\rho_{NIR} + 6\rho_{RED} - 7.5\rho_{BLUE} + 1}\]
**理论与方法:**EVI 在 NDVI 的红光—近红外差异基础上加入蓝光大气校正项及增益 2.5,降低气溶胶、土壤背景和高生物量饱和的影响。**实现与判读:**代码键为 evi,系数 6、7.5 和常数 1 按公式固定;其结果适于高覆盖植被,但对波段定标和蓝波段噪声更敏感。
A-008 双波段增强植被指数(EVI2 / evi2)
\[EVI2 = 2.5 \cdot \frac{\rho_{NIR} - \rho_{RED}}{\rho_{NIR} + 2.4\rho_{RED} + 1}\]
**理论与方法:**EVI2 是不使用蓝波段的双波段增强植被指数,以 2.4 倍红光项近似 EVI 的背景校正。**实现与判读:**代码键为 evi2,适用于蓝波段缺失或质量较差的影像;解释仍以植被增强为主,但数值不可与 EVI 在所有场景下直接等同。
A-009 土壤调节植被指数(SAVI / savi)
\[SAVI = \frac{(1 + L)\,(\rho_{NIR} - \rho_{RED})}{\rho_{NIR} + \rho_{RED} + L}\]
**理论与方法:**SAVI 在 NDVI 分子外乘以 1+L,并在分母加入土壤调节因子 L,以削弱稀疏植被条件下土壤亮度的影响。**实现与判读:**代码键为 savi,应用文档采用 L=0.5;L 越大,土壤校正越强,使用其他 L 时应在成果元数据中记录。
A-010 优化土壤调节植被指数(OSAVI / osavi)
\[OSAVI = (1 + 0.16) \cdot \frac{\rho_{NIR} - \rho_{RED}}{\rho_{NIR} + \rho_{RED} + 0.16}\]
**理论与方法:**OSAVI 将土壤调节项固定为 0.16,在保持归一化红光—近红外差异的同时减少参数选择。**实现与判读:**代码键为 osavi,适合中低覆盖植被和区域批处理;其固定参数提高可复现性,但不保证对所有土壤类型最优。
A-011 修正土壤调节植被指数(MSAVI2 / msavi2)
\[MSAVI2 = \frac{2\rho_{NIR} + 1 - \sqrt{(2\rho_{NIR} + 1)^{2} - 8(\rho_{NIR} - \rho_{RED})}}{2}\]
**理论与方法:**MSAVI2 通过含平方根的自调节形式,根据红光和近红外响应自动减弱土壤背景,不再显式指定 L。**实现与判读:**代码键为 msavi2;根号内项和分母由实现做有限值检查,适合干旱、裸地干扰明显和植被稀疏区域。
A-012 抗大气植被指数(ARVI / arvi)
\[ARVI = \frac{\rho_{NIR} - (2\rho_{RED} - \rho_{BLUE})}{\rho_{NIR} + (2\rho_{RED} - \rho_{BLUE})}\]
**理论与方法:**ARVI 以 2ρ_RED−ρ_BLUE 构造大气校正后的红光项,减弱气溶胶对植被指数的影响。**实现与判读:**代码键为 arvi;当蓝波段噪声较高或存在薄雾时需同时检查原始波段质量,不能把大气校正项视为完整的大气校正流程。
A-013 绿光归一化植被指数(GNDVI / gndvi)
\[GNDVI = \frac{\rho_{NIR} - \rho_{GREEN}}{\rho_{NIR} + \rho_{GREEN}}\]
**理论与方法:**GNDVI 用绿光替代红光与近红外构成归一化差异,对叶绿素和植被氮素变化更敏感。**实现与判读:**代码键为 gndvi;它可补充 NDVI 的冠层活力信息,但受绿光反射、背景和传感器定标影响,宜与 NDVI、EVI 联合使用。
A-014 归一化差异水分指数(NDMI / ndmi)
\[NDMI = \frac{\rho_{NIR} - \rho_{SWIR1}}{\rho_{NIR} + \rho_{SWIR1}}\]
**理论与方法:**NDMI 利用近红外与 SWIR1 对冠层含水量的不同响应,值增大通常表示植被或地表含水状态增强。**实现与判读:**代码键为 ndmi;其含义不同于以绿光构造的 NDWI,干旱、扰动和湿地分析应结合地类与时相解释。
A-015 归一化差异水体指数(NDWI / ndwi)
\[NDWI = \frac{\rho_{GREEN} - \rho_{NIR}}{\rho_{GREEN} + \rho_{NIR}}\]
**理论与方法:**NDWI 以绿光和近红外的归一化差异增强开阔水体,因为水体在近红外反射很低。**实现与判读:**代码键为 ndwi;城市暗面和阴影可能产生混淆,建成区场景通常还需 MNDWI、AWEI 或 NDBI 交叉约束。
A-016 改进型归一化差异水体指数(MNDWI / mndwi)
\[MNDWI = \frac{\rho_{GREEN} - \rho_{SWIR1}}{\rho_{GREEN} + \rho_{SWIR1}}\]
**理论与方法:**MNDWI 用 SWIR1 替代 NDWI 的近红外项,利用水体在短波红外的强吸收抑制建筑和裸地背景。**实现与判读:**代码键为 mndwi;正值常作为水体候选,但阈值随区域、季节和定标变化,不能脱离样本核查固定使用。
A-017 阴影型自动水体提取指数(AWEI_SH / awei_sh)
\[AWEI_{SH} = \rho_{BLUE} + 2.5\rho_{GREEN} - 1.5(\rho_{NIR} + \rho_{SWIR1}) - 0.25\rho_{SWIR2}\]
**理论与方法:**AWEI_SH 通过蓝、绿、近红外和两个短波红外波段的线性组合增强水体,并专门抑制阴影造成的假水体。**实现与判读:**代码键为 awei_sh,系数按公式固定;适于山地或城市阴影场景,结果仍应与 MNDWI 和空间连通性共同复核。
A-018 非阴影型自动水体提取指数(AWEI_NSH / awei_nsh)
\[AWEI_{NSH} = 4(\rho_{GREEN} - \rho_{SWIR1}) - (0.25\rho_{NIR} + 2.75\rho_{SWIR2})\]
**理论与方法:**AWEI_NSH 是面向非阴影场景的自动水体提取指数,强化绿光与 SWIR1 的水体差异,同时用近红外和 SWIR2 抑制非水体。**实现与判读:**代码键为 awei_nsh;其适用情景与 AWEI_SH 不同,二者不应在未说明场景时混用同一阈值。
A-019 水比指数(WRI / wri)
\[WRI = \frac{\rho_{GREEN} + \rho_{RED}}{\rho_{NIR} + \rho_{SWIR1}}\]
**理论与方法:**WRI 以绿光和红光反射之和除以近红外与 SWIR1 之和,利用水体在长波段反射低的特征形成比值。**实现与判读:**代码键为 wri;较高值偏向水体或湿润地表,但浅滩、浑水和阴影需结合其他指数判断。
A-020 归一化差异水体辅助指数(NDPI / ndpi)
\[NDPI = \frac{\rho_{SWIR1} - \rho_{GREEN}}{\rho_{SWIR1} + \rho_{GREEN}}\]
**理论与方法:**NDPI 按当前代码定义为 SWIR1 与绿光的归一化差异,用于补充水体、阴影和建成背景的分离。**实现与判读:**代码键为 ndpi;本报告严格采用代码公式,不按名称外推其他文献中的同名变体,后续 DBSI 直接使用该结果。
A-021 归一化差异建成区指数(NDBI / ndbi)
\[NDBI = \frac{\rho_{SWIR1} - \rho_{NIR}}{\rho_{SWIR1} + \rho_{NIR}}\]
**理论与方法:**NDBI 利用建成区在 SWIR1 相对近红外反射较高的特征,正值通常增强不透水面和建筑。**实现与判读:**代码键为 ndbi;裸地和亮土也可能取得高值,需与 NDVI、MNDWI、BSI 或分类样本联合判读。
A-022 城市指数(UI / ui)
\[UI = NDBI - NDVI\]
**理论与方法:**UI 由 NDBI 减去 NDVI,将建成增强与植被抑制叠加到同一尺度,从而强化城市—植被对比。**实现与判读:**代码键为 ui,先按同一影像计算 NDBI 和 NDVI 再作差;较大值偏向建成地表,但水体和裸地仍需额外约束。
A-023 基于指数的建成区指数(IBI / ibi)
\[IBI = \frac{NDBI - \frac{NDVI + MNDWI}{2}}{NDBI + \frac{NDVI + MNDWI}{2}}\]
**理论与方法:**IBI 将 NDBI 与 NDVI、MNDWI 的平均背景进行归一化对比,同时抑制植被与水体并突出建成区。**实现与判读:**代码键为 ibi;该复合指数继承三个基础指数的误差,分母近零时按安全除法置为无效。
A-024 干旱裸地指数(DBSI / dbsi)
\[DBSI = NDPI - NDVI\]
**理论与方法:**DBSI 在当前实现中定义为 NDPI−NDVI,用水体/干燥背景差异与植被强度的反差突出裸地、干旱或盐碱地表。**实现与判读:**代码键为 dbsi;正负方向依赖两个基础指数,解释时应同时查看 NDPI 与 NDVI。
A-025 裸土指数(BSI / bsi)
\[BSI = \frac{(\rho_{SWIR1} + \rho_{RED}) - (\rho_{NIR} + \rho_{BLUE})}{(\rho_{SWIR1} + \rho_{RED}) + (\rho_{NIR} + \rho_{BLUE})}\]
**理论与方法:**BSI 比较 SWIR1+红光与近红外+蓝光两组反射,前者占优时通常指向裸土或明亮干燥地表。**实现与判读:**代码键为 bsi;建筑和裸地可能重叠,宜与 NDBI、NDVI 和纹理特征共同使用。
A-026 归一化燃烧指数(NBR / nbr)
\[NBR = \frac{\rho_{NIR} - \rho_{SWIR2}}{\rho_{NIR} + \rho_{SWIR2}}\]
**理论与方法:**NBR 以近红外和 SWIR2 的归一化差异表征植被含水与烧毁/扰动响应,火烧后近红外降低、SWIR2 增强通常使 NBR 下降。**实现与判读:**代码键为 nbr;单时相值用于状态判别,变化检测应明确差分方向。
A-027 归一化燃烧指数 2(NBR2 / nbr2)
\[NBR2 = \frac{\rho_{SWIR1} - \rho_{SWIR2}}{\rho_{SWIR1} + \rho_{SWIR2}}\]
**理论与方法:**NBR2 使用 SWIR1 与 SWIR2 的归一化差异,对地表水分、干旱和烧毁后状态敏感。**实现与判读:**代码键为 nbr2;它与 NBR 的波段和物理含义不同,通常作为扰动和干湿程度的补充而非替代。
A-028 归一化差异雪指数(NDSI / ndsi)
\[NDSI = \frac{\rho_{GREEN} - \rho_{SWIR1}}{\rho_{GREEN} + \rho_{SWIR1}}\]
**理论与方法:**NDSI 按当前代码用绿光和 SWIR1 构成归一化差异,利用雪在绿光较亮、SWIR 较暗的特征增强雪冰。**实现与判读:**代码键为 ndsi;其代数形式与 MNDWI 相同但目标语义不同,必须结合研究区、季节和其他波段区分雪与水体。
A-029 坡度(slope)
\[\text{slope} = arctan\left( \sqrt{(\partial z/\partial x)^{2} + (\partial z/\partial y)^{2}} \right) \times \frac{180}{\pi}\]
**理论与方法:**坡度由高程面在 x、y 方向的梯度模长经反正切转换为角度,反映地表最大倾斜程度。**实现与判读:**代码的 slope 采用 Horn 3×3 邻域求梯度并输出度;平坦区接近 0,边缘和 NoData 邻域按有效性规则处理。
A-030 坡向(aspect)
\[\begin{aligned} g_{x} & = \partial z/\partial x,\quad\quad g_{y} = \partial z/\partial y, \\ \theta & = deg\left\lbrack atan2(g_{y}, - g_{x}) \right\rbrack, \\ aspect & = \left\{ \begin{matrix} 90^{\circ} - \theta, & \theta < 0, \\ 450^{\circ} - \theta, & \theta \geq 0, \end{matrix} \right.\ \quad aspect \in \lbrack 0^{\circ},360^{\circ}). \end{aligned}\]
**理论与方法:**坡向由高程梯度的 atan2 方向计算,并通过分段换算统一到 0°–360°。**实现与判读:**代码键为 aspect,角度表示坡面朝向;近水平像元方向不稳定,应与坡度阈值结合使用而不单独解释。
A-031 地形位置指数(TPI)
\[TPI = z_{0} - \frac{1}{\mathcal{|N\backslash\{}z_{0}\}|}\sum_{z_{i}\mathcal{\in N\backslash\{}z_{0}\}}^{}z_{i}\]
**理论与方法:**TPI 以中心高程减去邻域平均高程,正值倾向脊部或凸起,负值倾向谷地或洼地。**实现与判读:**代码键为 TPI,邻域窗口决定分析尺度;跨窗口比较时必须记录窗口大小和高程预处理方式。
A-032 地形粗糙度指数(TRI)
\[TRI(z_{0}) = \sqrt{\sum_{z_{i}\mathcal{\in N\backslash\{}z_{0}\}}^{}\left( z_{i} - z_{0} \right)^{2}}\]
**理论与方法:**TRI 汇总中心像元与邻域高程差的平方并开方,表示局部起伏或崎岖程度。**实现与判读:**代码键为 TRI;值越大说明地形变化越强,结果随像元分辨率和窗口范围变化,不能跨尺度直接比较。
A-033 地形曲率(curvature)
\[curv \approx \frac{\partial^{2}z}{\partial x^{2}} + \frac{\partial^{2}z}{\partial y^{2}}\]
**理论与方法:**曲率以高程对 x、y 的二阶导数之和近似,描述地表由凸到凹的变化趋势。**实现与判读:**代码键为 curvature;正负号取决于离散算子约定,解释时应以本软件输出说明为准,并注意二阶导数对噪声敏感。
A-034 局部地形起伏度(roughness)
\[roughness(z_{0}) = \max_{z_{i}\mathcal{\in N\backslash\{}z_{0}\}}\left| z_{i} - z_{0} \right|\]
**理论与方法:**roughness 取中心像元与邻域高程差绝对值的最大值,强调窗口内最强局部起伏。**实现与判读:**代码键为 roughness;它对极端像元较敏感,适合识别陡坎和破碎地形,必要时结合 TRI、VRM 复核。
A-035 向量粗糙度量(VRM)
\[\text{设单位法向量 }\mathbf{n}(x,y) = (n_{x},n_{y},n_{z}),\ \overline{\mathbf{n}} = \frac{1}{\mathcal{|N|}}\sum_{\mathcal{N}}^{}\mathbf{n},\ VRM = 1 - \parallel \overline{\mathbf{n}} \parallel\]
**理论与方法:**VRM 先把局部坡面表示为单位法向量,再以平均法向量长度偏离 1 的程度衡量方向离散;平行法向量产生接近 0 的粗糙度。**实现与判读:**代码键为 VRM,值越大表示坡面方向越杂乱;窗口和 NoData 处理会改变结果。
A-036 地形湿度指数(TWI)
\[TWI = ln(a) - ln(tan\beta)\]
**理论与方法:**TWI 将单位等高线汇水面积 a 与坡度 β 组合,较大汇水面积和较缓坡度产生较高湿润潜势。**实现与判读:**代码键为 TWI,当前为简化 D8 水文实现;对近零坡度、洼地和边界需做数值保护,结果表示地形湿润倾向而非实测土壤水分。
A-037 距最近排水高程(HAND)
\[HAND = z - \widetilde{z},\quad\widetilde{z} = \text{沿 D8 至最近满足 acc} \geq \tau\text{ 的河段的“河床高程”}\]
**理论与方法:**HAND 以像元高程减去沿 D8 流向追踪到的最近排水像元高程,表示相对河网的垂向高度。**实现与判读:**代码键为 HAND,河网由汇流累积阈值 τ 确定;较低值常指向洪泛或湿润潜势,但阈值和 DEM 水文质量决定可靠性。
A-038 GLCM 归一化共生概率(P(i,j;d,θ))
\[P(i,j;d,\theta) = \frac{1}{Z}\#\{(x,y\mathcal{) \in N \mid}G(x,y) = i,\ G(x + \Delta x,y + \Delta y) = j\},\]
**理论与方法:**P(i,j;d,θ) 是给定距离 d、方向 θ 时灰度 i 与 j 成对出现次数除以总对数 Z 的归一化概率。**实现与判读:**代码先在窗口内量化灰度并构造对称、归一化 GLCM;它是后续纹理指标的共同概率基础,不是独立地物类别指数。
A-039 GLCM 对比度(contrast)
\[contrast = \sum_{i = 0}^{L - 1}{\sum_{j = 0}^{L - 1}(}i - j)^{2}\, P(i,j)\]
**理论与方法:**GLCM 对比度以灰度差平方加权共生概率,远离主对角线的灰度对贡献更大。**实现与判读:**代码输出键为 contrast;高值表示局部反差或边界强,低值表示纹理平缓,结果依赖量化级、窗口、距离和方向。
A-040 GLCM 差异度(dissimilarity)
\[dissimilarity = \sum_{i,j}^{}|i - j|\, P(i,j)\]
**理论与方法:**GLCM 差异度以灰度差绝对值加权概率,相比对比度对大灰度差的放大较弱。**实现与判读:**代码输出键为 dissimilarity;其值反映平均局部差异,适合与 contrast 对照识别强边界和一般异质性。
A-041 GLCM 同质度(homogeneity)
\[homogeneity = \sum_{i,j}^{}\frac{P(i,j)}{1 + (i - j)^{2}}\]
**理论与方法:**GLCM 同质度对主对角线附近的共生对赋予较高权重,灰度越相近贡献越大。**实现与判读:**代码输出键为 homogeneity;均一水体或规则地表通常较高,复杂混合地物较低,但量化和窗口尺度会改变绝对值。
A-042 GLCM 角二阶矩与能量(ASM / energy)
\[ASM = \sum_{i,j}^{}P(i,j)^{2},\quad\quad energy = \sqrt{ASM}\]
**理论与方法:**ASM 是共生概率平方和,概率集中时增大;energy 为 ASM 的平方根,两者均度量纹理规则性。**实现与判读:**代码分别输出 ASM 和 energy;二者单调相关,不宜同时作为大量高度冗余特征而不做筛选。
A-043 GLCM 熵(entropy)
\[entropy = - \sum_{i,j:P(i,j) > 0}^{}P(i,j)\log_{2}P(i,j)\]
**理论与方法:**GLCM 熵以共生概率的负对数期望度量不确定性,概率分布越分散、纹理越复杂,熵越高。**实现与判读:**代码输出键为 entropy,并忽略零概率项避免 log(0);其底数和量化设置必须保持一致后才能比较。
A-044 GLCM 相关性(correlation)
\[correlation = \frac{\sum_{i,j}^{}(i - \mu_{i})(j - \mu_{j})P(i,j)}{\sigma_{i}\sigma_{j}},\quad\mu_{i} = \sum_{i}^{}i\, p_{i},\ \ p_{i} = \sum_{j}^{}P(i,j)\]
**理论与方法:**GLCM 相关性以行列灰度偏差的协方差除以标准差,描述邻接灰度的线性依赖。**实现与判读:**代码输出键为 correlation;接近正向高值表示灰度随空间关系一致变化,方差近零时需按实现的数值保护解释。
A-045 GLCM 灰度均值、方差与标准差(glcm_mean / glcm_var / glcm_std)
\[\mu = \sum_{i,j}^{}g\, P(i,j),\quad var = \sum_{i,j}^{}(g - \mu)^{2}P(i,j),\quad std = \sqrt{max(var,0)}.\]
**理论与方法:**该式把共生对映射为局部平均灰度 g 的分布,并计算其均值、方差和标准差,补充经典纹理的亮度与离散信息。**实现与判读:**代码键为 glcm_mean、glcm_var、glcm_std;它们受原始指数尺度影响,跨指标比较前应标准化。
A-046 GLRLM 短游程强调(glrlm_sre)
\[SRE = \frac{\sum_{r}^{}\frac{p_{r}}{r^{2}}}{N_{r}}\]
**理论与方法:**GLRLM 短游程强调以 1/r² 加权游程长度分布,短游程多时取值升高,反映细碎纹理。**实现与判读:**代码键为 glrlm_sre;同一灰度量化、方向和窗口下才可比较,常用于识别破碎边界或细颗粒结构。
其中,\(R(g,r)\) 表示灰度级 g、游程长度 r 对应的灰度游程矩阵元素;本组指标在同一矩阵及归一化约定下计算。
A-047 GLRLM 长游程强调(glrlm_lre)
\[LRE = \frac{\sum_{r}^{}p_{r}\, r^{2}}{N_{r}}\]
**理论与方法:**GLRLM 长游程强调以 r² 放大长游程贡献,连续同灰度结构越长,指标越高。**实现与判读:**代码键为 glrlm_lre;均一水面、规则条带或大斑块可能较高,应与 SRE 和方向设置联合解释。
A-048 GLRLM 灰度级非均匀性(glrlm_gln)
\[GLN = \frac{\sum_{g}^{}p_{g}^{2}}{N_{r}}\]
**理论与方法:**GLRLM 灰度级非均匀性对各灰度级游程总量平方求和并按总游程归一化,衡量游程是否集中于少数灰度。**实现与判读:**代码键为 glrlm_gln;值高表示灰度组成不均衡,不等同于空间游程长度不均衡。
A-049 GLRLM 游程长度非均匀性(glrlm_rln)
\[RLN = \frac{\sum_{r}^{}p_{r}^{2}}{N_{r}}\]
**理论与方法:**GLRLM 游程长度非均匀性对各长度游程总量平方求和,衡量游程是否集中于少数长度。**实现与判读:**代码键为 glrlm_rln;值高表示尺度结构单一或某些长度占优,与 GLN 描述的维度不同。
A-050 GLRLM 游程百分比(glrlm_rp)
\[RP = \frac{N_{r}}{N_{p}}\]
**理论与方法:**游程百分比 RP 用总游程数除以有效像元数,反映单位像元产生游程的频繁程度。**实现与判读:**代码键为 glrlm_rp;细碎纹理通常游程多、RP 较高,长连续结构通常较低。
A-051 局部二值模式编码(LBP)
\[{LBP}_{P,R} = \sum_{p = 0}^{P - 1}s(g_{p} - g_{c})\, 2^{p},\quad s(x) = \left\{ \begin{matrix} 1, & x \geq 0 \\ 0, & x < 0 \end{matrix} \right.\ \]
**理论与方法:**LBP 将中心像元与 P 个邻点比较,邻点不小于中心记为 1,并按 2^p 组合为局部二值模式编码。**实现与判读:**代码按半径 R 和点数 P 生成 LBP 图,再统计直方图;该指标强调局部微结构,对单调灰度变化较稳健。
A-052 LBP 均值与标准差(lbp_mean / lbp_std)
\[mean = \sum_{k}^{}k\, p_{k},\quad\quad std = \sqrt{\sum_{k}^{}(k - mean)^{2}p_{k}}\]
**理论与方法:**LBP 均值和标准差由模式编码直方图的概率分布计算,分别反映典型模式水平与模式离散程度。**实现与判读:**代码键为 lbp_mean、lbp_std;编码范围受 P 和 method 影响,跨配置比较必须保持参数一致。
A-053 LBP 熵(lbp_entropy)
\[entropy = - \sum_{k}^{}p_{k}\log p_{k}\]
**理论与方法:**LBP 熵对模式直方图计算信息熵,模式类型越多且分布越均衡,值越高。**实现与判读:**代码键为 lbp_entropy,零频率项不参与对数;它适合描述微纹理复杂度,但不直接给出边界方向。
A-054 LBP 均匀模式比例(lbp_uniform_ratio)
\[uniform\_ ratio = \frac{\sum_{k\mathcal{\in U}}^{}H(k)}{\sum_{k}^{}H(k)}\]
**理论与方法:**LBP 均匀模式比例以 uniform 模式的频数除以全部模式频数,衡量局部模式由少量位跳变构成的程度。**实现与判读:**代码键为 lbp_uniform_ratio;method=uniform 时含义最明确,值高通常对应较规则的局部纹理。
A-055 时相差分(*_diff;后时相−前时相)
\[\Delta I \equiv I_{t_{2}} - I_{t_{1}}.\]
**理论与方法:**通用时相差分把后时相指数减去前时相指数,显式表示变化方向与幅度。**实现与判读:**代码输出采用 *_diff 命名并固定“后−前”;正负含义必须由具体指数决定,不能把所有正值统一解释为改善。
A-056 归一化燃烧指数时相差分(dNBR)
\[dNBR = NBR_{post} - NBR_{pre}\ \Rightarrow \ \text{火烧/强扰动} \Rightarrow dNBR \ll 0.\]
**理论与方法:**dNBR 在本软件中定义为 NBR_post−NBR_pre,因此典型火烧或强扰动造成 NBR 降低时表现为显著负值。**实现与判读:**该方向与部分文献采用的 pre−post 相反;输出、图例和阈值必须按当前代码方向解释。
A-057 时序方差(var)
\[Var(X)\mspace{6mu} = \mspace{6mu}\mathbb{E}\left\lbrack X^{2} \right\rbrack - \left( \mathbb{E\lbrack}X\rbrack \right)^{2}\mspace{6mu} = \mspace{6mu}\frac{1}{n}\sum_{t = 1}^{n}X_{t}^{2}\mspace{6mu} - \mspace{6mu}\left( \frac{1}{n}\sum_{t = 1}^{n}X_{t} \right)^{2},\quad n \geq 2.\]
**理论与方法:**时序方差以 E[X²]−E[X]² 计算像元在多个时相的波动强度,仅在有效时相数 n≥2 时成立。**实现与判读:**代码忽略 NaN 并对浮点误差导致的微小负方差做保护;高值表示时序变化大,不直接说明变化方向。
A-058 时序极差(range)
\[Range(X)\mspace{6mu} = \mspace{6mu}\max_{t}X_{t}\mspace{6mu} - \mspace{6mu}\min_{t}X_{t},\]
**理论与方法:**时序极差是所有有效时相最大值减最小值,描述时间包络宽度。**实现与判读:**代码键为 range;它易受单个异常时相影响,宜与方差、有效时相数和质量掩膜共同判断。
A-059 时序峰值时相索引(max_t)
\[t^{*} = \underset{t}{arg\, max}X_{t}\]
**理论与方法:**max_t 返回指数取得最大值的时相位置,描述峰值相位而非峰值大小。**实现与判读:**代码键为 max_t,索引含义取决于输入文件顺序;用于季节过程前必须保存时相—索引对应表。
A-060 空间窗口均值(mean)
\[mean(X) = \frac{1}{\mathcal{|N|}}\sum_{x\mathcal{\in N}}^{}x\]
**理论与方法:**空间窗口均值对邻域内有效像元求算术平均,表示局地中心水平并平滑像元噪声。**实现与判读:**代码键为 mean,输出命名遵循 {index}_mean_w{win};窗口越大,局地细节越弱、区域背景越强。
A-061 空间窗口标准差(std)
\[std(X) = \sqrt{\frac{1}{\mathcal{|N|}}\sum_{x}^{}(x - \bar{x})^{2}}\]
**理论与方法:**空间窗口标准差采用总体标准差度量邻域内数值离散程度,反映局部异质性。**实现与判读:**代码键为 std;建成区或边界常较高,均一水体常较低,但其绝对值保留原指数的量纲。
A-062 空间窗口中位数(median)
\[median = {Quantile}_{0.5}(X)\]
**理论与方法:**空间窗口中位数是 0.5 分位数,对少量极端值比均值更稳健。**实现与判读:**代码键为 median;它适合云残留、异常亮斑或椒盐噪声存在时描述局地典型水平。
A-063 空间窗口中位绝对偏差(mad)
\[mad = median(|x - median(X)|)\]
**理论与方法:**MAD 是各像元偏离窗口中位数绝对值的中位数,提供稳健离散度。**实现与判读:**代码键为 mad;与 std 对照可识别离散度是否主要由少量异常值驱动。
A-064 空间窗口四分位距(iqr)
\[iqr = Q_{0.75}(X) - Q_{0.25}(X)\]
**理论与方法:**IQR 为 75% 分位数与 25% 分位数之差,描述中间 50% 数据的跨度。**实现与判读:**代码键为 iqr;它不受分布尾部强烈影响,适合比较局部稳定性与类内混合程度。
A-065 空间窗口最小值、最大值与极差(min / max / range)
\[min(X),\ max(X),\ range = max - min\]
**理论与方法:**min、max 分别给出窗口下界和上界,range=max−min 表示全幅离散跨度。**实现与判读:**代码分别输出 min、max、range;三者对极端值敏感,应结合中位数、IQR 和有效像元比例使用。
A-066 空间窗口第 10 与第 90 百分位数(p10 / p90)
\[Q_{0.10}(X),\ Q_{0.90}(X)\]
**理论与方法:**p10 与 p90 给出窗口分布的低端和高端稳健分位,用于刻画尾部而不直接采用极值。**实现与判读:**代码输出 p10、p90;二者差值可表示稳健范围,但当前公式条目保留为两个独立输出键。
A-067 空间窗口变异系数(coefvar)
\[coefvar = \frac{std}{mean}\]
**理论与方法:**变异系数以标准差除以均值,表达相对离散程度,便于比较不同平均水平的窗口。**实现与判读:**代码键为 coefvar;均值接近零时比值不稳定,需遵循实现的有限值与分母保护,不能机械比较。
A-068 空间窗口偏度(skew)
\[skew = \mathbb{E}\left\lbrack \left( \frac{x - \mu}{\sigma} \right)^{3} \right\rbrack\]
**理论与方法:**偏度是三阶标准化中心矩,正值表示右侧长尾,负值表示左侧长尾。**实现与判读:**代码键为 skew;它可区分亮尖峰与暗尖峰,但对小样本和异常值敏感。
A-069 空间窗口超额峰度(kurt)
\[kurt = \mathbb{E}\left\lbrack \left( \frac{x - \mu}{\sigma} \right)^{4} \right\rbrack - 3\]
**理论与方法:**kurt 采用四阶标准化中心矩减 3,因而正态分布基准为 0,反映尾部厚度和尖峭程度。**实现与判读:**代码键为 kurt;窗口有效样本不足或方差接近零时不宜解释。
A-070 空间窗口直方图熵(hist_entropy)
\[hist\_ entropy = - \sum_{b = 1}^{B}p_{b}\log p_{b}\]
**理论与方法:**直方图熵把窗口数值离散到 B 个箱后计算概率熵,表示分布复杂度。**实现与判读:**代码键为 hist_entropy,箱数由 hist_entropy_bins 配置;跨结果比较必须保持箱数和取值预处理一致。
A-071 Sobel 梯度幅值(G)
\[G = \sqrt{({Sobel}_{x}X)^{2} + ({Sobel}_{y}X)^{2}}\]
**理论与方法:**Sobel 梯度幅值合成 x、y 两方向离散梯度,突出局部边缘强度而不保留方向符号。**实现与判读:**代码先生成 G,再计算梯度统计;高值常对应道路、斑块边界或破碎纹理。
A-072 梯度中位数与四分位距(grad_median / grad_iqr)
\[grad\_ median = median(G),\quad grad\_ iqr = Q_{0.75}(G) - Q_{0.25}(G)\]
**理论与方法:**grad_median 表示窗口内典型梯度强度,grad_iqr 表示梯度分布的稳健离散度。**实现与判读:**两者均基于 Sobel 幅值;前者描述整体边缘水平,后者描述边缘强弱是否混杂。
A-073 GeoTransform 像元—地理坐标仿射变换
\[\begin{aligned} x_{\text{geo}} & = a \cdot \text{col} + b \cdot \text{row} + c, \\ y_{\text{geo}} & = d \cdot \text{col} + e \cdot \text{row} + f. \end{aligned}\]
**理论与方法:**GeoTransform 用六个仿射参数把栅格列、行坐标转换为地理坐标,允许像元大小、旋转和原点偏移。**实现与判读:**参数 a、b、c、d、e、f 来自栅格 transform;所有采样、掩膜和回写必须使用同一变换及 CRS。
A-074 浮点栅格至 int16 的缩放量化
\[y = clip\left( round(K\, x),\ - 32768,\ 32767 \right),\quad\text{dtype}(y) = \text{int16}.\]
**理论与方法:**缩放量化先以系数 K 放大浮点值、四舍五入,再裁剪到 int16 范围。**实现与判读:**该过程用于减小文件体积并保持约定精度;K、NoData 和反缩放规则必须写入元数据,否则整数值不能恢复原量纲。
A-075 多边形最小面积判据(A_min)
\[A\mathcal{(P)}\mspace{6mu} \geq \mspace{6mu} A_{\min},\]
**理论与方法:**最小面积判据要求多边形面积 A(P) 不低于 A_min,用于剔除不足以提供稳定像元样本的微小对象。**实现与判读:**面积在适当投影或像元面积单位下计算;阈值应结合分辨率和最小制图单元设置。
A-076 多边形紧凑度(Comp)
\[Comp(\mathcal{P)}\mspace{6mu} = \mspace{6mu}\frac{4\pi\, A\mathcal{(P)}}{\lbrack L\mathcal{(P)}\rbrack^{2}},\]
**理论与方法:**紧凑度以 4πA/L² 比较多边形面积与周长,圆形取 1,狭长或边界破碎形状趋近 0。**实现与判读:**A 为面积、L 为周长;该指标对锯齿边界和投影单位敏感,必须在一致坐标系中计算。
A-077 多边形紧凑度阈值判据(C_min)
\[Comp(\mathcal{P)}\mspace{6mu} \geq \mspace{6mu} C_{\min}.\]
**理论与方法:**紧凑度阈值判据要求 Comp(P)≥C_min,把几何规则性转换为样本保留条件。**实现与判读:**提高 C_min 会更严格地剔除狭长或破碎对象,但也可能误删真实线性地物,应与类别语义共同设定。
A-078 光谱一致性总体标准差(σ)
\[\sigma\mspace{6mu} = \mspace{6mu}\sqrt{\frac{1}{n}\sum_{i = 1}^{n}\left( x_{i} - \mu \right)^{2}},\quad\quad\mu = \frac{1}{n}\sum_{i = 1}^{n}x_{i}.\]
**理论与方法:**光谱一致性以多边形内部像元的总体标准差 σ 衡量同质性,σ 越小表示样本内部越一致。**实现与判读:**均值 μ 和 ddof=0 标准差按有效像元计算;不同指数必须使用各自阈值,不能直接共享同一数值界限。
A-079 稳定性最大绝对值判据(max|z_j|)
\[\max_{j}|z_{j}|\mspace{6mu} \leq \mspace{6mu}\theta.\]
**理论与方法:**稳定性判据要求所选变化或离散字段的最大绝对值不超过 θ,从而筛除跨时相或尺度波动过大的样本。**实现与判读:**各字段应先具有可比较量纲或使用分位阈值;θ 越小,样本越稳定但覆盖率越低。
A-080 样本几何紧凑度(Comp)
\[Comp(\mathcal{P) =}\frac{4\pi A\mathcal{(P)}}{\left\lbrack L\mathcal{(P)} \right\rbrack^{2}},\quad Comp \in (0,1\rbrack.\]
**理论与方法:**该式再次给出样本过滤阶段使用的几何紧凑度,明确取值位于 (0,1]。**实现与判读:**它与 A-076 的数学定义相同,但此处对应 polygon_sample_filter 的正式过滤输出和 geometry_quality_score 语义。
A-081 样本光谱一致性均值与标准差(μ / σ)
\[\mu = \frac{1}{n}\sum_{i = 1}^{n}x_{i},\quad\quad\sigma = \sqrt{\frac{1}{n}\sum_{i = 1}^{n}(x_{i} - \mu)^{2}}.\]
**理论与方法:**样本光谱一致性先求多边形内均值 μ,再以总体标准差 σ 表示像元围绕均值的离散。**实现与判读:**代码支持同一基名命中多个字段,并按 all、any 或 mean 策略组合判据;字段缺失和有效像元下限会影响是否执行。
A-082 跨时空稳定性分区均值判据(z_j / θ)
\[\max_{j}|z_{j}| \leq \theta,\quad z_{j} = \frac{1}{n_{j}}\sum_{i = 1}^{n_{j}}y_{ij},\]
**理论与方法:**每个稳定性字段先在样本分区内求均值 z_j,再以 max|z_j|≤θ 判断整体稳定。**实现与判读:**y_ij 是第 j 字段在像元 i 的值,n_j 是有效像元数;该方法检验分区平均变化,不等价于检验像元级最大变化。
A-083 多边形向内缓冲(negative buffer)
\[\widetilde{P}\mspace{6mu} = \mspace{6mu} buffer(P,\, - b),\quad b > 0\]
**理论与方法:**负缓冲把多边形边界向内收缩 b,减少边界混合像元进入训练样本。**实现与判读:**代码使用 buffer(P,−b);b 过大可能使小多边形为空,因此执行后必须检查几何有效性和剩余面积。
A-084 像元空间块编号与折号(groups_block / fold_id)
\[g = \left\lfloor \frac{r}{b} \right\rfloor \times 10^{6} + \left\lfloor \frac{c}{b} \right\rfloor,\quad\text{fold\_id} = g\ mod\ k\]
**理论与方法:**空间块编号把像元行列按块尺寸 b 离散,并组合为整数 g,再以 g mod k 生成折号。**实现与判读:**groups_block 和 fold_id 随训练数据保存,使相邻像元进入同组,降低随机切分导致的空间泄漏。
A-085 子特征中心距一致性筛选(d_i / keep_fraction)
\[d_{i} = \parallel \mathbf{x}_{i} - \mathbf{\mu} \parallel_{2},\quad keep \Leftrightarrow d_{i} \leq {Quantile}_{\alpha}(d)\]
**理论与方法:**一致性筛选在选定子特征空间计算像元到多边形中心 μ 的欧氏距离 d_i,并保留不超过 α 分位阈值的像元。**实现与判读:**keep_fraction=α 越小越严格;各维量纲差异会影响距离,通常应配合标准化或经过筛选的物理特征。
A-086 训练数据空间块化 K 折(groups_block / fold_id)
\[g = \left\lfloor \frac{r}{b} \right\rfloor \times 10^{6} + \left\lfloor \frac{c}{b} \right\rfloor,\quad\text{fold\_id} = g\ mod\ k\]
**理论与方法:**该式是生成训练数据阶段对空间块化 K 折的完整定义,与 A-084 的分组编码一致。**实现与判读:**块 g 作为 groups_block,g mod k 作为 fold_id;折号只用于预定义分组,训练时仍需保证整块不跨训练与验证集合。
A-087 训练验证自适应空间网格组号(group_id)
\[g = \left\lfloor \frac{x}{\Delta_{x}} \right\rfloor \times 10^{7} + \left\lfloor \frac{y}{\Delta_{y}} \right\rfloor.\]
**理论与方法:**自适应空间网格把坐标 x、y 分别按网格宽 Δx、Δy 离散,再用 10^7 组合为唯一组号。**实现与判读:**该组号用于严格组级训练/验证切分;地理坐标会先进行米—度适配,网格参数和 CRS 必须保存在 split_meta 中。
A-088 随机森林多数投票预测(f̂)
\[\widehat{f}(\mathbf{x}) = mode\left( \{\, T_{b}(\mathbf{x})\,\}_{b = 1}^{B} \right),\quad\quad B = n_{estimators}.\]
**理论与方法:**随机森林把 B 棵决策树 T_b(x) 的类别输出取众数,利用自助采样与特征随机化降低单树方差。**实现与判读:**B 对应 n_estimators;模型预测依赖训练时保存的特征顺序、标签编码器和预处理配置。
A-089 随机森林多类投票决策(ŷ)
\[\widehat{y} = arg\max_{c}\mspace{6mu}\sum_{b = 1}^{B}\mspace{6mu}\mathbb{1}\left\{ \, T_{b}(\mathbf{x}) = c\, \right\}.\]
**理论与方法:**多类投票决策统计每个类别获得的树票数,并选择票数最大的类别。**实现与判读:**它是多数投票的显式 argmax 表达;平票处理遵循模型实现的类别顺序,不能从公式外另行假设。
A-090 累计特征重要性选取数(K)
\[K = min\left\{ \, k:\mspace{6mu}\sum_{j = 1}^{k}I_{(j)} \geq \tau \right\},\quad\quad\tau \in (0,1\rbrack.\]
**理论与方法:**累计重要性筛选按降序重要性 I_(j) 选择最小 K,使前 K 项累计值达到阈值 τ。**实现与判读:**Top-K>0 时直接采用固定 K 并覆盖该规则;强制保留字段在相关性裁剪中仍保留。
A-091 严格组级训练/验证分组(g)
\[g = \left\lfloor \frac{x}{\Delta_{x}} \right\rfloor \times 10^{7} + \left\lfloor \frac{y}{\Delta_{y}} \right\rfloor,\]
**理论与方法:**严格组级切分再次用空间坐标和自适应网格构造 g,确保邻近样本不被随机拆散。**实现与判读:**公式中的 10^7 是组号编码因子而非距离尺度;实际网格尺寸由界面参数和 CRS 转换确定。
A-092 逐类别最优 F1 概率阈值(t_c*)
\[t_{c}^{\star} = arg\max_{t\mathcal{\in G}}{F1}_{ovr}(t),\quad\quad F1 = \frac{2PR}{P + R}.\]
**理论与方法:**对每个类别 c 在候选阈值网格上计算 one-vs-rest F1,并选择使 F1 最大的 t_c*。**实现与判读:**阈值仅在启用最佳阈值搜索时保存和应用;F1 同时平衡精确率与召回率,最优阈值依赖验证集分布。
A-093 有效特征像元判定(v_i)
\[v_{i} = \sum_{j = 1}^{d}\mathbf{1}\left\lbrack x_{ij}\ \text{为有限数} \right\rbrack\]
**理论与方法:**v_i 统计样本 i 的 d 个特征中有限值的数量,用于判断该像元是否具备可预测信息。**实现与判读:**NaN 和无穷值不计入;该步骤只检查数值有效性,不评价特征物理质量。
A-094 最小有效特征比例判据(min_valid_ratio)
\[v_{i} \geq \left\lceil \rho d \right\rceil,\quad\quad\rho = \text{min\_valid\_ratio} = 0.80\]
**理论与方法:**最小有效比例判据要求 v_i≥ρd,默认 ρ=0.80,允许少量特征缺失但拒绝信息严重不足的像元。**实现与判读:**ρ 越高越严格;最终使用值应与训练时的缺失填补策略一致。
A-095 特征中位数缺失填补(median imputation)
\[{\widetilde{x}}_{ij} = \left\{ \begin{matrix} x_{ij}, & x_{ij}\ \text{为有限数}, \\ {median}_{k:x_{kj}\ \text{有效}}(x_{kj}), & \text{否则}. \end{matrix} \right.\ \]
**理论与方法:**缺失填补对每个特征列保留原有限值,并用该列训练样本中位数替换缺失值。**实现与判读:**中位数对异常值较稳健;填补参数必须由训练集估计并在预测阶段复用,避免数据泄漏。
A-096 特征标准化(StandardScaler / z-score)
\[\mathbf{z} = \frac{\widetilde{\mathbf{x}} - \mu}{\sigma}\]
**理论与方法:**Z-score 标准化以训练均值 μ 和标准差 σ 把特征转换为零均值、单位尺度。**实现与判读:**代码对应 StandardScaler;σ=0 的常量列需按库规则处理,预测必须加载训练阶段同一 scaler。
A-097 达到类别阈值的候选集(S_i)
\[S_{i} = \{\, c \mid p_{ic} \geq t_{c}\,\},\]
**理论与方法:**S_i 收集样本 i 中预测概率 p_ic 达到各类别阈值 t_c 的候选类别。**实现与判读:**集合可为空或包含多个类别;它把逐类阈值转换为多类决策的中间状态。
A-098 多类阈值预测决策(ŷ_i)
\[{\widehat{y}}_{i} = \left\{ \begin{matrix} \arg\max_{c \in S_{i}}\, p_{ic}, & S_{i} \neq \varnothing, \\ \arg\max_{c}\, p_{ic}, & S_{i} = \varnothing. \end{matrix} \right.\ \]
**理论与方法:**若 S_i 非空,则在候选类别中选择概率最大者;若为空,回退到所有类别的概率 argmax。**实现与判读:**该规则避免像元因没有类别达阈值而无结果,同时保留阈值对类别进入候选集的控制。
A-099 多边形内特征统计聚合(mean / std 等)
\[\text{mean} = \frac{1}{|\Omega|}\sum_{u \in \Omega}^{}F(u),\quad\quad\text{std} = \sqrt{\frac{1}{|\Omega|}\sum_{u \in \Omega}^{}(F(u) - \bar{F})^{2}},\quad\ldots\]
**理论与方法:**多边形统计在区域 Ω 内对预测或特征栅格计算均值、标准差及其他统计量,把像元结果汇总为对象级特征。**实现与判读:**只使用区域内有效像元,统计类型和有效样本数应随输出保存,以便比较不同多边形。
A-100 类别频数指数权重(w_c)
\[w_{c} = \frac{(n_{c})^{- \alpha}}{\sum_{k}^{}(n_{k})^{- \alpha}},\quad\quad\alpha = 0.35\ (\text{default}).\]
**理论与方法:**类别权重按样本数 n_c 的负 α 次方计算并归一化,少数类获得较大权重;默认 α=0.35。**实现与判读:**α=0 退化为等权,α 增大强化长尾补偿;权重用于 ResNet 损失而不是改变原始样本标签。
A-101 带权交叉熵损失(CrossEntropy)
\[\mathcal{L}_{\text{CE}} = - \frac{1}{B}\sum_{i}^{}{\sum_{c}^{}w_{c}}\,\mathbf{1}\lbrack y_{i} = c\rbrack log\frac{e^{z_{ic}}}{\sum_{k}^{}e^{z_{ik}}}.\]
**理论与方法:**带权交叉熵对真实类别的负对数概率按 w_c 加权,使少数类误判产生更大损失。**实现与判读:**z_ic 为 logits,分母实现 softmax 归一化;代码还可设置 label_smoothing,批量大小 B 用于求平均。
A-102 Focal 损失(FocalLoss)
\[\mathcal{L}_{\text{Focal}} = \frac{1}{B}\sum_{i}^{}(1 - p_{i,y_{i}})^{\gamma}\,\mathcal{l}_{i}.\]
**理论与方法:**Focal 损失以 (1−p_true)^γ 降低易分类样本权重,把优化重点转向低置信或难分类样本。**实现与判读:**γ 越大聚焦越强;当前训练配置可结合类别权重,过大 γ 可能使总体训练不稳定。
A-103 混合 Focal–Dice 损失(HybridFocalDice)
\[\mathcal{L}_{\text{Hybrid}} = (1 - \lambda)\,\mathcal{L}_{\text{Focal}} + \lambda\,(1 - \text{Dice}_{\text{macro}}).\]
**理论与方法:**HybridFocalDice 以 λ 加权组合 Focal 损失与 1−宏平均 Dice,兼顾难样本学习和类别区域重叠。**实现与判读:**λ 控制两部分权衡;宏 Dice 对少数类更敏感,需与验证集 Macro-F1 一起评估。
A-104 温度缩放概率(softmax(z/τ))
\[\mathbf{p} = softmax(\mathbf{z}/\tau),\quad\quad\tau \geq 1.\]
**理论与方法:**温度缩放把 logits 除以 τ 后再 softmax;τ>1 会软化概率分布而不改变单尺度 argmax 顺序。**实现与判读:**代码允许关闭该步骤;τ 是概率校准/融合参数,不应解释为模型精度本身。
A-105 ResNet 多尺度概率融合(smooth / vote)
\[\mathbf{p}^{*} = \left\{ \begin{matrix} (\mathbf{p}_{64} + \mathbf{p}_{128})/2, & \text{smooth}, \\ argmax\text{一致则用其;否则取最大置信的概率向量}, & \text{vote}. \end{matrix} \right.\ \]
**理论与方法:**smooth 模式平均 64 与 128 像素尺度概率,vote 模式在两尺度一致时沿用类别,不一致时选择最大置信的概率向量。**实现与判读:**该式对应 ResNet 多尺度推理;严格像元模式会关闭多尺度、融合和温度后处理。
A-106 主模型与 ResNet 目标类交集(I)
\[\mathcal{I = \{(}i,j) \mid M_{ij} = t\ \land \ R_{ij} = t\}\]
**理论与方法:**集合 I 是主模型 M 与 ResNet R 同时把像元判为目标类 t 的交集,表示两模型一致的高置信核心。**实现与判读:**该步骤不使用概率,只比较对齐后的类别编码;NoData 和越界像元不进入交集。
A-107 交集细化严格模式(A-strict)
\[F_{ij} = \left\{ \begin{matrix} t, & (i,j\mathcal{) \in I,} \\ 255, & M_{ij} = t,\ R_{ij} \neq t, \\ M_{ij}, & \text{otherwise}. \end{matrix} \right.\ \]
**理论与方法:**A-strict 仅保留两模型一致的目标类像元,主图判为目标而 ResNet 不同意时写为 NoData=255。**实现与判读:**该模式偏向提高精确率并可能产生空洞,通常需后续连通域或概率方法补充。
A-108 交集细化温和模式(A-refine)
\[F_{ij} = \left\{ \begin{matrix} R_{ij}, & M_{ij} = t,\ R_{ij} \neq t, \\ t, & (i,j\mathcal{) \in I,} \\ M_{ij}, & \text{otherwise}. \end{matrix} \right.\ \]
**理论与方法:**A-refine 在分歧处采用 ResNet 类别,同时保留两模型一致目标和其他主图像元。**实现与判读:**它比 strict 温和,在精确率与召回率之间折中;执行前必须保证标签映射一致。
A-109 ResNet 直接覆盖模式(B)
\[F_{ij} = \left\{ \begin{matrix} t, & R_{ij} = t, \\ M_{ij}, & \text{otherwise}. \end{matrix} \right.\ \]
**理论与方法:**B 模式只要 ResNet 判为目标类 t 就直接覆盖主图,否则保持主图。**实现与判读:**该规则单调扩大 ResNet 目标类区域,适合其召回率和边界质量更可靠的情形,但会同步引入 ResNet 噪声。
A-110 像元置信度阈值修正(C)
\[F_{ij} = \left\{ \begin{matrix} t, & M_{ij} \neq t,\ R_{ij} = t,\ p_{t,ij} \geq \tau, \\ M_{ij}, & \text{otherwise}. \end{matrix} \right.\ \]
**理论与方法:**C 模式仅在主图非目标、ResNet 判为目标且目标概率不低于 τ 时新增目标像元。**实现与判读:**提高 τ 会减少改写、通常提高精确率并降低召回率;缺失概率视为条件不满足。
A-111 连通域平均目标类置信度(p̄(Ω_m))
\[\bar{p}(\Omega_{m}) = \frac{1}{|\Omega_{m}|}\sum_{(i,j) \in \Omega_{m}}^{}p_{t,ij}.\]
**理论与方法:**连通域平均置信度对 ResNet 目标掩膜中的每个连通区域 Ω_m 求 p_t 的均值,表示区域整体可靠性。**实现与判读:**面积按像元计,连接性默认 8 邻域;均值抑制单个高概率噪声点。
A-112 连通域增强判别(D)
\[F_{ij} = \left\{ \begin{matrix} t, & (i,j) \in \Omega_{m}\ \text{且}\ \bar{p}(\Omega_{m}) \geq \alpha,\ |\Omega_{m}| > n_{\min}, \\ M_{ij}, & \text{otherwise}. \end{matrix} \right.\ \]
**理论与方法:**D 模式仅当连通域平均置信度达到 α 且面积大于 n_min 时,把整块写为目标类。**实现与判读:**α 和 n_min 越大越保守;该区域级规则利用地物成片性抑制椒盐误差。
A-113 全概率冲突纠错边际(margin)
\[\max_{c \neq t}p_{c,ij} > p_{t,ij} + m\]
**理论与方法:**冲突边际要求非目标类别最大概率超过目标概率至少 m,才认为主图目标标签与全概率分布存在明显冲突。**实现与判读:**m 防止微小概率差触发改写;它与 remove_thresh 共同控制纠错强度。
A-114 全概率一致性融合规则(E)
\[F_{ij} = \left\{ \begin{matrix} t, & M_{ij} \neq t,\ p_{t,ij} \geq a, \\ \arg\max_{c}p_{c,ij}, & M_{ij} = t,\ p_{t,ij} < r,\ \max_{c \neq t}p_{c,ij} > p_{t,ij} + m, \\ M_{ij}, & \text{otherwise}. \end{matrix} \right.\ \]
**理论与方法:**E 模式同时执行高置信补漏和明显冲突纠错:非目标像元的 p_t≥a 时加为目标,原目标像元在 p_t<r 且竞争类领先 m 时改为概率最大类。**实现与判读:**a、r、m 分别控制新增、移除和竞争边际,NoData 始终保持不变。
空间结构关系分析总览
A-115 结构—响应统一关系模型(Y_i(s))
\[\mathbf{Y}_{i}(s) = f\left( \mathbf{X}_{i}(s),\mathbf{C}_{i}(s) \mid s\mathcal{,G} \right) + {\overrightarrow{\varepsilon}}_{i},\]
**理论与方法:**统一关系模型把尺度 s 下的结构特征 X_i、控制变量 C_i、空间权重 G 与响应 Y_i 置于同一表达,ε_i 表示未解释部分。**实现与判读:**f 可由相关、回归、树模型或空间模型实现;该式组织分析对象,不预设线性、因果或单一尺度成立。
A-116 方法执行门控指标(I_run)
\[I_{run} = I_{implemented}\, I_{compatible}\, I_{selected}\, I_{dependency},\]
**理论与方法:**I_run 是四个布尔条件的乘积,只有方法已实现、数据兼容、用户选中且依赖可用时才执行。**实现与判读:**任何一项为 0 都会跳过该方法并在状态或清单中记录原因,防止把“界面已注册”误认为“本批次已计算”。
A-117 统计单元分析公共支持域(E_∩)
\[E_{\cap} = B \cap \underset{k = 1}{\bigcap^{m}}E_{k}.\]
**理论与方法:**公共支持域 E_∩ 是研究边界与各数据有效范围的交集,保证所有变量在同一空间范围内可同时观测。**实现与判读:**统计单元分析先按该范围裁切和对齐;交集过小会减少样本并改变尺度上限,因此需在 manifest 中记录。
A-118 目标网格行列数(n_col / n_row)
\[n_{col} = \left\lceil \frac{W}{r_{x}} \right\rceil,\quad\quad n_{row} = \left\lceil \frac{H}{r_{y}} \right\rceil.\]
**理论与方法:**目标网格列数与行数由公共范围宽、高除以目标像元大小并取整得到。**实现与判读:**r_x、r_y 是目标分辨率;取整、锚点和边界包含规则共同决定最终网格相位,所有源数据必须重采样到该网格。
A-119 按位置对齐的数据集(D = X C Y P)
\[D = \lbrack X\ C\ Y\ P\rbrack\]
**理论与方法:D 按共同位置连接主结构 X、控制 C(如配置)、响应 Y 和位置索引 P。P 用于空间划分与回写,**不是模型自变量。阶段 C 的有效样本、字段角色与来源身份需保留,不能以占位 NPY 缓存替代。
A-120 统计单元尺度聚合(X_i(s) / Y_i(s))
\[\mathbf{X}_{i}(s) = \phi\left( S \cap Q_{i}(s) \right),\quad\quad\mathbf{Y}_{i}(s) = \psi\left( R \cap Q_{i}(s) \right),\]
**理论与方法:**统计单元尺度用聚合函数 φ、ψ 分别汇总尺度 s 单元 Q_i(s) 内的结构栅格 S 与响应栅格 R。**实现与判读:**改变 s 会同时改变空间支持域和样本数,聚合方法及有效像元阈值必须固定后才能比较尺度曲线。
A-121 邻域作用尺度聚合(X_i,w / y_i)
\[\mathbf{X}_{i,w} = \phi\left( S \cap \mathcal{N}_{w}(i) \right),\quad\quad y_{i}\mathcal{= A}\left( R \cap G_{i} \right),\]
**理论与方法:**邻域作用尺度在中心 i 周围窗口 N_w(i) 聚合结构得到 X_i,w,而响应 y_i 固定在中心支持域 G_i 上。**实现与判读:**该设计把“作用范围变化”与“响应统计单元变化”分离,用于检验邻域溢出;窗口 w 应为明确的奇数像元或物理距离。
结构/响应特征尺度轴
A-122 尺度—方法关系得分(R_km(s))
\[R_{km}(s) = \mathcal{M}_{m}\left( X_{k}(s),Y(s),\mathbf{P}(s) \right),\]
**理论与方法:**R_km(s) 表示结构特征 k 与响应 m 在尺度 s 下由方法 M_m 计算的关系得分。**实现与判读:**得分可以是相关系数、R²、GeoDetector q 或其他方法量,不同方法的绝对值不可直接比较,只能在各自定义内分析方向和稳定性。
A-123 跨尺度关系序列(S_km)
\[\mathcal{S}_{km} = \{(s_{1},R_{km}(s_{1})),\ldots,(s_{L},R_{km}(s_{L}))\}.\]
**理论与方法:**S_km 把同一结构—响应—方法组合在多个尺度上的得分配对成有序序列,是峰值、平台、断点和 AUC 诊断的输入。**实现与判读:**尺度必须按物理大小排序,并保留每个点的样本数和有效性标记。
A-124 整数倍尺度块边长(b(s))
\[b(s) = round\left( \frac{s}{r_{0}} \right),\]
**理论与方法:**整数倍尺度模式将目标尺度 s 除以基础分辨率 r_0 后四舍五入为块边长 b(s)。**实现与判读:**该模式用于严格按基础像元整数倍聚合;舍入后的实际尺度 b r_0 应随结果保存,避免名义尺度与实现尺度混淆。
A-125 任意连续尺度的物理样方边界(Q_i(s))
\[Q_{i}{(s) = \lbrack x}_{i}{,x}_{i}{+ s\rbrack \times \lbrack y}_{i}{,y}_{i} + s\rbrack\]
理论与方法:连续尺度以真实物理边界构建样方,裁取源数据并记录局部分辨率。覆盖读取可使用 ceil,但不将向上取整像元块当作请求尺度;整数倍模式另按基础网格聚合。
A-126 尺度样方数量(N_s)
\[N_{s} = \lfloor\frac{H_{phys}}{s}\rfloor\lfloor\frac{W_{phys}}{s}\rfloor\]
**理论与方法:**规则完整样方的几何上限由公共支持域物理高、宽除以请求边长计算;有效样本数需进一步依据 NoData、结构与响应覆盖核查。邻域模式使用中心与窗口有效性规则,不能混用该样方数量式。
A-127 邻域滑动窗口(N_w(i))
\[\mathcal{N}_{w}(i) = \{(r,c):|r - r_{i}| \leq (w - 1)/2,\ |c - c_{i}| \leq (w - 1)/2\}.\]
**理论与方法:**N_w(i) 用行列差不超过 (w−1)/2 定义以 i 为中心的方形滑动邻域,相当于 Chebyshev 距离窗口。**实现与判读:**w 应为奇数;边界处窗口按公共支持域和有效像元规则截断或判无效。
A-128 邻域结构与响应聚合(X_i,w / y_i)
\[\mathbf{X}_{i,w} = \phi(S \cap \mathcal{N}_{w}(i)),\quad\quad y_{i}\mathcal{= A(}R \cap G_{i}),\]
**理论与方法:**该式在邻域 N_w(i) 内聚合结构 S,同时在固定中心单元 G_i 内聚合响应 R,明确了邻域作用分析的双支持域。**实现与判读:**φ 和 A 可以是均值、分位数、类别多数等,二者的配置需写入 schema,不能只记录窗口大小。
A-129 统计单元基础统计量(mean / σ / CV)
\[\bar{v} = \frac{1}{n}\sum_{j}^{}v_{j},\quad\sigma = \sqrt{\frac{1}{n}\sum_{j}^{}(v_{j} - \bar{v})^{2}},\quad CV = \frac{\sigma}{\bar{v}}\quad(|\bar{v}| > 10^{- 12}).\]
**理论与方法:**基础统计量包括样本均值、总体标准差和变异系数 CV=σ/mean,用于描述单元内中心水平、绝对离散和相对离散。**实现与判读:**当均值绝对值不超过 10^-12 时不解释 CV;分类变量不宜使用这些连续统计。
A-130 稳健离散度(MAD / IQR)
\[MAD = \frac{1}{n}\sum_{j}^{}|v_{j} - \bar{v}|,\quad\quad IQR = Q_{0.75} - Q_{0.25},\]
**理论与方法:**MAD 以均值绝对偏差、IQR 以四分位跨度描述稳健离散度,比方差对极端值更不敏感。**实现与判读:**当前式中的 MAD 围绕均值而非中位数,解释时应与 A-063 的窗口 MAD 定义区分。
A-131 经验半变异函数(γ(h))
\[\widehat{\gamma}(h) = \frac{1}{2N(h)}\sum_{(u,v) \in N(h)}^{}\lbrack z(u) - z(v)\rbrack^{2}.\]
**理论与方法:**经验半变异函数把距离分组 h 内所有像元对的数值差平方求平均后乘 1/2,描述空间相似性随距离衰减。**实现与判读:**N(h) 是对应距离箱的有效点对集合;箱宽、最大距离和样本数决定曲线稳定性。
A-132 球状半变异函数模型(γ_sph)
\[\gamma_{sph}{(h) = c}_{0}{+ c\lbrack 1.5(h/r) - 0.5(h/r)}^{3}\rbrack,\ h \leq r\]
理论与方法:SciKit-GStat 球状模型以 r 为有效变程、c 为部分基台、c₀ 为块金;有效坐标与 lag 已为物理距离,不能再次乘分辨率。拟合条件不足时保留未定义状态,不解释有效变程。
A-133 指数与高斯半变异函数模型(γ_exp / γ_gau)
\[\gamma_{\exp}{(h) = c}_{0}{+ c(1 - e}^{- 3h/r}{);\ \gamma}_{gau}{(h) = c}_{0}{+ c(1 - e}^{{- 4h}^{2}{/r}^{2}})\]
**理论与方法:**SciKit-GStat 指数与高斯模型分别使用 e^(−3h/r) 与 e^(−4h²/r²) 的有效变程参数化,与采用 a 的传统衰减长度记号不同。输入坐标和返回变程均按物理距离,按实际后端及单位解释。
A-134 尺度统计结果栅格回写(Z_k(g))
\[Z_{k}(g\mathcal{) = R}\left( \{ v_{ik}:g \in Q_{i}\} \right),\]
**理论与方法:**Z_k(g) 把属于统计单元 Q_i 的结果 v_ik 回填到栅格位置 g,使单元级统计重新形成空间图层。**实现与判读:**R 是回写规则;位置索引、目标网格和 NoData 必须与建模阶段一致,重叠或缺失单元需按 schema 处理。
控制变量 / 多目标分析
A-135 多目标统计输出类型
\[{S,T}_{conflict}{,D,P}_{front}\]
理论与方法:方向校正目标间的正负关联、固定参考协调度和精确非支配成员分别描述依赖、相对状态和支配关系。它们均不直接证明真实改善或生态最优;目标展开特征不作为独立生态服务。
A-136 主结构—控制—响应对齐聚合(X_i / C_i / Y_i)
\[\mathbf{X}_{i}(s) = \phi_{X}(S_{X} \cap Q_{i}),\quad\mathbf{C}_{i}(s) = \phi_{C}(S_{C} \cap Q_{i}),\quad\mathbf{Y}_{i}(s) = \phi_{Y}(S_{Y} \cap Q_{i}).\]
**理论与方法:**φ_X、φ_C、φ_Y 分别在同一单元 Q_i 上聚合主结构、控制变量和响应,使三种角色具有共同支持域。**实现与判读:**角色在 schema 中明确登记;同一变量不能因列顺序被误当作其他角色,聚合方式应随批次保存。
A-137 控制与多目标分析公共支持域(E_∩)
\[E_{\cap} = \bigcap_{k}E_{k}.\]
**理论与方法:**控制与多目标分析的公共支持域是所有主结构、控制变量和响应有效范围的交集。**实现与判读:**只有交集内样本进入标准化与建模;改变任何数据源、掩膜或对齐参数都应使该阶段失效并重新计算。
A-138 特征 Z-score 标准化(z_ij)
\[z_{ij} = \frac{x_{ij} - {\bar{x}}_{j}}{\sigma_{j}}.\]
**理论与方法:**Z-score 使用训练折均值与标准差,缺失处理、特征选择及调参也在训练折内拟合,然后应用于验证样本。常量列及恒定响应记录拒绝原因;不得先在全样本标准化再评估外推。
A-139 目标方向校正标准化响应(D_it)
\[D_{it} = d_{t}\frac{Y_{it} - \mu_{t}}{max(\sigma_{t},10^{- 9})}.\]
**理论与方法:**D_it 先把响应 Y_it 标准化,再乘方向因子 d_t,使所有目标统一为“数值越大越符合期望方向”。**实现与判读:**d_t 通常为 +1 或 −1,分母下限 10^-9 防止零方差;D_it 是方向标准化目标,不是天然限制在 0–1 的概率。
A-140 主结构单特征分析对象(x_k)
\[S_{i}^{X}{= x}_{ik}\]
理论与方法:相关与偏相关以明确的主结构字段为对象,结果保留来源与字段。V3.5.0 不把完整 X+C 的前四列均值当作主结构综合信号;多变量方法另使用经过角色筛选的设计矩阵。
A-141 主结构与控制设计矩阵(X / C)
\[Z = \lbrack X\ C\rbrack,\ P \notin Z\]
理论与方法:主结构与控制列按 schema 角色筛选,位置索引排除。多变量预测使用 X+C、X-only、C-only 匹配模型,控制后的单变量关系保持具体 x_k 身份。
A-142 控制变量回归后的结构残差(e_X)
\[{Z = \lbrack 1\ C\rbrack;\ e}_{X}{= x}_{k}{- Z\beta\hat{}}_{X}\]
理论与方法:偏相关对具体结构字段 x_k 回归控制 C,使用含截距的最小二乘残差。共同有限样本及共线性条件须核查,残差关系不证明因果。
A-143 控制变量回归后的响应残差(e_Y)
\[e_{Y}{= y - Z\beta\hat{}}_{Y}\]
**理论与方法:**同样用控制矩阵 Z 回归响应 y 并得到残差 e_Y,表示控制变量之外的响应变化。**实现与判读:**e_X 与 e_Y 必须在同一有效样本上计算;缺少控制变量时偏相关退化为普通相关。
A-144 控制后偏相关系数(r_XY·Z)
\[r_{XY \cdot Z} = corr(e_{X},e_{Y}).\]
**理论与方法:**控制后偏相关系数是结构残差 e_X 与响应残差 e_Y 的 Pearson 相关,衡量给定控制变量后的线性关联方向和强度。**实现与判读:**它减少已观测控制变量的线性影响,但不自动证明因果关系,也不控制未观测混杂。
A-145 距离相关系数(dCor)
\[dCor(X,Y) = \frac{\sqrt{max(\overline{AB},0)}}{\sqrt{\sqrt{max(\overline{A^{2}},0)}\sqrt{max(\overline{B^{2}},0)}}}.\]
理论与方法:距离相关由 dcor 成熟后端计算,衡量非负依赖。精确计算具有二次规模开销,按实际 sample_cap/max_exact_samples 记录抽样或跳过;0 上限表示不抽样,不能把代理结果冒充 dcor。
A-146 固定参考综合目标水平(T_i)
\[T_{i} = \frac{1}{J}\Sigma_{j = 1}^{J}d_{ij}\]
理论与方法:T_i 为完整目标组的固定参考 0—1 满意度均值,表示相对目标水平。该空间输出不是局部协同、控制后效应或真实改善。目标方向及源数据参考界限跨尺度保持固定。
A-147 全局协同关联强度(S)
\[{S = mean}_{j < k}{\lbrack max(\rho}_{jk},0)\rbrack\]
理论与方法:对方向统一的物理目标,在共同完整样本上计算目标对 Spearman ρ,协同指标为 max(ρ,0) 的目标对均值。至少两个非恒定物理目标及足够共同样本;不反映结构 X 控制 C 后的影响。
A-148 目标水平不均衡度(I_i)
\[I_{i}{= std}_{j}{(d}_{ij})\]
理论与方法:I_i 为完整目标组中固定参考满意度的标准差,描述同一样方目标水平分化,不直接称为生态冲突。它与基于跨样本负相关的全局权衡强度不同。
A-149 全局权衡关联强度(T_conflict)
\[T_{conflict}{= mean}_{j < k}{\lbrack max( - \rho}_{jk},0)\rbrack\]
理论与方法:权衡强度为方向统一目标对 max(−ρ,0) 的均值。高值表示候选目标组负关联较强,不作为期望优化目标;同一固定目标组才可跨尺度比较。
A-150 固定参考目标满意度(d_ij)
\[d_{ij} = clip(\frac{y_{ij}{- l}_{j}}{u_{j}{- l}_{j}},0,1)\]
理论与方法:l_j、u_j 为源数据固定 2%—98% 界限。正向目标使用 clip[(y−l)/(u−l),0,1],反向目标使用 1−d。界限缺失或无跨度时该协调评价不执行;不能每尺度重新估计。
A-151 耦合协调度(CCD_i / CCD)
\[C_{i} = \frac{{(\prod}_{j = 1}^{J}d_{ij})^{1/J}}{T_{i}}{;\ D}_{i}{= C}_{i}^{\alpha}T_{i}^{1 - \alpha}\]
**理论与方法:**T_i 为满意度算术均值,C_i 为几何均值与算术均值之比,T_i=0 时 C_i=0。D_i=C_i^α T_i^(1−α),默认 α=0.5;尺度值为共同有效样本 D_i 的均值,是描述性评价。
A-152 Pareto 支配判据
\[D_{at} \geq D_{bt}\ \forall t,\quad\quad\exists t:D_{at} > D_{bt}.\]
**理论与方法:**若样本 a 在所有方向统一目标上均不差于 b,且至少一个目标严格更好,则 a Pareto 支配 b。**实现与判读:**不被其他样本支配者属于第一前沿;该判据只比较相对非支配性,不反映与规划阈值的绝对距离。
A-153 精确非支配前沿占比(P_front)
\[P_{front}(s) = \frac{N_{non - dominated}}{N_{complete}}\]
理论与方法:P_front 为精确第一非支配前沿成员数除以全部目标完整样本数。pymoo 执行精确判断,不采用近似采样前沿,不输出多层 rank;前沿份额不是达标、稳定性或真实共赢证明。
A-154 Elastic Net 目标函数
\[\widehat{\beta} = arg\min_{\beta}\left\{ \frac{1}{2n} \parallel y - Z\beta \parallel_{2}^{2} + \lambda\left\lbrack \alpha \parallel \beta \parallel_{1} + \frac{1 - \alpha}{2} \parallel \beta \parallel_{2}^{2} \right\rbrack \right\}.\]
理论与方法:Elastic Net 采用 scikit-learn Pipeline/GridSearchCV,内层空间验证选择惩罚与比例,训练折预处理,外层有效折报告 R²。系数是拟合条件关联;本批参数以保存的配置为准。
A-155 控制变量纳入后的净效应(ΔR_X²)
\[\Delta R_{X}^{2} = R_{full}^{2}(X,C) - R_{control}^{2}(C).\]
**理论与方法:**ΔR² 使用同一响应、共同有效样本、匹配空间划分和最终有效折上的 full−control 评分差;至少 3 个有效折。它是加入主结构的预测解释增量,负值保留,不是因果效应。
A-156 偏最小二乘潜变量分解(PLS)
\[X = TP^{T} + E,\quad\quad y = Uq^{T} + f,\]
**理论与方法:**PLS 把 X、y 分解到潜变量得分 T、U 及载荷 P、q,并选择协方差较高的方向,适合多重共线特征。**实现与判读:**当前代码为标准 PLSRegression,默认 n_components=2;界面虽保留 sPLS 名称,但未施加额外稀疏惩罚。
A-157 跨目标效应向量余弦相似度(cosθ)
\[\cos\theta = \frac{\mathbf{w}_{a}^{T}\mathbf{w}_{b}}{\parallel \mathbf{w}_{a} \parallel_{2} \parallel \mathbf{w}_{b} \parallel_{2}}.\]
理论与方法:方向统一后的线性系数模式可用带符号余弦描述一致性;树模型无符号重要度余弦仅表示共同依赖的特征模式。两者不能混为生态协同/权衡。
A-158 样本外模型预测(OOF_i)
\[{OOF}_{i}{= f}_{train\ fold}{(X}_{i}{,C}_{i}),\ i \in test\ fold\]
理论与方法:样方级回图采用有来源说明的模型预测及目标描述字段。OOF 预测来自未参与该折训练的样本;未被验证的行保留缺失。不能将其称作局部因果净效应,字段身份以 spatial schema 为准。
A-159 决定系数(R²)
\[R^{2} = 1 - \frac{\sum_{i}^{}(y_{i} - {\widehat{y}}_{i})^{2}}{\sum_{i}^{}(y_{i} - \bar{y})^{2}}.\]
**理论与方法:**R² 用残差平方和相对于总平方和的减少比例衡量拟合解释度,1 为完美拟合,0 相当于均值基准。**实现与判读:**空间块交叉验证中 R² 可为负,表示外推表现低于均值基准;训练拟合与验证 R² 不可混为一谈。
A-160 SHAP 加性分解与平均绝对重要性
\[f(x\mathbb{) = E\lbrack}f(X)\rbrack + \sum_{j}^{}\phi_{j},\quad\quad I_{j} = {mean}_{i}|\phi_{ij}|.\]
理论与方法:SHAP 分解特定模型预测,平均绝对值为无符号重要度。只有该依赖和解释器实际执行时才标记 SHAP,失败需记录;当前源码环境未安装 SHAP 时不伪装为已运行。
A-161 置换重要性(permutation importance)
\[I_{j}^{perm} = Score(X,y) - Score(X_{\pi(j)},y),\]
理论与方法:置换重要性反映打乱特征导致的预测评分变化,相关变量可分摊重要度。只有显式执行且注明方法时才称置换重要性;原生重要度另以本来身份登记,不冒充 SHAP。
A-162 多尺度地理加权回归(MGWR)
\[y_{i} = \beta_{0}(u_{i},v_{i}) + \sum_{k}^{}\beta_{k}(u_{i},v_{i})x_{ik} + \epsilon_{i},\]
理论与方法:MGWR 使用成熟库估计空间非平稳系数,保存实际模型身份、样本和带宽。当前样本内拟合标为 descriptive_fit,不是空间交叉验证,也不作为可靠生态最优尺度。
A-163 空间 Durbin 模型(SDM)
\[y = \rho Wy + X\beta + WX\theta + \epsilon.\]
**理论与方法:**空间 Durbin 使用 spreg,W 的来源与标准化及实际模型身份需保存。pr2 是样本内伪决定系数,不等于预测 R²;ρ 或 WX 系数不单独证明邻域因果传播。
A-164 最优尺度锚点偏移(Δ_a)
\[\Delta_{a} = |s_{a}^{*} - s_{baseline}^{*}|.\]
**理论与方法:**Δ_a 比较候选对齐锚点情景的最优尺度 s_a* 与基准锚点最优尺度之差,度量网格相位敏感性。**实现与判读:**值越小表示尺度结论对锚点更稳健;它只比较主尺度位置,仍需同时检查得分、平台和样本数变化。
贝叶斯网络分析
A-165 贝叶斯网络联合概率分解
\[P(X_{1},\ldots,X_{p}) = \prod_{i = 1}^{p}P\left( X_{i} \mid Pa(X_{i}) \right).\]
**理论与方法:**贝叶斯网络以有向无环图(DAG)表达变量的条件依赖结构,并把联合分布分解为各节点在其父节点条件下的概率乘积;Pa(X_i) 表示 X_i 的父节点集合。**实现与判读:**该分解使结构评分、条件概率表估计和后验推理可分节点计算;从观测数据学习到的箭头是当前变量、离散化与评分约束下的统计方向,不能单独作为严格因果证明。
A-166 贝叶斯网络共同完整样本(D_complete)
\[D_{complete} = {i:\forall j,\ x}_{ij}\ is\ finite\]
**理论与方法:**剔除高缺失、恒定、无有效值和离散重复列后,对保留节点取共同完整样本。当前流程不填补缺失;保存筛选原因与覆盖率,避免人工补值制造概率关系。
A-167 低基数变量直接状态编码
\[state(x) = {index}_{0}\left( x;sort(unique(x)) \right).\]
**理论与方法:**当连续变量的不同有效值数不超过设定分箱数 B 时,按数值升序排列唯一值,并将其直接编码为从 0 开始的离散状态。**实现与判读:**这种 ordinal_numeric 编码避免不必要的分位切割,状态编号只用于计算,其可解释含义来自保存的原始取值范围,而不是编号本身的距离。
A-168 连续变量分位数分箱(state / Q_B)
\[{state(x}_{j}{) = qcut(x}_{j},B,duplicates = drop)\]
**理论与方法:**直接对原始数值 qcut 并删除重复边界,保持同值同状态,不采用 first 秩。若强并列使状态坍塌,使用保存阈值的两状态原值切分。保存最终状态范围、边界和标签,实际箱数可少于请求值。
A-169 分类变量高频类别合并(top_categories)
\[x_{j}’ = \left\{ \begin{matrix} x_{j}, & x_{j} \in \mathcal{C}_{top(B - 1)}, \\ \text{other}, & \text{其他}. \end{matrix} \right.\ \]
**理论与方法:**分类变量类别数超过 B 时,按频数保留前 B−1 个类别,其余类别合并为 other,以限制条件概率表的状态规模。**实现与判读:**该 top_categories 规则降低稀疏组合与参数爆炸风险;other 是多个低频类别的汇总状态,不能解释为单一自然类别。
A-170 贝叶斯网络节点参数量(k_i)
\[k_{i}{= (r}_{i}{- 1)q}_{i}\]
理论与方法:pgmpy BIC 的节点自由参数为 (r_i−1)q_i,其中 q_i 为父节点完整状态组合数。结构评分采用 pgmpy 的真实状态空间,不用自建 max(1,·) 近似替代。
A-171 有父节点的局部对数似然(ℓ_i)
\[\mathcal{l}_{i} = \sum_{j = 1}^{q_{i}}{\sum_{k = 1}^{r_{i}}N_{ijk}}\ln\frac{N_{ijk}}{N_{ij}}.\]
**理论与方法:**对有父节点的离散节点,N_ijk 是父配置 j 下 X_i 取状态 k 的频数,N_ij 为该父配置总数;将经验条件概率 N_ijk/N_ij 代入多项分布得到局部最大化对数似然 ℓ_i。**实现与判读:**零频项不参与对数求和;样本稀疏时局部似然虽可计算,但相应条件概率的不确定性较高,应结合计数表判读。
A-172 根节点局部对数似然(ℓ_i)
\[\mathcal{l}_{i} = \sum_{k = 1}^{r_{i}}N_{ik}\ln\frac{N_{ik}}{n}.\]
**理论与方法:**根节点没有父节点,其局部对数似然由各状态频数 N_ik 与总样本数 n 构成,相当于对边缘多项分布进行最大似然拟合。**实现与判读:**该项衡量根节点状态分布的拟合贡献,并与其他节点局部得分相加形成网络总分;低频状态仍应结合实际样本数解释。
A-173 局部与全局 BIC 评分
\[BIC_{i} = \mathcal{l}_{i} - \frac{1}{2}k_{i}\ln n,\quad\quad BIC(G) = \sum_{i}^{}BIC_{i}.\]
**理论与方法:**本实现定义 BIC_i=ℓ_i−(k_i/2)ln n,在局部拟合度与参数复杂度之间折中,全局 BIC(G) 为所有节点局部得分之和。**实现与判读:**此处采用“数值越大越优”的记号,与文献中常见的 −2ℓ+k ln n、数值越小越优只差线性变换;比较结果时必须使用同一记号和同一数据集。
A-174 最终网络删边 BIC 损失(ΔBIC_e)
\[{\Delta BIC}_{e}{= BIC(G}_{final}{) - BIC(G}_{final} \smallsetminus e)\]
理论与方法:导出边指标为 BIC(G_final)−BIC(G_final去掉e),比较删除边前后的子节点局部评分。它是最终结构的条件评分支持,不是搜索操作历史、显著性或因果强度。
A-175 贪心结构搜索更新规则
\[G^{(t + 1)} = \arg\max_{G’\mathcal{\in N(}G^{(t)})}BIC(G’),\]
**理论与方法:**贪心 Hill-Climb 在当前 DAG 的合法邻域 N(G^(t)) 中选择 BIC 最大的候选网络,邻域由不形成环且满足父节点上限的增边、删边和反转边组成。**实现与判读:**搜索在没有足够改进时提前收敛;由于局部最优依赖初始结构,软件通过随机重启提高找到更优结构的机会。
A-176 固定随机重启预算(R)
\[{R = R}_{user}{,\ R}_{default}{= 3,\ seed}_{default} = 42\]
**理论与方法:**每尺度采用用户给定的固定重启次数,默认 R=3,基础种子 42。并行仅改变调度,不改变重启数、随机预算或成果签名语义。
A-177 多重重启最优 DAG(G_s*)
\[G_{s}^{*} = arg\max_{r = 1,\ldots,R}BIC(G_{s,r}).\]
**理论与方法:**对尺度 s 的 R 次有效重启结果,选择总 BIC 最大的有向无环图 G_s* 作为该尺度最终网络。**实现与判读:**重启只改变搜索初始结构与随机种子,数据、离散化和约束保持一致;应同时保留最佳重启编号和各次得分,以支持成果追溯。
A-178 自适应分箱数(B)
\[B = \left\{ \begin{matrix} 3, & n_{\min} < 40\text{ }\text{或}\text{ }c > 0.60, \\ 5, & n_{\min} \geq 250\text{ }\text{且}\text{ }p \leq 24, \\ 4, & \text{其他}. \end{matrix} \right.\ \]
**理论与方法:**自适应分箱数 B 根据各尺度最小样本量 n_min 和复杂度比 c=p/n_min 设置:小样本或变量相对过多时用 3 箱,样本充足且变量不多时用 5 箱,其余用 4 箱。**实现与判读:**该规则在状态分辨率与条件概率表稀疏性之间折中;p 为入网变量数,最终 B 仍受界面允许范围约束,并可依据研究语义人工复核。
A-179 自适应最大结构搜索迭代数(I)
\[I = 30 + 5p + 12L + 18P_{\max},\]
**理论与方法:**自适应最大迭代数 I=30+5p+12L+18P_max 随变量数 p、有效尺度数 L 和最大父节点数 P_max 增加,为更大搜索空间提供更多结构调整机会。**实现与判读:**小样本时软件进一步限制迭代上限,最终截断到界面允许的 1—500;若提前收敛,实际迭代可少于 I。
A-180 自适应最小 BIC 改进阈值(δ_min)
\[\delta_{\min} = \left\{ \begin{matrix} 0.05, & n_{\min} < 40, \\ 0.02, & 40 \leq n_{\min} < 120, \\ 0.01, & 120 \leq n_{\min} < 300, \\ 0.005, & n_{\min} \geq 300. \end{matrix} \right.\ \]
**理论与方法:**最小 BIC 改进阈值 δ_min 随最小样本量 n_min 增大而逐级降低,小样本采用更保守阈值以抑制偶然结构调整,大样本允许识别较小但稳定的得分改善。**实现与判读:**候选网络只有在 ΔBIC>δ_min 时更新;阈值控制搜索保守度,不代表统计显著性水平。
A-181 BDeu 条件概率估计(CPT)
\[{P(X}_{i}{= k|Pa}_{i} = j) = \frac{N_{ijk}{+ ESS/(r}_{i}q_{i})}{N_{ij}{+ ESS/q}_{i}}\]
理论与方法:pgmpy 使用 BDeu 先验,等效样本量 ESS 默认 5;每个节点完整状态单元的伪计数为 ESS/(r_i q_i)。CPT 枚举全部父配置,观测为零时标记仅先验,不能称为实测支持概率。
A-182 BDeu 根节点边缘概率
\[{P(X}_{i} = k) = \frac{N_{ik}{+ ESS/r}_{i}}{n + ESS}\]
理论与方法:根节点也使用 BDeu 先验,概率为 (N_ik+ESS/r_i)/(n+ESS),保存观测数和先验伪计数。它描述当前完整样本及先验下的状态分布。
A-183 条件概率表读表示例
\[\widehat{P}(X = 1 \mid A = 2,B = 0) = 0.475.\]
**理论与方法:**P(X=1|A=2,B=0)=0.475 是条件概率表的读表示例,表示在父节点 A、B 分别处于指定状态时,X 处于状态 1 的经验条件概率为 47.5%。**实现与判读:**数值仅用于说明 CPT 的条件语义,不代表固定业务阈值;实际解释须替换为成果表中的变量名、状态范围、概率和样本计数。
A-184 Markov Blanket 集合定义(MB(X))
\[MB(X) = Pa(X) \cup Ch(X) \cup \bigcup_{Y \in Ch(X)}Pa(Y)\backslash\{ X\}.\]
**理论与方法:**节点 X 的 Markov Blanket 由其父节点 Pa(X)、子节点 Ch(X) 及各子节点的其他父节点共同组成,并从集合中排除 X 本身。**实现与判读:**该集合概括在当前网络结构下与 X 直接相关的最小局部变量组,可用于局部解释与变量筛选;成员关系随学习到的 DAG 而变化。
A-185 Markov Blanket 条件独立性质
\[X \perp V\backslash(\{ X\} \cup MB(X)) \mid MB(X).\]
**理论与方法:**在贝叶斯网络满足 Markov 性质时,给定 MB(X) 后,X 与网络中其余非 Blanket 节点条件独立。**实现与判读:**该性质支持只用局部邻接变量进行 X 的概率预测;它依赖当前 DAG 与概率分布假设,不能外推为所有机制层面的独立关系。
A-186 有向边跨尺度复现率(Recurrence)
\[Recurrence(e) = \frac{L_{e}}{L_{eligible}(a,b)}\]
理论与方法:分母为有向边两端节点均有效的尺度数,分子为该方向实际出现尺度数。反向边分别计数;至少两个可比较尺度才判稳定,不等同于独立 Bootstrap、因果可靠度或预测验证。
A-187 稳定边阈值判据(τ_stable)
\[{Recurrence(e) \geq \tau}_{stable}{,\ L}_{eligible} \geq 2\]
理论与方法:在两端节点有效尺度数至少为 2 的条件下,以用户阈值判定复现边,默认 0.60。单尺度不标为跨尺度稳定;汇总边用于结构比较,不能当作完整概率模型推断。
A-188 变量消元后验概率(P(Q|e))
\[P(Q \mid e) = \frac{1}{Z}\sum_{\mathbf{H}}^{}{\prod_{i = 1}^{p}P}(X_{i} \mid Pa_{i}),\]
理论与方法:pgmpy VariableElimination 对单尺度完整网络计算后验,证据状态使用保存的离散化标签。非法状态、矛盾或无正概率支持证据、缺失/损坏 CPT 明确拒绝,不退回均匀分布。
A-189 因子乘法与变量求和消元(φ_aφ_b / φ′)
\[(\phi_{a}\phi_{b})(\mathbf{z}) = \phi_{a}(\mathbf{z}_{a})\phi_{b}(\mathbf{z}_{b}),\quad\quad\phi’(\mathbf{z}_{- X}) = \sum_{X}^{}\phi(\mathbf{z}_{- X},X).\]
**理论与方法:**因子乘法在共同变量赋值一致时相乘两个局部因子,求和消元则对待消变量 X 的所有状态求和,生成不再含 X 的新因子。**实现与判读:**按消元顺序重复这两步可计算边缘或条件后验;不同顺序结果相同,但中间因子规模和计算成本可能显著不同。
A-190 先验—后验概率变化(ΔP_k)
\[\Delta P_{k} = P(Q = k \mid e) - P(Q = k).\]
**理论与方法:**ΔP_k 用证据条件下查询状态 k 的后验概率减去无证据时的先验概率,正值表示该证据提高该状态概率,负值表示降低。**实现与判读:**它是相对于当前网络基线的概率变化,不是实验处理效应;应同时给出先验、后验和证据状态。
A-191 最大状态概率变化(Δ_max)
\[\Delta_{\max}(X) = \max_{k}|P(X = k \mid e) - P(X = k)|,\]
**理论与方法:**Δ_max(X) 取变量 X 所有状态先验—后验概率差的最大绝对值,用一个数概括证据对该变量分布的最大扰动。**实现与判读:**值越大表示至少一个状态受证据影响越明显,但不显示变化方向或涉及状态,需结合逐状态 ΔP_k 查看。
A-192 Jensen–Shannon 散度(JS)
\[JS(P,Q) = \frac{1}{2}KL_{2}(P \parallel M) + \frac{1}{2}KL_{2}(Q \parallel M),\]
**理论与方法:**Jensen–Shannon 散度以混合分布 M=(P+Q)/2 为参照,平均两个方向的以 2 为底 KL 散度,度量先验分布 P 与后验分布 Q 的整体差异。**实现与判读:**JS 对称、有限,在对数底为 2 时位于 0—1;0 表示两分布相同,较大值表示证据引起更显著的分布重排。
A-193 Kullback–Leibler 散度(KL₂)
\[KL_{2}(P \parallel M) = \sum_{k:P_{k} > 0,M_{k} > 0}^{}P_{k}\log_{2}\frac{P_{k}}{M_{k}}.\]
**理论与方法:**KL₂(P∥M) 对 P_k>0 且 M_k>0 的状态累加 P_k log₂(P_k/M_k),衡量用 M 近似 P 的定向信息损失。**实现与判读:**KL 本身不对称,因此软件将其与反向项组合为 JS;零概率项按极限贡献 0 处理,并应避免把 KL 单独解释为距离。
Landsat -> 地表温度反演(LST)
A-194 QA_PIXEL 有效像元掩膜(M_QA)
\[M_{QA} = \neg b_{0} \land \neg b_{1} \land \neg b_{2} \land \neg b_{3} \land \neg b_{4} \land \neg b_{5}\]
**理论与方法:**M_QA 对 QA_PIXEL 的第 0—5 位执行逻辑非与合取,依次排除填充值、扩张云、卷云、云、云影和雪,得到 Level-2 有效像元掩膜。**实现与判读:**只有六个质量位均未置位的像元参与后续温度与蒸散发计算;位序按 Landsat Collection 2 QA 定义读取,掩膜不会修复被剔除像元。
Landsat Collection 2 QA_PIXEL 的 bit0–bit5 分别对应 Fill、Dilated Cloud、Cirrus、Cloud、Cloud Shadow 和 Snow;六个位均未置位时判为有效。
A-195 NDVI 植被分数与地表发射率(p_v / ε)
\[p_{v} = \left( \frac{NDVI - {NDVI}_{\min}}{{NDVI}_{\max} - {NDVI}_{\min} + 10^{- 6}} \right)^{2},\quad\quad\varepsilon = clip(0.004p_{v} + 0.986,0.95,0.99)\]
**理论与方法:**植被分数 p_v 由 NDVI 在场景最小—最大范围内归一化后平方得到,再用 ε=0.004p_v+0.986 估计地表发射率并限制在 0.95—0.99。**实现与判读:**该关系用于地表覆盖与发射率一致性的质量约束;在直接读取 Level-2 ST_B10 温度产品时,不重复替代 USGS 已完成的大气与发射率校正。
当前 Level-2 流程读取 NDVI 并估计发射率,用于有效像元和质量约束;不重复改写已由 ST_B10 给出的地表温度主链。
A-196 Landsat Level-2 ST_B10 缩放至开尔文温度(LST_K)
\[{LST}_{K} = 0.00341802\, DN_{ST\_ B10} + 149.0\]
**理论与方法:**Landsat Collection 2 Level-2 的 ST_B10 数字量化值按官方比例因子 0.00341802 和加性偏移 149.0 转换为开尔文地表温度 LST_K。**实现与判读:**仅对通过质量掩膜且处于有效量化范围的像元缩放;代码也识别已经处于合理开尔文范围的输入,避免重复缩放。
与当前处理器常量一致;缩放后仅保留 230–360 K 的有限像元。
A-197 开尔文—摄氏温标转换(LST_℃)
\[{LST}_{^{\circ}C} = {LST}_{K} - 273.15\]
**理论与方法:**摄氏地表温度通过 LST_℃=LST_K−273.15 由绝对温标转换,温差大小在开尔文和摄氏标度下保持一致。**实现与判读:**转换只改变温标零点,不改变空间格局;无效值和质量掩膜应在两种温标输出中保持一致。
输出可选择 K 或 ℃;无效像元按 GeoTIFF NoData=-9999 写出。
Landsat -> 实际蒸散发估算(场景冷热端 / 简化 SSEB 思想)
A-198 蒸散发分数(ETf)
\[ETf = clip\left( \frac{T_{h} - T_{s}}{T_{h} - T_{c}},0,1 \right)\]
**理论与方法:**蒸散发分数 ETf 以场景热端温度 T_h、冷端温度 T_c 和像元地表温度 T_s 进行线性归一化,并截断到 0—1;接近冷端表示潜在蒸散较强,接近热端表示水分受限。**实现与判读:**冷热端由逐景有效候选像元的稳健分位统计确定,因此 ETf 是简化表面能量平衡思想下的相对分数,不是直接观测蒸散量;端元代表性和云掩膜质量会影响结果。
冷端由高 NDVI、低温候选像元的低百分位确定,热端由低 NDVI、非水体候选像元的高百分位确定。
A-199 实际蒸散发估算(ETa_day / ETa_8day)
\[{ETa}_{day} = ETf \cdot ETo,\quad\quad{ETa}_{8day} = 8\,{ETa}_{day}\]
**理论与方法:**日实际蒸散发估算量 ETa_day 由 ETf 与同日参考蒸散发 ETo 相乘得到;当以日值代表八日窗口时,ETa_8day=8ETa_day。**实现与判读:**ETo 和输出通常以 mm·d⁻¹、mm·8 d⁻¹ 表示;结果是受输入温度、冷热端、ETo 时空匹配和质量掩膜共同约束的产品估算值,宜通过地面或独立产品验证其区域适用精度。
ETo 为日尺度参考蒸散发输入;mm/day 表示单景日尺度估算值,mm/8-day 为日值乘 8 的近似外推量,绝对量应用需校准验证。
A.2 行内数学表达与符号索引
下列索引收录应用内文档中去重后的行内数学表达。纯文件名、普通代码键和不构成数学含义的短文本不重复列入。
-
A2-001 \(R_{\cdot}\) — 分割采样与空间区划
-
A2-002 \(\frac{R_{NIR} - R_{RED}}{R_{NIR} + R_{RED}}\) — 分割采样与空间区划
-
A2-003 \(2.5 \cdot \frac{R_{NIR} - R_{RED}}{R_{NIR} + 6R_{RED} - 7.5R_{BLUE} + 1}\) — 分割采样与空间区划
-
A2-004 \((1 + L) \cdot \frac{R_{NIR} - R_{RED}}{R_{NIR} + R_{RED} + L}\) — 分割采样与空间区划
-
A2-005 \(L = 0.5\) — 分割采样与空间区划
-
A2-006 \(\frac{R_{GREEN} - R_{SWIR1}}{R_{GREEN} + R_{SWIR1}}\) — 分割采样与空间区划
-
A2-007 \(\frac{R_{SWIR1} - R_{NIR}}{R_{SWIR1} + R_{NIR}}\) — 分割采样与空间区划
-
A2-008 \(X \in \mathbb{R}^{H \times W \times C}\) — 分割采样与空间区划
-
A2-009 \(\rho_{\lambda}\) — Landsat -> 土地覆盖(LC)
-
A2-010 \(\lambda \in \{\text{BLUE,GREEN,RED,NIR,SWIR1,SWIR2}\}\) — Landsat -> 土地覆盖(LC)
-
A2-011 \(\lbrack - 1,1\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-012 \(1 \times 10^{- 5}\) — Landsat -> 土地覆盖(LC)
-
A2-013 \(z(x,y)\) — Landsat -> 土地覆盖(LC)
-
A2-014 \(\Delta x,\Delta y\) — Landsat -> 土地覆盖(LC)
-
A2-015 \(\mathcal{N}\) — Landsat -> 土地覆盖(LC)
-
A2-016 \(z_{0}\) — Landsat -> 土地覆盖(LC)
-
A2-017 \(w \times w\) — Landsat -> 土地覆盖(LC)
-
A2-018 \(\partial z/\partial x,\partial z/\partial y\) — Landsat -> 土地覆盖(LC)
-
A2-019 \(\beta\) — Landsat -> 土地覆盖(LC)
-
A2-020 \(ln(1 + a)\) — Landsat -> 土地覆盖(LC)
-
A2-021 \(\tan\beta\) — Landsat -> 土地覆盖(LC)
-
A2-022 \(\text{acc}\) — Landsat -> 土地覆盖(LC)
-
A2-023 \(\tau\) — Landsat -> 土地覆盖(LC)
-
A2-024 \(\mathcal{N}\) — Landsat -> 土地覆盖(LC)
-
A2-025 \(g \in \{ 0,\ldots,L - 1\}\) — Landsat -> 土地覆盖(LC)
-
A2-026 \(\theta \in \{ 0^{\circ},45^{\circ},90^{\circ},135^{\circ}\}\) — Landsat -> 土地覆盖(LC)
-
A2-027 \((\Delta x,\Delta y)\) — Landsat -> 土地覆盖(LC)
-
A2-028 \(d,\theta\) — Landsat -> 土地覆盖(LC)
-
A2-029 \(\sum_{i,j}^{}P(i,j) = 1\) — Landsat -> 土地覆盖(LC)
-
A2-030 \(\theta\) — Landsat -> 土地覆盖(LC)
-
A2-031 \(R(g,r;\theta)\) — Landsat -> 土地覆盖(LC)
-
A2-032 \(r \geq 1\) — Landsat -> 土地覆盖(LC)
-
A2-033 \(g_{c}\) — Landsat -> 土地覆盖(LC)
-
A2-034 \(g_{p}\) — Landsat -> 土地覆盖(LC)
-
A2-035 \(s(x\mathbb{) = I\lbrack}x \geq 0\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-036 \(P(i,j)\) — Landsat -> 土地覆盖(LC)
-
A2-037 \(P(i,j) = P(j,i)\) — Landsat -> 土地覆盖(LC)
-
A2-038 \(\lbrack 0,\infty)\) — Landsat -> 土地覆盖(LC)
-
A2-039 \((0,1\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-040 \(ASM \in (0,1\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-041 \(P(i,j) = 0\) — Landsat -> 土地覆盖(LC)
-
A2-042 \(0\log 0 = 0\) — Landsat -> 土地覆盖(LC)
-
A2-043 \(\sigma_{i}\) — Landsat -> 土地覆盖(LC)
-
A2-044 \(\sigma_{j}\) — Landsat -> 土地覆盖(LC)
-
A2-045 \(g = \frac{i + j}{2}\) — Landsat -> 土地覆盖(LC)
-
A2-046 \(\mu\) — Landsat -> 土地覆盖(LC)
-
A2-047 \(var/std\) — Landsat -> 土地覆盖(LC)
-
A2-048 \(R(g,r)\) — Landsat -> 土地覆盖(LC)
-
A2-049 \(p_{r} = \sum_{g}^{}R(g,r)\) — Landsat -> 土地覆盖(LC)
-
A2-050 \(p_{g} = \sum_{r}^{}R(g,r)\) — Landsat -> 土地覆盖(LC)
-
A2-051 \(N_{r} = \sum_{g,r}^{}R(g,r)\) — Landsat -> 土地覆盖(LC)
-
A2-052 \(N_{p}\) — Landsat -> 土地覆盖(LC)
-
A2-053 \(LBP\) — Landsat -> 土地覆盖(LC)
-
A2-054 \(\leq 2\) — Landsat -> 土地覆盖(LC)
-
A2-055 \(H(k)\) — Landsat -> 土地覆盖(LC)
-
A2-056 \(p_{k} = H(k)/\sum H\) — Landsat -> 土地覆盖(LC)
-
A2-057 \(\mathcal{U}\) — Landsat -> 土地覆盖(LC)
-
A2-058 \(P = 8\) — Landsat -> 土地覆盖(LC)
-
A2-059 \(R = 1\) — Landsat -> 土地覆盖(LC)
-
A2-060 \(R = 2\) — Landsat -> 土地覆盖(LC)
-
A2-061 \(L = 16\) — Landsat -> 土地覆盖(LC)
-
A2-062 \(w = 5/7\) — Landsat -> 土地覆盖(LC)
-
A2-063 \((i,j)\) — Landsat -> 土地覆盖(LC)
-
A2-064 \(\binom{N}{2}\) — Landsat -> 土地覆盖(LC)
-
A2-065 \(t_{1}\) — Landsat -> 土地覆盖(LC)
-
A2-066 \(t_{2}\) — Landsat -> 土地覆盖(LC)
-
A2-067 \(\Delta I > 0\) — Landsat -> 土地覆盖(LC)
-
A2-068 \(\Delta I < 0\) — Landsat -> 土地覆盖(LC)
-
A2-069 \(I \in \lbrack - 1,1\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-070 \(\Delta I \in \lbrack - 2,2\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-071 \(\Delta > 0\) — Landsat -> 土地覆盖(LC)
-
A2-072 \(\Delta < 0\) — Landsat -> 土地覆盖(LC)
-
A2-073 \(NBR_{后} - NBR_{前}\) — Landsat -> 土地覆盖(LC)
-
A2-074 \(NBR_{**前**} - NBR_{**后**}\) — Landsat -> 土地覆盖(LC)
-
A2-075 \(- dNBR\) — Landsat -> 土地覆盖(LC)
-
A2-076 \(X_{t}\) — Landsat -> 土地覆盖(LC)
-
A2-077 \(t = 1,\ldots,n\) — Landsat -> 土地覆盖(LC)
-
A2-078 \(n < 2\) — Landsat -> 土地覆盖(LC)
-
A2-079 \(- \infty/ + \infty\) — Landsat -> 土地覆盖(LC)
-
A2-080 \(- \infty\) — Landsat -> 土地覆盖(LC)
-
A2-081 \(p_{b}\) — Landsat -> 土地覆盖(LC)
-
A2-082 \((a,b,c,d,e,f)\) — Landsat -> 土地覆盖(LC)
-
A2-083 \(A\mathcal{(P)}\) — Landsat -> 土地覆盖(LC)
-
A2-084 \(L\mathcal{(P)}\) — Landsat -> 土地覆盖(LC)
-
A2-085 \(Comp \in (0,1\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-086 \(\{ x_{i}\}_{i = 1}^{n}\) — Landsat -> 土地覆盖(LC)
-
A2-087 \(\sigma\) — Landsat -> 土地覆盖(LC)
-
A2-088 \(\sigma \leq \tau\) — Landsat -> 土地覆盖(LC)
-
A2-089 \(\overline{\sigma} \leq \tau\) — Landsat -> 土地覆盖(LC)
-
A2-090 \(n < n_{\min}\) — Landsat -> 土地覆盖(LC)
-
A2-091 \(\mathbf{z}\) — Landsat -> 土地覆盖(LC)
-
A2-092 \(\frac{4\pi A}{L^{2}}\) — Landsat -> 土地覆盖(LC)
-
A2-093 \(Comp \rightarrow 1\) — Landsat -> 土地覆盖(LC)
-
A2-094 \(y_{ij}\) — Landsat -> 土地覆盖(LC)
-
A2-095 \(z_{j}\) — Landsat -> 土地覆盖(LC)
-
A2-096 \(\tau \in \lbrack 0.04,0.08\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-097 \(\tau \in \lbrack 0.03,0.07\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-098 \(\tau \in \lbrack 0.05,0.10\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-099 \(\theta = 0.20\) — Landsat -> 土地覆盖(LC)
-
A2-100 \(\{ x_{i}\}_{i = 1}^{n}\) — Landsat -> 土地覆盖(LC)
-
A2-101 \(\mu = \frac{1}{n}\sum_{i = 1}^{n}x_{i}\) — Landsat -> 土地覆盖(LC)
-
A2-102 \(Q_{0.5}\) — Landsat -> 土地覆盖(LC)
-
A2-103 \(Q_{0.25},\, Q_{0.75}\) — Landsat -> 土地覆盖(LC)
-
A2-104 \(ddof = 0\) — Landsat -> 土地覆盖(LC)
-
A2-105 \(\sigma = \sqrt{\frac{1}{n}\sum_{i = 1}^{n}(x_{i} - \mu)^{2}}\) — Landsat -> 土地覆盖(LC)
-
A2-106 \(IQR = Q_{0.75} - Q_{0.25}\) — Landsat -> 土地覆盖(LC)
-
A2-107 \(X \in \mathbb{R}^{n \times K}\) — Landsat -> 土地覆盖(LC)
-
A2-108 \(\mathbf{\mu}\) — Landsat -> 土地覆盖(LC)
-
A2-109 \(d_{i} = \parallel \mathbf{x}_{i} - \mathbf{\mu} \parallel_{2}\) — Landsat -> 土地覆盖(LC)
-
A2-110 \(q = {Quantile}_{\alpha}(d)\) — Landsat -> 土地覆盖(LC)
-
A2-111 \(d_{i} \leq q\) — Landsat -> 土地覆盖(LC)
-
A2-112 \(\alpha\) — Landsat -> 土地覆盖(LC)
-
A2-113 \((r,c)\) — Landsat -> 土地覆盖(LC)
-
A2-114 \(IQR = Q_{0.75} - Q_{0.25}\) — Landsat -> 土地覆盖(LC)
-
A2-115 \(\alpha \in (0,1\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-116 \(|r_{pq}| \geq r_{\text{thr}}\) — Landsat -> 土地覆盖(LC)
-
A2-117 \(\rightarrow\) — Landsat -> 土地覆盖(LC)
-
A2-118 \(\geq m\) — Landsat -> 土地覆盖(LC)
-
A2-119 \(\leq 20\) — Landsat -> 土地覆盖(LC)
-
A2-120 \(p_{c} \geq t_{c}^{\star}\) — Landsat -> 土地覆盖(LC)
-
A2-121 \(\arg\max_{c}\, p_{c}\) — Landsat -> 土地覆盖(LC)
-
A2-122 \((\mu,\sigma)\) — Landsat -> 土地覆盖(LC)
-
A2-123 \(\mathbf{p}_{i} = (p_{i1},\ldots,p_{iC})\) — Landsat -> 土地覆盖(LC)
-
A2-124 \(\mathbf{t} = (t_{1},\ldots,t_{C})\) — Landsat -> 土地覆盖(LC)
-
A2-125 \(\Omega\) — Landsat -> 土地覆盖(LC)
-
A2-126 \(\alpha = 0\) — Landsat -> 土地覆盖(LC)
-
A2-127 \(\gamma = 1.5\) — Landsat -> 土地覆盖(LC)
-
A2-128 \(\lambda \approx 0.35\) — Landsat -> 土地覆盖(LC)
-
A2-129 \(M \in \{ 0,\ldots,K\} \cup \{ 255\}\) — Landsat -> 土地覆盖(LC)
-
A2-130 \(R \in \{ 0,\ldots,K\} \cup \{ 255\}\) — Landsat -> 土地覆盖(LC)
-
A2-131 \(p_{t} \in \lbrack 0,1\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-132 \(\mathbf{p} = (p_{0},\ldots,p_{K})\) — Landsat -> 土地覆盖(LC)
-
A2-133 \(\sum_{c}^{}p_{c} = 1\) — Landsat -> 土地覆盖(LC)
-
A2-134 \(M_{ij} = 255\) — Landsat -> 土地覆盖(LC)
-
A2-135 \(F_{ij} = 255\) — Landsat -> 土地覆盖(LC)
-
A2-136 \(|\Omega|\) — Landsat -> 土地覆盖(LC)
-
A2-137 \(\{ 0,\ldots,K\} \cup \{ 255\}\) — Landsat -> 土地覆盖(LC)
-
A2-138 \(\tau \in (0,1\rbrack\) — Landsat -> 土地覆盖(LC)
-
A2-139 \(p_{t} \geq \tau\) — Landsat -> 土地覆盖(LC)
-
A2-140 \(\mathcal{S(}\tau) = \{(i,j) \mid M_{ij} \neq t,R_{ij} = t,p_{t,ij} \geq \tau\}\) — Landsat -> 土地覆盖(LC)
-
A2-141 \(\tau_{1} < \tau_{2}\mathcal{\Rightarrow S(}\tau_{2}\mathcal{) \subseteq S(}\tau_{1})\) — Landsat -> 土地覆盖(LC)
-
A2-142 \(p_{t}\) — Landsat -> 土地覆盖(LC)
-
A2-143 \(\mathbb{B = \{(}i,j) \mid R_{ij} = t,\ p_{t,ij} \geq \tau\}\) — Landsat -> 土地覆盖(LC)
-
A2-144 \(\{\Omega_{m}\}\) — Landsat -> 土地覆盖(LC)
-
A2-145 \(\bar{p}(\Omega_{m}) \geq \alpha\) — Landsat -> 土地覆盖(LC)
-
A2-146 \(|\Omega_{m}| > n_{\min}\) — Landsat -> 土地覆盖(LC)
-
A2-147 \(n_{\min}\) — Landsat -> 土地覆盖(LC)
-
A2-148 \(\alpha \approx 0.7,\ n_{\min} \approx 10\) — Landsat -> 土地覆盖(LC)
-
A2-149 \(\mathbb{B}\) — Landsat -> 土地覆盖(LC)
-
A2-150 \(\alpha \uparrow\) — Landsat -> 土地覆盖(LC)
-
A2-151 \(n_{\min} \uparrow\) — Landsat -> 土地覆盖(LC)
-
A2-152 \(\mathbf{p}\) — Landsat -> 土地覆盖(LC)
-
A2-153 \(M_{ij} \neq t\) — Landsat -> 土地覆盖(LC)
-
A2-154 \(p_{t,ij} \geq a\) — Landsat -> 土地覆盖(LC)
-
A2-155 \(M_{ij} = t\) — Landsat -> 土地覆盖(LC)
-
A2-156 \(p_{t,ij} < r\) — Landsat -> 土地覆盖(LC)
-
A2-157 \(\arg\max_{c}p_{c,ij}\) — Landsat -> 土地覆盖(LC)
-
A2-158 \({\widetilde{p}}_{\text{other}} = 1 - p_{t}\) — Landsat -> 土地覆盖(LC)
-
A2-159 \(a \uparrow\) — Landsat -> 土地覆盖(LC)
-
A2-160 \(r \downarrow\) — Landsat -> 土地覆盖(LC)
-
A2-161 \(m \uparrow\) — Landsat -> 土地覆盖(LC)
-
A2-162 \(_{\beta}\) — Landsat -> 土地覆盖(LC)
-
A2-163 \(O(HW)\) — Landsat -> 土地覆盖(LC)
-
A2-164 \(\tau \approx 0.6 \sim 0.7\) — Landsat -> 土地覆盖(LC)
-
A2-165 \(\alpha \approx 0.7\) — Landsat -> 土地覆盖(LC)
-
A2-166 \(n_{\min} \approx 10\) — Landsat -> 土地覆盖(LC)
-
A2-167 \(a \approx 0.8\) — Landsat -> 土地覆盖(LC)
-
A2-168 \(r \approx 0.6\) — Landsat -> 土地覆盖(LC)
-
A2-169 \(m \approx 0.2\) — Landsat -> 土地覆盖(LC)
-
A2-170 \(\beta > 1\) — Landsat -> 土地覆盖(LC)
-
A2-171 \(\mathbf{X}_{i}(s)\) — 空间结构关系分析总览
-
A2-172 \(\mathbf{C}_{i}(s)\) — 空间结构关系分析总览
-
A2-173 \(\mathbf{Y}_{i}(s)\) — 空间结构关系分析总览
-
A2-174 \(\mathcal{G}\) — 空间结构关系分析总览
-
A2-175 \(f( \cdot )\) — 空间结构关系分析总览
-
A2-176 \({\overrightarrow{\varepsilon}}_{i}\) — 空间结构关系分析总览
-
A2-177 \(G_{i}\) — 空间结构关系分析总览
-
A2-178 \(V_{i} = \{ v_{i1},\ldots,v_{in_{i}}\}\) — 空间结构关系分析总览
-
A2-179 \({\bar{v}}_{i} = \frac{1}{n_{i}}\sum_{j = 1}^{n_{i}}v_{ij}\) — 空间结构关系分析总览
-
A2-180 \(median(V_{i})\) — 空间结构关系分析总览
-
A2-181 \(\sigma_{i} = \sqrt{\frac{1}{n_{i}}\sum_{j}^{}(v_{ij} - {\bar{v}}_{i})^{2}}\) — 空间结构关系分析总览
-
A2-182 \(min(V_{i})\) — 空间结构关系分析总览
-
A2-183 \(max(V_{i})\) — 空间结构关系分析总览
-
A2-184 \(\sum_{j}^{}v_{ij}\) — 空间结构关系分析总览
-
A2-185 \(\arg\max_{c}\sum_{j}^{}\mathbf{1}(v_{ij} = c)\) — 空间结构关系分析总览
-
A2-186 \(E_{1},E_{2},\ldots,E_{m}\) — 空间结构关系分析总览
-
A2-187 \(E_{\cap} = \varnothing\) — 空间结构关系分析总览
-
A2-188 \({CRS}^{*}\) — 空间结构关系分析总览
-
A2-189 \((r_{x},r_{y})\) — 空间结构关系分析总览
-
A2-190 \((W,H)\) — 空间结构关系分析总览
-
A2-191 \(\mathbf{X} \in \mathbb{R}^{N \times p}\) — 空间结构关系分析总览
-
A2-192 \(\mathbf{Y} \in \mathbb{R}^{N \times q}\) — 空间结构关系分析总览
-
A2-193 \(\mathbf{P}\) — 空间结构关系分析总览
-
A2-194 \(Q_{i}(s)\) — 空间结构关系分析总览
-
A2-195 \(\phi\) — 空间结构关系分析总览
-
A2-196 \(\psi\) — 空间结构关系分析总览
-
A2-197 \(\mathcal{N}_{w}(i)\) — 空间结构关系分析总览
-
A2-198 \(w \in \{ 3,5,7,\ldots\}\) — 空间结构关系分析总览
-
A2-199 \(\mathcal{A}\) — 空间结构关系分析总览
-
A2-200 \(X_{k}\) — 结构/响应特征尺度轴
-
A2-201 \(\mathcal{M}_{m}\) — 结构/响应特征尺度轴
-
A2-202 \(A_{i}\) — 结构/响应特征尺度轴
-
A2-203 \(p_{i} = A_{i}/A\) — 结构/响应特征尺度轴
-
A2-204 \(a_{ij},e_{ij}\) — 结构/响应特征尺度轴
-
A2-205 \(g_{ii}\) — 结构/响应特征尺度轴
-
A2-206 \(E_{b}\) — 结构/响应特征尺度轴
-
A2-207 \(r_{0}\) — 结构/响应特征尺度轴
-
A2-208 \(b(s)\) — 结构/响应特征尺度轴
-
A2-209 \(s/r_{0}\) — 结构/响应特征尺度轴
-
A2-210 \(r_{0} = 30\, m\) — 结构/响应特征尺度轴
-
A2-211 \(H \times W\) — 结构/响应特征尺度轴
-
A2-212 \(s_{j} = s_{0} + j\Delta s\) — 结构/响应特征尺度轴
-
A2-213 \(s_{j} = s_{0}q^{j}\) — 结构/响应特征尺度轴
-
A2-214 \(w \geq 3\) — 结构/响应特征尺度轴
-
A2-215 \(wr_{0}\) — 结构/响应特征尺度轴
-
A2-216 \(r_{0} = 30\) — 结构/响应特征尺度轴
-
A2-217 \(\bar{a} = \frac{1}{N_{p}}\sum a_{ij}\) — 结构/响应特征尺度轴
-
A2-218 \({CV}_{a} = 100\frac{\sigma(a)}{mean(a)}\) — 结构/响应特征尺度轴
-
A2-219 \(H = - \sum_{c}^{}p_{c}ln(p_{c} + 10^{- 12})\) — 结构/响应特征尺度轴
-
A2-220 \(C_{l} = {mean}_{q}\lbrack\sigma(Q_{lq})\rbrack\) — 结构/响应特征尺度轴
-
A2-221 \(\mathbf{n} = (A_{1},\ldots,A_{m})\) — 结构/响应特征尺度轴
-
A2-222 \(H = - \sum_{i = 1}^{m}p_{i}ln(p_{i} + 10^{- 12})\) — 结构/响应特征尺度轴
-
A2-223 \(SHEI = H/lnm\) — 结构/响应特征尺度轴
-
A2-224 \(m > 1\) — 结构/响应特征尺度轴
-
A2-225 \(\max_{i}p_{i}\) — 结构/响应特征尺度轴
-
A2-226 \(PD = \frac{N_{p}}{A_{ha}}\) — 结构/响应特征尺度轴
-
A2-227 \(LPI = 100max(a_{ij})/A\) — 结构/响应特征尺度轴
-
A2-228 \(SPLIT = 1/\sum_{ij}^{}(a_{ij}/A)^{2}\) — 结构/响应特征尺度轴
-
A2-229 \(DIVISION = 1 - \sum_{ij}^{}(a_{ij}/A)^{2}\) — 结构/响应特征尺度轴
-
A2-230 \(MESH = \sum_{ij}^{}a_{ij}^{2}/A\) — 结构/响应特征尺度轴
-
A2-231 \(D = slope\lbrack lnN(\epsilon),ln(1/\epsilon)\rbrack\) — 结构/响应特征尺度轴
-
A2-232 \(LSI = 0.25E_{b}/\sqrt{A}\) — 结构/响应特征尺度轴
-
A2-233 \(P_{ab} = n_{ab}/\sum_{uv}^{}n_{uv}\) — 结构/响应特征尺度轴
-
A2-234 \(H_{c} = - \sum_{ab}^{}P_{ab}ln(P_{ab} + 10^{- 12})\) — 结构/响应特征尺度轴
-
A2-235 \(P_{same} = N_{same}/N_{valid\ pairs}\) — 结构/响应特征尺度轴
-
A2-236 \(P_{trans} = E/N_{valid\ pairs}\) — 结构/响应特征尺度轴
-
A2-237 \(q_{\theta} = Pr(z_{u} = z_{v} \mid \theta)\) — 结构/响应特征尺度轴
-
A2-238 \(D_{ani} = std(q_{0},q_{45},q_{90},q_{135})\) — 结构/响应特征尺度轴
-
A2-239 \(E_{i}(类别边界长度)\) — 结构/响应特征尺度轴
-
A2-240 \(PLADJ_{i} = 100 \cdot 2g_{ii}/G_{i}\) — 结构/响应特征尺度轴
-
A2-241 \(AI_{i} = 100g_{ii}/g_{ii}^{\max}(A_{i})\) — 结构/响应特征尺度轴
-
A2-242 \(AI = \sum_{i}^{}p_{i}AI_{i}\) — 结构/响应特征尺度轴
-
A2-243 \(g_{ii}^{\max}\) — 结构/响应特征尺度轴
-
A2-244 \(CONTAG = 100\left\lbrack 1 + \frac{\sum_{i}^{}{\sum_{j}^{}p_{i}}(g_{ij}/\sum_{k}^{}g_{ik})ln\lbrack p_{i}(g_{ij}/\sum_{k}^{}g_{ik})\rbrack}{2\ln m} \right\rbrack\) — 结构/响应特征尺度轴
-
A2-245 \(IJI = - 100\frac{\sum_{k}^{}e_{k}^{*}ln(e_{k}^{*} + 10^{- 12})}{ln\lbrack m(m - 1)/2\rbrack}\) — 结构/响应特征尺度轴
-
A2-246 \(e_{k}^{*}\) — 结构/响应特征尺度轴
-
A2-247 \(COHESION = 100\frac{1 - \sum e_{ij}/\sum(e_{ij}\sqrt{a_{ij}})}{1 - 1/\sqrt{A}}\) — 结构/响应特征尺度轴
-
A2-248 \(G_{i} = 2g_{ii}/G_{i}^{total}\) — 结构/响应特征尺度轴
-
A2-249 \(G_{i} \geq p_{i}\) — 结构/响应特征尺度轴
-
A2-250 \(p_{i} < 0.5\) — 结构/响应特征尺度轴
-
A2-251 \((G_{i} - p_{i})/(1 - p_{i})\) — 结构/响应特征尺度轴
-
A2-252 \((G_{i} - p_{i})/p_{i}\) — 结构/响应特征尺度轴
-
A2-253 \(ED = \frac{E_{m}}{A_{ha}}\) — 结构/响应特征尺度轴
-
A2-254 \(ENN_{i} = {mean}_{j}\min_{k \neq j}d(P_{ij},P_{ik})\) — 结构/响应特征尺度轴
-
A2-255 \(PROX_{ij} = \sum_{k \neq j,d_{jk} \leq r}^{}a_{ik}/d_{jk}^{2}\) — 结构/响应特征尺度轴
-
A2-256 \(CONNECT_{i} = 100N_{connected}/\lbrack n_{i}(n_{i} - 1)/2\rbrack\) — 结构/响应特征尺度轴
-
A2-257 \(IE_{i} = (G_{i} - 2g_{ii})/G_{i}\) — 结构/响应特征尺度轴
-
A2-258 \(CAR_{i} = A_{i}^{core}/A_{i}\) — 结构/响应特征尺度轴
-
A2-259 \(TCA = \sum_{i}^{}A_{i}^{core}\) — 结构/响应特征尺度轴
-
A2-260 \(CAI = 100TCA/A\) — 结构/响应特征尺度轴
-
A2-261 \(LSS = {mean}_{u}\lbrack\max_{c}n_{uc}/n_{u}\rbrack\) — 结构/响应特征尺度轴
-
A2-262 \(S = \sum_{i}^{}p_{i}^{2}\) — 结构/响应特征尺度轴
-
A2-263 \(GSI = \max_{j}a_{j}/A_{valid}\) — 结构/响应特征尺度轴
-
A2-264 \(v_{1},\ldots,v_{n}\) — 结构/响应特征尺度轴
-
A2-265 \(range = \max - \min\) — 结构/响应特征尺度轴
-
A2-266 \(d = 1\) — 结构/响应特征尺度轴
-
A2-267 \(\sum_{ij}^{}(i - j)^{2}P(i,j)\) — 结构/响应特征尺度轴
-
A2-268 \(\sum_{ij}^{}|i - j|P(i,j)\) — 结构/响应特征尺度轴
-
A2-269 \(\sum_{ij}^{}\frac{P(i,j)}{1 + (i - j)^{2}}\) — 结构/响应特征尺度轴
-
A2-270 \(\sum_{ij}^{}P(i,j)^{2}\) — 结构/响应特征尺度轴
-
A2-271 \(\sqrt{ASM}\) — 结构/响应特征尺度轴
-
A2-272 \(\sum_{ij}^{}\frac{(i - \mu_{i})(j - \mu_{j})P(i,j)}{\sigma_{i}\sigma_{j}}\) — 结构/响应特征尺度轴
-
A2-273 \(c_{0}\) — 结构/响应特征尺度轴
-
A2-274 \(c_{0} + c\) — 结构/响应特征尺度轴
-
A2-275 \(r(SciKit - GStat\ 有效变程)\) — 结构/响应特征尺度轴
-
A2-276 \(g = \sqrt{g_{x}^{2} + g_{y}^{2}}\) — 结构/响应特征尺度轴
-
A2-277 \(\bar{g}\) — 结构/响应特征尺度轴
-
A2-278 \(\sigma_{g}\) — 结构/响应特征尺度轴
-
A2-279 \({Pr(g > edge}_{t}hreshold)\) — 结构/响应特征尺度轴
-
A2-280 \(F = FFT2(z - \bar{z})\) — 结构/响应特征尺度轴
-
A2-281 \(P = |F|^{2}\) — 结构/响应特征尺度轴
-
A2-282 \(H_{f} = - \sum_{k}^{}q_{k}ln(q_{k} + 10^{- 12}),\ q_{k} = P_{k}/\sum P\) — 结构/响应特征尺度轴
-
A2-283 \(\lambda^{*} = 1/f^{*}\) — 结构/响应特征尺度轴
-
A2-284 \(f^{*}\) — 结构/响应特征尺度轴
-
A2-285 \(\rho_{s} = corr(rank(x),rank(y))\) — 结构/响应特征尺度轴
-
A2-286 \(\rho_{s}\) — 结构/响应特征尺度轴
-
A2-287 \(|\rho_{s}|\) — 结构/响应特征尺度轴
-
A2-288 \(I(X;Y) = \iint p(x,y)ln\frac{p(x,y)}{p(x)p(y)}dxdy\) — 结构/响应特征尺度轴
-
A2-289 \(a_{ij} = |x_{i} - x_{j}|\) — 结构/响应特征尺度轴
-
A2-290 \(b_{ij} = |y_{i} - y_{j}|\) — 结构/响应特征尺度轴
-
A2-291 \(dCor = \frac{\sqrt{\overline{AB}}}{\sqrt{\sqrt{\overline{A^{2}}}\sqrt{\overline{B^{2}}}}}\) — 结构/响应特征尺度轴
-
A2-292 \(O(n^{2})\) — 结构/响应特征尺度轴
-
A2-293 \(q = 1 - \frac{\sum_{h}^{}N_{h}\sigma_{h}^{2}}{N\sigma^{2}}\) — 结构/响应特征尺度轴
-
A2-294 \(q \in \lbrack 0,1\rbrack\) — 结构/响应特征尺度轴
-
A2-295 \(z_{x},z_{y}\) — 结构/响应特征尺度轴
-
A2-296 \(Wz_{y}\) — 结构/响应特征尺度轴
-
A2-297 \(I_{xy} = \frac{n}{S_{0}}\frac{z_{x}^{T}(Wz_{y})}{z_{x}^{T}z_{x}}\) — 结构/响应特征尺度轴
-
A2-298 \(\min_{\beta}\frac{1}{2n} \parallel y - X\beta \parallel_{2}^{2} + \lambda\lbrack\alpha \parallel \beta \parallel_{1} + \frac{1 - \alpha}{2} \parallel \beta \parallel_{2}^{2}\rbrack\) — 结构/响应特征尺度轴
-
A2-299 \(R^{2}\) — 结构/响应特征尺度轴
-
A2-300 \(X = TP^{T} + E,\ y = Uq^{T} + f\) — 结构/响应特征尺度轴
-
A2-301 \(Cov(t,u)\) — 结构/响应特征尺度轴
-
A2-302 \(VIF_{j} = 1/(1 - R_{j}^{2})\) — 结构/响应特征尺度轴
-
A2-303 \(R^{2} = 1 - \frac{\sum(y - \widehat{y})^{2}}{\sum(y - \bar{y})^{2}}\) — 结构/响应特征尺度轴
-
A2-304 \(y_{i} = \beta_{0}(u_{i},v_{i}) + \sum_{k}^{}\beta_{k}(u_{i},v_{i})x_{ik} + \epsilon_{i}\) — 结构/响应特征尺度轴
-
A2-305 \(y = \rho Wy + X\beta + WX\theta + \epsilon\) — 结构/响应特征尺度轴
-
A2-306 \(\bar{R}(s)\) — 结构/响应特征尺度轴
-
A2-307 \(s^{*} = arg\max_{s}\bar{R}(s)\) — 结构/响应特征尺度轴
-
A2-308 \(R_{\max} > 0\) — 结构/响应特征尺度轴
-
A2-309 \(\{ s:R(s) \geq 0.95R_{\max}\}\) — 结构/响应特征尺度轴
-
A2-310 \(\{ s:R(s) \geq R_{\max} - 0.05\}\) — 结构/响应特征尺度轴
-
A2-311 \({\widetilde{R}}_{j} = 0.25R_{j - 1} + 0.5R_{j} + 0.25R_{j + 1}\) — 结构/响应特征尺度轴
-
A2-312 \(s_{sm}^{*} = argmax\widetilde{R}\) — 结构/响应特征尺度轴
-
A2-313 \(Bootstrap(未计算)\) — 结构/响应特征尺度轴
-
A2-314 \(d_{j} = (R_{j + 1} - R_{j})/(s_{j + 1} - s_{j})\) — 结构/响应特征尺度轴
-
A2-315 \(s_{b} = s_{argmax|d_{j + 1} - d_{j}| + 1}\) — 结构/响应特征尺度轴
-
A2-316 \({J = \Sigma}_{segments}{RSS + \beta K;\ length}_{segment} \geq 3\) — 结构/响应特征尺度轴
-
A2-317 \({AUC = \int}_{s_{\min}}^{s_{\max}}R(s)ds\) — 结构/响应特征尺度轴
-
A2-318 \(AUC_{norm} = AUC/(s_{\max} - s_{\min})\) — 结构/响应特征尺度轴
-
A2-319 \(s_{vario} = mean(\widehat{a})\) — 结构/响应特征尺度轴
-
A2-320 \(\Delta_{s} = |s^{*} - s_{vario}|\) — 结构/响应特征尺度轴
-
A2-321 \(独立尺度一致性(未计算)\) — 结构/响应特征尺度轴
-
A2-322 \(\mathcal{R}\) — 结构/响应特征尺度轴
-
A2-323 \(s \rightarrow b(s)\) — 结构/响应特征尺度轴
-
A2-324 \(Y = f(X \mid s)\) — 控制变量 / 多目标分析
-
A2-325 \(\mathbf{X}\) — 控制变量 / 多目标分析
-
A2-326 \(\mathbf{C}\) — 控制变量 / 多目标分析
-
A2-327 \(\mathbf{Y} = (Y_{1},\ldots,Y_{T})\) — 控制变量 / 多目标分析
-
A2-328 \(V_{i} = \{ v_{ij}\}_{j = 1}^{n_{i}}\) — 控制变量 / 多目标分析
-
A2-329 \(y_{i} = \frac{1}{n_{i}}\sum_{j}^{}v_{ij}\) — 控制变量 / 多目标分析
-
A2-330 \(y_{i} = Q_{0.5}(V_{i})\) — 控制变量 / 多目标分析
-
A2-331 \(y_{i} = Q_{0.75}(V_{i})\) — 控制变量 / 多目标分析
-
A2-332 \(y_{i} = max(V_{i})\) — 控制变量 / 多目标分析
-
A2-333 \(y_{i} = v(r_{i},c_{i})\) — 控制变量 / 多目标分析
-
A2-334 \(E_{k}\) — 控制变量 / 多目标分析
-
A2-335 \(\mathcal{N}_{w}(i)\) — 控制变量 / 多目标分析
-
A2-336 \(10^{- 12}\) — 控制变量 / 多目标分析
-
A2-337 \(y_{t}\) — 控制变量 / 多目标分析
-
A2-338 \(d_{t} \in \{ - 1, + 1\}\) — 控制变量 / 多目标分析
-
A2-339 \(D_{it}\) — 控制变量 / 多目标分析
-
A2-340 \(X_{full} = \lbrack X,C\rbrack\) — 控制变量 / 多目标分析
-
A2-341 \(r = \frac{\Sigma_{i}{(x}_{ik}{- x\bar{}}_{k}{)(y}_{i} - ȳ)}{\sqrt{\Sigma_{i}{(x}_{ik}{- x\bar{}}_{k})^{2}\Sigma_{i}{(y}_{i}{- ȳ)}^{2}}}\) — 控制变量 / 多目标分析
-
A2-342 \(\tau = (N_{c} - N_{d})/\binom{n}{2}\) — 控制变量 / 多目标分析
-
A2-343 \(S^{X}\) — 控制变量 / 多目标分析
-
A2-344 \(D_{i1},\ldots,D_{iT}\) — 控制变量 / 多目标分析
-
A2-345 \(T_{i}(固定参考目标水平)\) — 控制变量 / 多目标分析
-
A2-346 \(I_{i}(目标不均衡度)\) — 控制变量 / 多目标分析
-
A2-347 \(l_{j}{/u}_{j}(固定参考界限)\) — 控制变量 / 多目标分析
-
A2-348 \(\Delta R_{X}^{2} < 0\) — 控制变量 / 多目标分析
-
A2-349 \(R_{full}^{2} - R_{control}^{2}\) — 控制变量 / 多目标分析
-
A2-350 \(\mathbf{w}_{a},\mathbf{w}_{b}\) — 控制变量 / 多目标分析
-
A2-351 \(B_{1},\ldots,B_{K}\) — 控制变量 / 多目标分析
-
A2-352 \(B_{k}\) — 控制变量 / 多目标分析
-
A2-353 \(s_{NE}^{*} = arg\max_{s}\Delta R_{X}^{2}(s)\) — 控制变量 / 多目标分析
-
A2-354 \(s_{S}^{*} = arg\max_{s}S_{global}(s)\) — 控制变量 / 多目标分析
-
A2-355 \(s_{T}^{*} = arg\max_{s}T_{global}(s)\) — 控制变量 / 多目标分析
-
A2-356 \(s_{P}(前沿占比峰值)\) — 控制变量 / 多目标分析
-
A2-357 \(跨方法峰值描述,不是独立一致性\) — 控制变量 / 多目标分析
-
A2-358 \(a\mathcal{\in A}\) — 控制变量 / 多目标分析
-
A2-359 \(\mathcal{G}_{a}\) — 控制变量 / 多目标分析
-
A2-360 \(T_{a}\) — 控制变量 / 多目标分析
-
A2-361 \(W_{b}\) — 控制变量 / 多目标分析
-
A2-362 \(D_{i}(描述性协调度)\) — 控制变量 / 多目标分析
-
A2-363 \(X_{1},\ldots,X_{p}\) — 贝叶斯网络分析
-
A2-364 \(Pa(X_{i})\) — 贝叶斯网络分析
-
A2-365 \(0,1,\ldots,r_{i} - 1\) — 贝叶斯网络分析
-
A2-366 \(u \leq B\) — 贝叶斯网络分析
-
A2-367 \(u > B\) — 贝叶斯网络分析
-
A2-368 \(Q_{B}\) — 贝叶斯网络分析
-
A2-369 \(B - 1\) — 贝叶斯网络分析
-
A2-370 \(X_{i}\) — 贝叶斯网络分析
-
A2-371 \(r_{i}\) — 贝叶斯网络分析
-
A2-372 \(q_{i} = \prod_{X_{j} \in Pa_{i}}^{}r_{j}\) — 贝叶斯网络分析
-
A2-373 \(N_{ijk}\) — 贝叶斯网络分析
-
A2-374 \(N_{ij} = \sum_{k}^{}N_{ijk}\) — 贝叶斯网络分析
-
A2-375 \(- 2\mathcal{l} + k\ln n\) — 贝叶斯网络分析
-
A2-376 \(X_{a} \rightarrow X_{b}\) — 贝叶斯网络分析
-
A2-377 \(X_{b} \rightarrow X_{a}\) — 贝叶斯网络分析
-
A2-378 \(\Delta BIC\) — 贝叶斯网络分析
-
A2-379 \(BIC(G^{(t + 1)}) - BIC(G^{(t)}) > \delta_{\min}\) — 贝叶斯网络分析
-
A2-380 \(R_{u}ser(固定重启预算)\) — 贝叶斯网络分析
-
A2-381 \(L_{e}ligible(两端节点有效尺度数)\) — 贝叶斯网络分析
-
A2-382 \(n_{\min}\) — 贝叶斯网络分析
-
A2-383 \(c = p/n_{\min}\) — 贝叶斯网络分析
-
A2-384 \(n_{\min} \geq 500\) — 贝叶斯网络分析
-
A2-385 \(p \leq 16\) — 贝叶斯网络分析
-
A2-386 \(p - 1\) — 贝叶斯网络分析
-
A2-387 \(n_{\min} < 50\) — 贝叶斯网络分析
-
A2-388 \(parent \rightarrow child\) — 贝叶斯网络分析
-
A2-389 \(X \rightarrow Y\) — 贝叶斯网络分析
-
A2-390 \(pa_{j}\) — 贝叶斯网络分析
-
A2-391 \(e = (X \rightarrow Y)\) — 贝叶斯网络分析
-
A2-392 \(L_{e}(方向边出现尺度数)\) — 贝叶斯网络分析
-
A2-393 \(Y \rightarrow X\) — 贝叶斯网络分析
-
A2-394 \(E = e\) — 贝叶斯网络分析
-
A2-395 \(\mathbf{H} = V\backslash(\{ Q\} \cup E)\) — 贝叶斯网络分析
-
A2-396 \(M = (P + Q)/2\) — 贝叶斯网络分析
-
A2-397 \(\Delta_{\max}\) — 贝叶斯网络分析
-
A2-398 \(\Delta P\) — 贝叶斯网络分析
附录 B 参数、方法与输出表目录
本附录按应用内文档顺序收录全部 92 张 Markdown 表。表格承担参数语义、方法清单、数据角色、输出文件和操作链的完整查询功能。正文中的关键表为重组后的摘要,本附录保留文档级细节。
B.1 平台总览与模块导航
| 主功能 | 入口文件 | 关键类 |
|---|---|---|
| 地图工作台 | tab_map.py | Map, TileRequestInterceptor |
| 数据管理 | tab_dm.py | DataManagerTab |
| 数据库 | dm/tab_database.py | DatabaseTab, FloatingWindow |
| 类型检索 | dm/tab_databrowser.py | DataBrowserTab, InventoryWorker, PreviewPayloadWorker |
| 数据生产 | tab_modeltrain.py | ModelTrainTab |
| 尺度分析 | spatial_structure_analysis/statistical_unit_scale.py | StatisticalUnitScaleWidget, ScaleAnalysisWorker |
| 控制/多目标 | spatial_structure_analysis/control_target_unit_scale.py | ControlTargetUnitScaleWidget |
| 贝叶斯网络 | spatial_structure_analysis/bayesian_network_analysis.py | BayesianNetworkAnalysisWidget, BayesianNetworkAnalysisWorker |
表 B-1 平台总览与模块导航:4. 代码结构与文档对应关系
B.2 AI API 配置与智能接入
| 参数 | 含义 | 典型用途 |
|---|---|---|
| API Key | 身份认证密钥 | 调用模型服务 |
| Base URL | 提供商接口根地址 | 对接代理层、私有网关或平台 API |
| 模型名称 | 具体模型 ID | 控制推理模型选择 |
| Endpoint ID | 平台接入点标识 | 适用于火山方舟等需要 endpoint 的平台 |
| 默认平台 | 系统默认模型源 | 供后续模块自动读取 |
| 对话接口 | Chat Completions / Responses | 按实际平台与模型能力选择 |
| 模型与能力 | 模型菜单、刷新、工具/图像能力 | Agent 须支持工具调用;多模态还需图像能力 |
| Harness 运行版本 | 独立版本、源码指纹、可运行目录 | 本地导入或官方升级按钮;失败保留当前版本,可回退 |
| 运行设置 | 请求/压缩/总时间上限可选,0 不限 | 默认按完成、停止或明确阻塞结束;单次超时另设 |
表 B-2 AI API 配置与智能接入:3. 参数语义
B.3 Whitebox Tools 集成
| 参数类型 | 面板控件与使用方法 |
|---|---|
| ExistingFile / NewFile | 单文件路径 + Browse 按钮。ExistingFile 选择现有文件;NewFile 选择输出保存路径。 |
| FileList | 多文件输入,选择后会以 ; 分隔显示在输入框。 |
| Boolean | 复选框。选中为 true,未选中为 false。 |
| Integer / Float | 数字输入框,支持范围与小数位控制。 |
| OptionList | 下拉框列出枚举值(如 mean/sum/max/…、cells/sca/ca 等)。 |
| 字符串(String) | 纯文本输入。 |
| 矢量/栅格/点云特定类型 | 仍以浏览文件的形式填写;类型仅用于提示与校验。 |
表 B-3 Whitebox Tools 集成:4. 参数面板与类型说明
B.4 数据加载器与图层回显
| 类型 | 扩展名 | 处理规则 |
|---|---|---|
| GeoJSON | .geojson/.json | 直接读取字符串并注入地图。 |
| Shapefile/KML/GML | .shp/.kml/.gml | 以 GeoPandas 读取;若无坐标系则设为 EPSG:4326;若坐标系非 4326 则自动重投影后转为 GeoJSON 注入。 |
| CSV 点 | .csv | 必须包含 lon/lat;空值行剔除;长度>100000 时采样至 50000 条以防卡顿;转为 GeoJSON 注入。 |
| Raster | .tif/.tiff/.img | 以 QUrl 绝对路径传递至地图端,构建 GeoRasterLayer;自动弹出栅格渲染卡片并关联该图层。 |
表 B-4 数据加载器与图层回显:2. 支持与规则
| 模块 | 名称 | 作用 |
|---|---|---|
| 面板 → 地图 | loadGeoLayer(geojson_str, layerId) | 加载矢量到 Leaflet,并登记到 layerRegistry。 |
| loadRasterLayer(url, {layerId,label}) | 加载 GeoTIFF(单波段灰度/伪彩起步),回调成功/失败。 | |
| applyRasterStyle({layerId,renderType,opacity,colorRamp}) | 对单波段栅格应用样式。 | |
| removeLayerById(layerId) | 从地图与注册表移除图层。 | |
| 面板内部 | update_raster_controls(layer_id) | 将渲染控件指向指定栅格图层并重置 UI。 |
| handle_layer_click(layer_id) | 切换当前图层;栅格则联动渲染卡片。 | |
| _show_layer_context_menu(layer_id, pos) | 右键菜单:缩放/设为当前/移除。 | |
| clear_layers() | 清空地图图层与面板列表。 |
表 B-5 数据加载器与图层回显:9. 控件与函数速查
B.5 分割采样与空间区划
| 类别 | 算法 | 典型用途/特点 |
|---|---|---|
| scikit-image | SLIC / SLIC0、Felzenszwalb、Quickshift、Watershed | 语义超像素、图割、基于密度/梯度的方法 |
| OpenCV | SLIC / SLICO(CPU Fast) | 工程级快速超像素 |
| 聚类/漂移类 | MeanShift(sp/sr/ms_k) | 复杂纹理场景的聚类分割 |
表 B-6 分割采样与空间区划:5.1 支持算法(示例)
| 步骤 | 操作 | 说明 |
|---|---|---|
| 1 | A 页选择影像 + 预览 | 先用 B5/B4/B3 或 B7/B6/B4 做自然/城市预览 |
| 2 | B 页构建特征 | 指数(NDVI/NDBI/MNDWI)+ Z-Score + PCA(k=3) |
| 3 | C 页 SLICO | region_size=24±8, ruler/compactness=15±5 |
| 4 | D 页区划 | 选择统计项与区划方法,字段自动命名 |
| 5 | E 页右键赋类 | 新增类别与颜色,随用随存,最后导出 |
表 B-7 分割采样与空间区划:附录 C:快速实践清单(Landsat 15 m 城市场景)
B.6 数据管理与质量控制
| 字段 | 含义 |
|---|---|
| id | 记录主键 |
| name | 数据名称 |
| type | 数据类型 |
| format | 格式 |
| path | 文件路径 |
| keywords | 关键词 |
| crs | 坐标参考系统 |
| geometry_type | 几何类型 |
| layer_extent | 空间范围 |
| no_data_value | 无效值 |
| band_count | 波段数 |
| created_time | 创建时间 |
| last_modified | 修改时间 |
| file_size | 文件大小 |
| source | 来源 |
| description | 描述 |
| citation | 引用 |
| semantic_category | 语义分类 |
表 B-8 数据管理与质量控制:3. 数据库页字段体系
B.7 按数据类型检索
| 页面 | 主要目标 |
|---|---|
| 数据库页 | 管理正式索引、元数据与可编辑记录 |
| 按数据类型检索页 | 对目录内容做快速发现、分类和预览 |
表 B-9 按数据类型检索:7. 与数据库页的区别
B.8 Landsat -> 土地覆盖(LC)
| 名称 | 含义 | 取值/格式 | 默认 | 说明 |
|---|---|---|---|---|
| 工作空间 (workspace) | 当前工程目录 | 文件夹路径 | 空 | 后续所有结果默认写入此处 |
表 B-10 Landsat -> 土地覆盖(LC):输入/输出与参数
| 名称 | 含义 | 格式 | 默认 |
|---|---|---|---|
| Landsat 压缩包/文件夹列表 (landsat_sources) | 每个元素是一景影像的载体 | 绝对路径 | 空 |
表 B-11 Landsat -> 土地覆盖(LC):输入/输出与参数
| 名称 | 含义 | 格式 | 默认 |
|---|---|---|---|
| 分析边界 (boundary_path) | 裁切/限定范围 | .geojson | 空(不裁切) |
表 B-12 Landsat -> 土地覆盖(LC):输入/输出与参数
| 名称 | 含义 | 取值/示例 | 默认 | 说明 |
|---|---|---|---|---|
| 波段列表 (bands) | 需要合成到同一影像的波段 | B2,B3,B4,B5,B6,B7,QA_PIXEL | B2,B3,B4,B5,B6,B7,QA_PIXEL | 逗号分隔;与 Landsat 8/9 标准命名一致 |
| 输出后缀 (suffix) | 写出的文件名后缀 | _7bands/_LC8sel | _7bands | 用于区分不同栈叠方案 |
| 裁切边界 (clip_geojson) | 是否按边界裁切 | 见③ | 空(不裁切) | 传入则启用裁切 |
| 输出 | 多波段 GeoTIFF | 写入工作空间 | — | 文件名通常为“输入名+后缀” |
表 B-13 Landsat -> 土地覆盖(LC):输入/输出与参数
| 名称 | 含义 | 取值/格式 | 默认 |
|---|---|---|---|
| DEM 文件列表 (dem_files) | 待合并 DEM 影像 | 多个 .tif | 空 |
| 裁切边界 (boundary_path) | 是否按边界裁切 | 见③ | 空(不裁切) |
| 输出 | 合并(及裁切)后的 DEM | merged_dem.tif(写入工作空间) | — |
表 B-14 Landsat -> 土地覆盖(LC):输入/输出与参数
| 分区 | 参数键 | UI 标签 | 默认值 | 说明 |
|---|---|---|---|---|
| ① | workspace | 工作空间 | — | 结果写入目录 |
| ② | landsat_sources | Landsat 数据源列表 | — | 压缩包/文件夹 |
| ③ | boundary_path | 边界(GeoJSON) | — | 可选裁切 |
| ④ | bands | 波段列表 | B2,B3,B4,B5,B6,B7,QA_PIXEL | 逗号分隔 |
| ④ | suffix | 输出后缀 | _7bands | 写出文件名标记 |
| ⑤ | dem_files | DEM 文件列表 | — | .tif 多选 |
| ⑤ 输出 | — | merged_dem.tif | — | DEM 合并裁切结果 |
表 B-15 Landsat -> 土地覆盖(LC):参数与默认值一览(便于快速查阅)
| 字段 / 控件 | 类型 | 必选 | 说明 / 取值规则 | 操作要点 / 按钮 | 示例值(与界面一致风格) |
|---|---|---|---|---|---|
| 模块工作空间 | 文件夹路径 | 是 | 作为当前工程的集中读写目录;后续 .npz/.tif 等统一写入此处的子路径 | 右侧 “浏览” 选择文件夹 | D:/WS_Landsat2LC_Val/训练样本25.9.12/Shanghai_USDA_LC_2020 |
| 基准栈影像 | GeoTIFF(单文件) | 是 | 作为几何/投影与波段映射的参照影像;建议为已裁剪/统一分辨率的 7 波段(B2–B7 + QA_PIXEL 可存在但本步不使用) | 右侧 “浏览” 选择单个 .tif | …/LC08_L2SP_…_B2B3B4B5B6B7QA_PIXEL_7bands_clipped.tif |
| 参考栈影像(可多选) | GeoTIFF 列表 | 否 | 0–N 个与基准同域、同分辨率、同投影的多时相影像;用于在后续步骤对每一景分别计算指数 | 下拉框显示当前选择;“添加” 逐个加入,“浏览” 替换当前项,“移除” 删除当前项 | …/LC08_L2SP_…_20200816_20200920_…_7bands_clipped.tif 等 |
| DEM 文件 | GeoTIFF 列表 | 否 | 记录用于后续地形指数或其他模块的 DEM;可添加多幅(拼接/裁切在 DEM 面板进行),本步仅登记路径 | 右侧 “选择 DEM” 按钮添加;下拉框列出已选 DEM | …/merged_dem.tif(或多条 DEM 路径) |
| 输出 | — | — | 此步骤不产生任何输出文件(只生成“待处理清单”,实际写入发生在 ② 计算光谱指数) | — | — |
表 B-16 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 字段 / 控件 | 类型 | 必选 | 说明 / 取值规则 | 操作要点 / 按钮 | 输出 / 副作用 | 示例值(界面风格) |
|---|---|---|---|---|---|---|
| 已选光谱指数 | 列表 | 是 | 显示当前将要计算的指数集合(顺序不影响结果) | 选中后可配合“移除 >> / 全部移除 >>” | 决定 .npz 中写入的字段 | MSAVI2, ARVI, GNDVI, NDWI, MNDWI, AWEI_SH, AWEI_NSH, WRI, NDPI … |
| 指数候选 | 下拉框 | 否 | 从候选库选择单个指数名称 | 右侧 “<< 添加” 将所选加入列表;“<< 全部添加” 一键加入全部 | — | 右上默认 NDVI |
| 移除 >> / 全部移除 >> | 按钮 | 否 | 从“已选光谱指数”中删除选中项 / 清空全部 | 先在列表中选中后点击 | — | — |
| 指数说明 | 文本(只读) | 否 | 提示 L8/9 波段映射及常见指数的公式与典型阈值 | 随面板滚动查看 | — | L8/9: BLUE=B2, GREEN=B3, RED=B4, NIR=B5, SWIR1=B6, SWIR2=B7;NDVI, EVI… |
| 保存到 | 文本框(路径) | 是 | 选择输出文件名(.npz)。如①中含多景输入,程序会基于此自动派生各影像的输出名(如 _base_日期.npz / _ref_日期.npz) | 右侧 “选择保存路径” 打开文件对话框 | 产生 1∼N 个 .npz(按①的数据清单逐一写出;键名为所选指数的小写) | D:/WS_…/Shanghai_USDA_LC_2020/spectral_indices.npz |
| 开始计算光谱指数 | 按钮 | 是 | 触发②的批量计算;进度/日志在面板底部输出 | 计算过程中按钮置灰,完成后恢复 | 按所选指数写入 .npz,并记录到任务列表供后续步骤使用 | — |
表 B-17 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 字段 / 控件 | 类型 | 必选 | 说明 / 取值规则 | 操作要点 / 按钮 | 输出 / 副作用 | 示例值 |
|---|---|---|---|---|---|---|
| 已选地形指数 | 列表 | 是 | 将要计算的指标集合 | 结合“移除 / 全部移除”维护列表 | 决定 .npz 字段 | slope, aspect, TPI, TRI, curvature, roughness, VRM, TWI, HAND |
| 指数候选 | 下拉框 | 否 | 从候选库选择单项 | << 添加 / << 全部添加 | — | slope |
| 移除 / 全部移除 | 按钮 | 否 | 从“已选地形指数”删除选中/全部 | 需先选中列表项 | — | — |
| 地形指数说明 | 文本(只读) | 否 | 简述每个指标的物理含义与场景 | 面板内滚动查看 | — | — |
| 参考坐标/投影 | 路径 | 否 | 参考栅格 .tif或矢量 .shp/.geojson。用于将 DEM 对齐到光谱栈的网格/CRS;未提供时默认采用基准栅格 | “选择参考坐标/投影” | 直接影响重投影与输出的 transform/CRS | …/LC08_…_7bands_clipped.tif |
| 窗口大小 | 整数 | 是 | 影响 TPI/TRI/roughness/VRM/曲率,强制奇数(自动纠正) | 数字框 | 窗口越大越平滑、越强调低频地形 | 5 |
| 保存到 | 路径 | 是 | 输出 .npz 文件路径 | “选择保存路径” | 写出所选指标与 transform | …/terrain_indices.npz |
| 开始计算地形指数 | 按钮 | 是 | 执行批处理并打印进度 | 完成后按钮恢复 | 生成 .npz | — |
表 B-18 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 字段 / 控件 | 类型 | 必选 | 说明 / 取值规则 | 操作要点 / 按钮 | 输出 / 副作用 | 默认/示例 |
|---|---|---|---|---|---|---|
| 选择光谱指数用于纹理计算 | 列表 | 是 | 参与纹理提取的光谱指数(来自②的 .npz 字段名;大小写不敏感) | 右侧“<< 添加 / << 全部添加”“移除 >> / 全部移除 >>”维护 | 决定输出里出现的前缀,如 ndvi_entropy | NDVI, MNDWI, NDBI, IBI, NDMI, BSI, NBR… |
| 输入光谱 .npz(可多选) | 路径或列表 | 是 | ②步骤生成的一个或多个 .npz;同名字段以先出现者优先 | “浏览添加 / 移除 / 全部移除” | 批处理并整合写出到同一结果文件 | …/spectral_indices_base_20200816.npz |
| 已选纹理指标 | 列表(多选) | 是 | 将要计算的纹理指标集合;顺序不影响结果 | 先选中条目,再用“移除 >> / 全部移除 >>” | 决定 .npz 中写入的纹理字段 | entropy, contrast, homogeneity, correlation, glcm_var, glrlm_sre, glrlm_lre, glrlm_gln, glrlm_rln |
| 纹理指标候选(下拉) | 下拉框 | 否 | 从候选库选单个指标 | **“<< 添加 / << 全部添加”**加入到左侧列表 | — | 见下一行 |
| 候选全集(供选择) | — | — | GLCM:entropy, contrast, dissimilarity, homogeneity, ASM, energy, correlation, glcm_mean, glcm_var, glcm_std;GLRLM:glrlm_sre, glrlm_lre, glrlm_gln, glrlm_rln, glrlm_rp;LBP:lbp_mean, lbp_std, lbp_entropy, lbp_uniform_ratio | — | — | — |
| 纹理指标说明 | 文本(只读) | 否 | 展示 L8/9 波段映射、各指标含义与常见用途;仅说明,不在此处改参数 | 面板中滚动查看 | — | — |
| 保存到 | 路径 | 是 | 输出 .npz 文件名(单尺度写一个文件;多尺度会自动派生后缀) | “选择保存路径” | 写出纹理结果与 transform/CRS | …/glcm.npz |
| 窗口大小(逗号分隔) | 文本(整数列表) | 是 | 滑窗尺寸集合,奇数,如 3,5,7;多尺度将循环计算并分别写出 | — | 多尺度时会生成如 …_w5.npz / …_w7.npz 或键名附 _w5/_w7 | 5,7 |
| 灰度等级 Levels | 整数 | 否 | 灰度量化级数(GLCM/GLRLM 用),常用 16 或 32 | — | 级数越高越细致但更敏感 | 16 |
| 按角度分别输出(per_angle) | 复选 | 否 | 勾选后每个方向分别输出:键名追加 _a0/_a45/_a90/_a135;不勾选则对角度取均值 | — | 文件体量↑;可保留方向性 | 关闭 |
| 启用 GLRLM 指标 | 复选 | 否 | 同时计算 GLRLM 的五项指标 | — | 结果键名前缀为 glrlm_ | 关闭 |
| 启用 LBP 指标 | 复选 | 否 | 同时计算 LBP 统计量 | — | 结果键名前缀为 lbp_ | 关闭 |
| LBP 参数 | 参数组 | 否 | P(邻域点数)、R(半径)、method(uniform/ror…) | 下拉选择 method | 影响所有 lbp_* 的结果 | P=8, R=1, method=uniform |
| 开始计算(GLCM/GLRLM/LBP) | 按钮 | 是 | 触发本面板计算;过程内显示进度并写日志 | — | 生成/更新上面的“保存到”目标 .npz | — |
表 B-19 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 光谱指数 | 推荐纹理(w=5,levels=16;可再算 w=7) | 原理与解译(为什么) | 优先级 |
|---|---|---|---|
| NDVI | ndvi_entropy, ndvi_contrast | NDVI 高低交错(林缘、混合地物)→ 熵/对比度上升,纯草地/林分内部 → 熵/对比度下降;帮助“植被 vs 非植被”边界稳定 | ★★★★ |
| MNDWI | mndwi_homogeneity, mndwi_energy | 开阔水体纹理单一、平滑 → 同质度/能量高;可抑制“暗屋面/阴影”假水体 | ★★★★ |
| NDBI | ndbi_entropy, ndbi_glcm_var | 建成区材质/几何复杂、亮度起伏大 → 熵/方差高;与 MNDWI/NDVI 联合可减少混淆 | ★★★★ |
| NDMI | ndmi_homogeneity | 湿地/蒸腾旺盛区通常更“均匀”,同质度较高;干旱/扰动则下降 | ★★★ |
| NBR | nbr_contrast, nbr_entropy | 烧毁/扰动区呈高对比、高无序;与 NDMI 同看可区分季节落叶 | ★★★ |
表 B-20 Landsat -> 土地覆盖(LC):二、核心组合(任何场景都适用)
| 字段 / 控件 | 类型 | 必选 | 说明 / 取值规则 | 操作要点 / 按钮 | 输出 / 副作用 | 默认/示例 |
|---|---|---|---|---|---|---|
| .npz 列表 | 列表 | 是 | 选择参与差分的 .npz(≥2);可混合光谱、纹理、地形结果,只要键名一致即可 | 右侧“浏览 .npz / 上移 / 下移 / 移除所选 / 全部移除” | 决定参与两两组合的文件集 | …/spectral_base.npz, …/spectral_20200920.npz |
| 指数(公共交集) | 下拉 + 列表 | 是 | 仅可选择所有 .npz 都具有的字段(键名不区分大小写) | “刷新指数列表”拉取交集;“<< 添加 / << 全部添加 / 移除 >> / 全部移除 >>”维护 | 这些键将分别计算差分并以 key_diff 写出 | ndvi, mndwi, ndbi, ndmi, nbr … |
| 保存目录 | 目录 | 是 | 两两差分结果的输出文件夹 | “选择目录” | 每个组合生成一个 .npz | …/diffs/ |
| 文件名前缀(Prefix) | 文本 | 否 | 输出文件名前缀 | 直接编辑 | 影响输出文件名,不影响字段名 | DIFF |
| 开始两两差分计算 | 按钮 | 是 | 触发批处理 | — | 写出若干 *.npz;每个包含若干 *_diff 数组与 transform | — |
表 B-21 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 字段 | 类型/控件 | 必填 | 说明与默认 | 取值与注意 |
|---|---|---|---|---|
| 浏览 .npz / 上移 / 下移 / 移除所选 / 全部移除 | 列表 + 工具按钮 | 是 | 维护按时间顺序的 .npz 列表;支持拖拽排序 | 至少选择 2 个文件,否则拒绝启动。 |
| 指数(公共交集) | 下拉框 | 否 | 自动扫描所有 .npz 的共同键名并按字母序列出 | 点“刷新指数列表”重新扫描;若无公共键,将提示检查输入。 |
| 已选指数列表 / << 添加 / << 全部添加 / 移除 >> | 列表 + 按钮 | 否 | 把公共交集中的指数加入待统计集合 | 不选择指数将直接返回,不计算。 |
| 保存目录 | 目录选择 | 是 | 输出目录 | 若为空使用工作空间路径。 |
| 文件名前缀(Prefix) | 文本 | 否 | 默认 TSA,输出名为 TSA__id1-to-idN.npz;失败回退为 tsa | id 由输入文件名规范化而成,便于溯源。 |
| 开始时序统计计算 | 按钮 | 是 | 触发后台线程执行 | 进度采用节流日志输出;完成或异常均会提示。 |
| 严格形状(strict_shape) | 代码参数 | 否 | 默认 False:若形状不一致则跳过并写日志;必要时可改 True 强制一致 | 读取阶段支持 mmap,更省内存。 |
| 输出内容 | .npz | — | {idx}_var / {idx}_range / {idx}_max_t;可能携带 transform | 上述键名按所选指数逐一生成。 |
表 B-22 Landsat -> 土地覆盖(LC):输入 / 输出与参数
| 区域/控件 | 类型 | 必填 | 说明 / 取值规则 | 操作要点 | 输出/副作用 |
|---|---|---|---|---|---|
| 指数组栈(.npz) | 文件 | 是 | 选择一个来自“② 计算光谱指数/④ 纹理/③ 地形”等步骤的 .npz | 选择 .npz | 作为本次统计的输入容器 |
| 可选指数列表 | 列表 | 是 | 从该 .npz 的字段中挑选要做统计的指数(如 ndvi, mndwi, ndbi…) | 右侧 << 添加 / << 全部添加 / 移除 >> / 全部移除 >> | 决定输出键此前缀 |
| 统计指标列表 | 列表 | 否 | 选择要计算的统计量(默认即上述 16+ 项;支持多选) | 右侧与上同 | 形成 {index}_{metric}_w{win} |
| 窗口大小 | 文本 | 是 | 逗号分隔的奇数:如 3,5,7;内部自动把偶数纠正为奇数 | — | 多尺度会循环计算 |
| 保存目录 | 目录 | 是 | 统一输出目录 | 选择目录 | 在目录下生成一个统一 .npz |
| 文件名前缀(Prefix) | 文本 | 否 | 统一文件名的前缀(可空) | 直接输入 | 例如 winstats_spatial_stats_w5-7.npz |
| 开始计算空间窗口统计 | 按钮 | 是 | 触发后台计算并打印进度 | — | 逐项增量写入;首写附 transform |
表 B-23 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 区域/控件 | 类型 | 必填 | 说明 / 取值规则 | 操作要点 | 输出 / 副作用 |
|---|---|---|---|---|---|
| 待合并文件列表 | 列表(.npz) | 是 | 选择来自步骤②–⑦的 1–N 个 .npz(如:spectral_indices.npz、glcm.npz、terrain_indices.npz、diff__*.npz、tsa__*.npz、winstats__*.npz 等) | 右侧**“浏览文件 / 移除 / 全部移除”**维护 | 决定被合并的键集合 |
| 参考坐标/投影 | 路径 | 否 | 推荐选择基准 7 波段栅格(与训练/预测用的主影像一致);也可选 .shp/.geojson(仅取 CRS,此时需另有基准栅格以确定网格) | **“选择参考坐标/投影”**按钮,或留空(则采用基准栅格) | 影响重采样对齐与输出的 transform/CRS |
| 输出文件名 | 文本(文件名) | 是 | 合并后的 .npz 名称(无需扩展名) | 与**“选择保存路径”**联用 | 在选定目录写出 all_indices_merged.npz 等 |
| 执行合并 | 按钮 | 是 | 触发后台线程执行:读取→对齐→追加写 | 过程内会显示进度日志,完成后恢复 | 产出 1 个大一统 .npz(含 transform/CRS) |
表 B-24 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 区域/控件 | 类型 | 必填 | 说明 / 取值规则 | 输出 / 副作用 |
|---|---|---|---|---|
| .npz 数据 | 列表 | 是 | 从下拉中选择并“添加/全部添加”需要导出的指数键(会自动排除 transform)。若未选键会提示。 | 将列表顺序对应到 TIF 的波段顺序。 |
| transform(可选) | 文本 | 否 | 6 或 9 个数,逗号/空格分隔:[a b c d e f] 或 3×3 线性化的前 6 个。若 .npz 自带 transform 则优先用其。 | 设置 GeoTransform(若留空且 .npz 也无,则输出无地理坐标)。 |
| 保存到 | 路径 | 是 | 输出 TIF 完整路径;为空时默认与 .npz 同名 .tif。 | 生成 GeoTIFF;必要时启用 BigTIFF。 |
| compress | 选项 | 否 | NONE / DEFLATE / LZW / ZSTD(默认 DEFLATE)。 | 控制压缩算法。 |
| predictor | 数值(1–3) | 否 | 预测编码器(浮点常用 3,整型常用 2;默认自动随 dtype)。 | 降低压缩熵,提升压缩率。 |
| zlevel | 开关+数值 | 否 | 对 DEFLATE/ZSTD 生效;1–9(DEFLATE),1–22(ZSTD)。 | 提高压缩比但略降速度。 |
| tiled / blockx / blocky | 选项+数值 | 否 | 开瓦片写入与瓦片大小(典型 256–512)。 | 更利于随机访问与金字塔构建。 |
| 缩放为 int16×K | 开关+数值 | 否 | 将浮点指数按 K 缩放写成 int16(默认 K=10000),并设置 nodata=-32768。 | 显著减小体积与 IO;TIF 写入 SCALE=1/K 便于后续反解。 |
| BIGTIFF | 复选 | 否 | 大于 4GB 时建议开启。 | 避免 4GB 限制。 |
| 开始转换(按钮) | 按钮 | 是 | 执行写盘;进度日志会显示“写入进度 i/N / 完成”。 | 生成目标 GeoTIFF;每个波段写入索引名作为 band 描述。 |
表 B-25 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 分组 | 字段 | 类型 / 取值 | 说明 |
|---|---|---|---|
| ① 数据与特征选择 | 模块工作空间 | 只读 | 当前模块的工作目录(用于默认保存路径)。 |
| 输入样本 GeoJSON | 路径 | 训练样本面要素文件(含标签列、类别列)。 | |
| 标签列 label_col | 文本 | 记录样本唯一标识,默认 id。 | |
| 类别列 class_col | 文本 | 记录地类标签,默认 name。 | |
| 选择特征 npz | 路径 | 含指数/纹理/统计等二维数组 + transform(必须)与 crs_epsg(可选)。 | |
| 可选字段 ↔ 已选字段 | 列表 | 若在②启用“稳定性过滤”,这里右侧列表即为 stability_cols。 |
表 B-26 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 分组 | 字段 | 类型 / 取值 | 默认 | 说明 | ||
|---|---|---|---|---|---|---|
| ② 过滤参数 | 启用光谱一致性 | 勾选 | ✓ | 启用后解析右侧阈值串并生效。 | ||
| 光谱一致性阈值 | 文本 | ndvi:0.05,mndwi:0.05,ndbi:0.05 | 逗号分隔 base:τ,如 ndvi:0.06。键名与 npz 字段基名对齐。 | |||
| 模式 | 下拉 | any | all/any/mean 三种多字段归并策略。 | |||
| 启用几何过滤 | 勾选 | 勾选后启用下两项。 | ||||
| 最小面积 A_min | 整数 | 30 | 以自动推断的 UTM/等积坐标计算。 | |||
| 紧凑度阈值 C_min | 浮点 | 0.30 | 使用 \(\frac{4\pi A}{L^{2}}\) 指标。 | |||
| 最小像元数 n_min | 整数 | 1 | 光谱与稳定性统计时的最小有效像元数。 | |||
| 向内腐蚀 e(像元) | 浮点 | 0.0 | 可设 0–2,弱化边界混合像元影响。 | |||
| 启用稳定性过滤 | 勾选 | 启用后对 ① 右侧“已选字段”求分区均值并检验阈值。 | ||||
| 稳定性阈值 θ | 浮点 | 0.20 | ( | z_j | ) 为通过条件。 | |
| 启用类别样本数 | 勾选 | 勾选后启用下项。 | ||||
| 每类别最小样本数 | 整数 | 25 | 小于阈值的类别整体移除。 |
表 B-27 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 分组 | 字段 | 类型 / 取值 | 说明 |
|---|---|---|---|
| ③ 输出与执行 | 输出文件路径 | 路径 | 过滤后的样本 GeoJSON。 |
| 保存过滤统计图(PNG) | 勾选 | 保存“前后类分布”对照图。 | |
| 开始样本过滤 | 按钮 | 触发执行;运行日志实时写入“④ 状态信息”。 |
表 B-28 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 字段 | 类型 | 说明 | 备注/默认 |
|---|---|---|---|
| 输入样本 GeoJSON | 路径 | 过滤后的样本面/类字段在②设置 | 支持自动重投影到 npz 的 crs_epsg 或推断 UTM |
| 特征 npz 文件 | 路径 | 包含 transform、可选 crs_epsg 与多个二维指标数组 | 读取后自动填充“npz 指数字段下拉框” |
| 影像文件 (GeoTIFF) | 路径 | 仅当启用“一致性过滤(基于影像波段)”时使用 | 读取后自动填充 Band1…BandN |
表 B-29 Landsat -> 土地覆盖(LC):输入/输出与参数(面板字段一览)
| 字段 | 类型 | 说明 | 默认 |
|---|---|---|---|
| 类别列名 | 字符串 | GeoJSON 中表示类别的字段 | name |
| 生成模式 | 单选 | polygon / pixel / both | pixel(UI 默认) |
| 启用标准化 | 复选 | StandardScaler | ✔ |
表 B-30 Landsat -> 土地覆盖(LC):输入/输出与参数
| 字段 | 类型 | 说明 | 默认 |
|---|---|---|---|
| 多边形负向缓冲(m) | 浮点 | polygon 内缩距离 | 15(UI 默认) |
表 B-31 Landsat -> 土地覆盖(LC):参数
| 选项 | 含义 | 备注 |
|---|---|---|
| mean / median / p25 / p75 / std / iqr / count | 见上 | 统计列名为 <指标>_<统计量> |
表 B-32 Landsat -> 土地覆盖(LC):参数(勾选将被计算)
| 字段 | 类型 | 说明 | 默认 |
|---|---|---|---|
| 每 polygon 像元上限 | 整数 | max_n | 500 |
| 每 polygon 抽样比例 | 浮点 | 0–1 | 1.0 |
| 每类全局上限 | 整数 | 限制每个类别的像元数 | 0=不限 |
| 随机种子 | 整数 | 重现性 | 42 |
| 块大小(像元) | 整数 | 空间块尺寸 \(b\) | 64 |
| K 折数量 | 整数 | k | 5 |
表 B-33 Landsat -> 土地覆盖(LC):参数(像元级与 CV)
| 字段 | 类型 | 说明 | 默认 |
|---|---|---|---|
| 使用影像波段参与一致性过滤 | 复选 | 需同时选择影像与 Band | 关 |
| 使用 npz 指数参与一致性过滤 | 复选 | 需选择 npz 字段 | 关 |
| 保留比例(0–1] | 浮点 | \(\alpha\);越小越严格 | 0.7 |
| 已选 Band / 已选 npz 字段 | 列表 | 参与过滤或作为训练特征白名单 | — |
表 B-34 Landsat -> 土地覆盖(LC):参数(过滤/白名单)
| 文件 | 含义 |
|---|---|
| training_data_polygon_Xy.npz | 面级:X, y, feature_names, classes, meta_counts_polygon, groups 等(每面为一组)。 |
| training_data_pixel_Xy.npz | 像元级:X, y, feature_names, classes, transform, coords, poly_ids, groups[, groups_block, fold_ids], meta_counts_pixel。 |
| *_scaler.pkl | StandardScaler(若启用)。 |
| *_label_encoder.pkl | 标签编码器(名称↔数字)。 |
表 B-35 Landsat -> 土地覆盖(LC):输出文件(可能生成)
| 分组 | 字段 | 类型 | 说明 |
|---|---|---|---|
| ① 工作空间与数据 | 模块工作空间 | 只读 | 用于默认保存路径。 |
| 训练数据(.npz) | 路径 | 读取 X,y,feature_names,coords,groups… 等字段;选后自动探测类型与切换默认输出后缀。 |
表 B-36 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 字段 | 类型 | 默认 | 说明 |
|---|---|---|---|
| n_estimators | int | 500 | 森林规模(树数)。 |
| max_depth | int | 10 | 单棵树最大深度。 |
| min_samples_split | int | 5 | 内部节点继续划分的最小样本数。 |
| min_samples_leaf | int | 2 | 叶节点最小样本数。 |
| max_features | enum | sqrt | 分裂时的特征抽样策略:sqrt/log2/auto。 |
| class_weight | enum/None | balanced_subsample | 类权重;也支持 “None”。 |
| random_state | int | 42 | 随机种子。 |
| n_jobs | int | 4 | 并行线程数。 |
表 B-37 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 字段 | 类型 | 默认 | 取值 / 范围 | 说明 | ||
|---|---|---|---|---|---|---|
| Top-K(0=禁用) | int | 0 | ≥0 | Top-K>0 时使用 Top-K 模式,否则使用“累计阈值”模式。 | ||
| 累计重要性阈值 | float | 0.95 | (0,1] | 仅在 Top-K=0 时生效;步长 0.01。 | ||
| 相关性阈值(0=禁用) | float | 0.95 | [0,1] | ( | r | ) 阈值即视为高度相关并移除后者;0 表示不启用。 |
| 从 npz 加载字段 | 按钮 | — | — | 将可用列名载入“可选列表”。 | ||
| 可选 ↔ 已选 | 列表 | — | — | “已选”即强制保留,不会在筛选阶段被移除。 |
表 B-38 Landsat -> 土地覆盖(LC):输入 / 输出与参数
| 字段 | 类型 | 默认 | 说明 |
|---|---|---|---|
| 网格单元尺寸(米) | float | 1000.0 | 基于 coords 生成 groups 的网格(自动米↔度换算 + 自适应缩放);若 groups 已存在,此行在 UI 中隐藏。 |
| 验证集每类最小样本数 | int | 5 | 受约束切分的每类下限。 |
| 切分最大重试次数 | int | 50 | 不满足下限时的最大重试次数。 |
| 验证集比例 test_size | float | 0.20 | 验证集占比。 |
| 模型路径 | 路径 | workspace/rf_model_filtered{_pixel/_poly}.pkl | 根据数据类型自动加后缀。 |
| 分类报告 | 路径 | workspace/reports/classification_report{_pixel/_poly}.json | — |
| 训练/验证划分目录 | 目录 | workspace/train_val_split{_pixel/_poly} | 写出 train/val .npz 与 split_meta.json。 |
| 启用最佳阈值搜索 | 复选 | 关 | 搜索每类最优概率阈值(步长 0.01 + 固定 0.5)。 |
| 预测阶段应用最佳阈值 | 复选 | 关 | 评估时按阈值进行多类决策。 |
| 执行训练 + 评估 + 保存 | 按钮 | — | 运行完整流程;日志实时输出。 |
表 B-39 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 分组 | 字段 | 类型 | 默认/示例 | 说明 |
|---|---|---|---|---|
| 预测级别 | 选择模式 | 下拉 | 像元级 / 矢量级 | UI 两套区域随模式切换显示。 |
| ① 工作空间与输入数据(Raster) | 模块工作空间 | 只读 | — | 记忆与回填路径。 |
| 特征 npz 路径 | 文件 | *.npz | 只读取二维数值键为特征;需含 transform。 | |
| 模型(.pkl)路径 | 文件 | *.pkl | [5] 阶段训练输出。 | |
| scaler(.pkl)路径 | 文件 | *.pkl | 训练期 StandardScaler(必需)。 | |
| 参考影像(.tif) | 文件 | *.tif | 作为输出 profile 模板。 | |
| 启用最佳阈值(.json) | 复选 | 关 | 勾选后按阈值进行多类判别。 | |
| 最佳阈值文件 | 文件 | *_thresholds.json | 与模型配套(可选)。 | |
| 输出分类图(.tif) | 文件 | classified_map.tif | uint8, nodata=255, LZW。 | |
| ① 工作空间与输入数据(Polygon) | 分割 GeoJSON | 文件 | *.geojson | 面级预测输入;内部自动CRS 对齐。 |
| 特征 npz 路径 | 文件 | *.npz | 读取基础特征与 transform/CRS。 | |
| 模型(.pkl)路径 | 文件 | *.pkl | — | |
| scaler(.pkl)路径 | 文件 | *.pkl | 可空(若训练期未使用可不填)。 | |
| 输出结果 GeoJSON | 文件 | polygon_rf_pred.geojson | 仅写极简字段(见上)。 | |
| 负/正缓冲距离(m) | float | 0.0 | 统计前对 polygon 做 buffer。 | |
| 浮点写出精度 | int | 4 | GeoJSON 落盘浮点四舍五入精度。 | |
| 将多边形结果栅格化 | 复选 | 关 | 勾选后开启下两项。 | |
| 参考影像(对齐) | 文件 | *.tif | 用于栅格化对齐。 | |
| 输出栅格(.tif) | 文件 | polygon_rf_pred.tif | uint8, nodata=255, LZW。 |
表 B-40 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 字段 | 类型 | 默认/示例 | 说明 |
|---|---|---|---|
| 模块工作空间 | 只读 | — | 作为默认输入/输出根目录。 |
| 影像路径(.tif) | 文件 | — | 多波段 GeoTIFF,裁剪与预测源。 |
| 使用像元级 npz | 复选 | 关 | 勾选后启用 .npz 路线、禁用 GeoJSON 输入。 |
| 样本 GeoJSON | 文件 | *.geojson | 训练样本(点或面),居中裁剪。 |
| 标签字段 | 文本 | name | GeoJSON 类别列名。 |
| 训练数据 npz | 文件 | *.npz | 含 coords,y,classes(可 weights)。 |
| 加载可选类别 | 按钮 | — | 读取类别值到“双列表”。 |
| 只训练所选类别 | 复选 | 关 | 未选→Other;早停 F1 仅在所选上。 |
表 B-41 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段)
| 字段 | 类型 | 默认 | 说明 |
|---|---|---|---|
| Patch Size | int | 128 | 裁剪边长(像素 32–256)。 |
| Epochs | int | 50 | 训练轮数。 |
| Batch size | int | 64 | 训练批量。 |
| Learning rate | float | 1e-3 | Adam 学习率。 |
| 混合精度(AMP) | 复选 | 开 | CUDA 上启用。 |
| 使用本地预训练权重 | 复选 | 关 | 可选 .pth/.pt 路径;未填尝试默认权重。 |
| 断点检查点 | 文件 | — | 从 checkpoint 恢复。 |
| 启用空间验证 | 复选 | 关 | 起用整格空间划分。 |
| 验证比例 | float | 0.20 | 验证集占比。 |
| 空间网格(像素) | int | 512 | 分块大小(像素)。 |
| 随机种子 | int | 42 | 切分/采样随机种子。 |
| 早停耐心 | int | 10 | Macro-F1 早停耐心。 |
表 B-42 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段)
| 字段/参数 | 类型 | 默认 | 说明 |
|---|---|---|---|
| 模型目录 | 目录 | 工作空间 | 需含 class_names.txt 与权重。 |
| 输出目录/前缀 | 目录/文本 | 工作空间/pred_ | 结果保存位置与命名前缀。 |
| 目标类名 | 下拉 | — | 额外输出该类概率图。 |
| 预测批大小 | int | 128(UI) | 实际按块内样本分批预测。 |
| patch_size | int | 64/128 | 后端可 64 或 128,多尺度时自动二倍。 |
| center_stride | int | 1 | 中心步长(>1 下采样预测)。 |
| multi_scale/use_blend/tau | bool/bool/float | 关/开/1.0 | 多尺度、融合方式与温度缩放。 |
| tile_size | int | 512 | Tile Buffer 尺寸。 |
| pixelwise_mode | bool | 关 | 一键严格像元模式(强制 patch=64,关闭多尺度/融合/温度/后处理)。 |
表 B-43 Landsat -> 土地覆盖(LC):参数一览(面板 + 后端要点)
| 分组 | 字段 | 类型 | 默认/示例 | 说明 |
|---|---|---|---|---|
| ① 路径与数据 | 模块工作空间 | 只读 | — | 记忆路径。 |
| 主模型预测图 | 文件 | classified_map.tif | RF 等主分类结果(uint8,255=NoData)。 | |
| ResNet 分类图 | 文件 | predicted_center_class_map.tif | ResNet “中心像元”分类结果(uint8)。 | |
| ResNet 概率图 | 文件 | predicted_prob_target.tif | 目标类的概率图(float32)。 | |
| ResNet 所有类概率 | 文件 | predicted_center_all_probs.tif | 可选,(C,H,W) 概率;用于方法 E。 | |
| 标签编码器 pkl | 文件 | label_encoder.pkl | 含 classes_ 与 transform。 | |
| 样本 npz | 文件 | train_val_split.npz | 用于评估(需含 coords,y)。 | |
| 输出目录 | 目录 | …/ResNet_predictedTIFF | 融合图与报告输出位置。 |
表 B-44 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
| 分组 | 字段 | 类型 | 默认/示例 | 说明 |
|---|---|---|---|---|
| ② 融合方法与参数 | 目标类名 | 文本 | Shrubland | 需与 label_encoder 中的类名一致。 |
| 置信度阈值(C/D) | float | 0.60 | C/D 使用;ResNet 概率 ≥ 阈值才视为可信。 | |
| 单次运行方法 | 下拉 | A/B/C/D/E | 选择单法运行;或勾选“运行多个方法并优选”。 | |
| 运行多个方法并自动选择最佳 | 复选 | 开 | 顺序:A → D → E → B → C(推荐)。 | |
| A.a_mask_mode | 下拉 | refine/strict | A 子策略:refine 或 strict。 | |
| D 参数 | 复合 | avg_conf≥0.70, min_pixels>10 | 连通域均值与最小像元阈值。 | |
| E 参数 | 复合 | add≥0.80, remove<0.60, margin>0.20 | 全概率一致性策略的三阈值。 |
表 B-45 Landsat -> 土地覆盖(LC):输入 / 输出与参数(面板字段一览)
B.9 Landsat -> 地表温度反演(LST)
| 字段/控件 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| Landsat 文件列表 | .tar / .tar.gz | ✓ | — | 支持多选批量;仅 LC08/LC09 的 L2SP 建议用于反演 |
| 保存目录 | 目录 | ✓ | — | 所有结果统一写入 |
| 🌿 使用 NDVI 推导 ε | 复选 | 否 | 开 | 若包内有 NDVI,将像元级估算 ε;否则回退常数 ε |
| ☁️ 应用云掩膜 | 复选 | 否 | 开 | 依赖 Fmask(值==0 为有效) |
| 输出单位 | 下拉 | 否 | 摄氏度 (°C) | 也可选 K(不缩放) |
| 运行日志 | 只读 | — | — | 打印进度/统计/错误/输出路径 |
表 B-46 Landsat -> 地表温度反演(LST):[3] 输入/输出与参数(一览)
| 参数 | 默认 | 作用 |
|---|---|---|
| apply_cloud_mask | True | 应用 Fmask(==0 为有效) |
| use_ndvi_emissivity | True | 启用 NDVI→ε(缺 NDVI 则回退 ε=0.97) |
| ε(常数模式) | 0.97 | 无 NDVI 时的统一发射率 |
| ε(NDVI) | 0.004·pv + 0.986 | pv 为 NDVI-min/max 归一后的平方 |
| LST 映射系数 a,b | a=0.00341802, b=149 | LST_K = a·BT + b |
| 输出 dtype | float32 | nodata=-9999(当前实现) |
表 B-47 Landsat -> 地表温度反演(LST):[9] 参数与默认值(速查)
B.10 空间结构关系分析总览
| 符号 | 含义 |
|---|---|
| \[i\] | 统计单元或公共支持域中心样本编号 |
| \[s\] | 统计单元边长或邻域窗口尺度 |
| \[\mathbf{X}_{i}(s)\] | 主空间结构特征向量 |
| \[\mathbf{C}_{i}(s)\] | 可选控制变量特征向量 |
| \[\mathbf{Y}_{i}(s)\] | 一个或多个响应目标/响应特征 |
| \[\mathcal{G}\] | 统一投影、范围、分辨率与对齐相位定义的公共网格 |
| \[f( \cdot )\] | 相关、非线性依赖、空间统计、多变量或贝叶斯网络方法 |
| \[{\overrightarrow{\varepsilon}}_{i}\] | 未解释误差向量 |
表 B-48 空间结构关系分析总览:1. 模块要解决什么问题?
| 页面 | 核心任务 | 主要产物 |
|---|---|---|
| 数据与对齐 | 登记多源数据、选择波段/聚合统计、裁切、重投影、对齐并生成建模数据集 | 预处理栅格、元数据、aligned_modeling_dataset.npz |
| 结构/响应特征尺度轴 | 在统计单元尺度或邻域作用尺度上提取特征、计算关系并做尺度诊断 | 阶段 A–E 表格、尺度曲线、诊断报告、GeoTIFF |
| 控制变量/多目标分析 | 组织主结构、控制变量与多个响应目标,计算净效应、协同/权衡与 Pareto 结果 | 控制后效应、多目标诊断、支持域敏感性、GeoTIFF |
| 贝叶斯网络分析 | 读取各尺度样本表,离散化并进行网络结构学习、CPT、Markov Blanket、稳定性和条件推断 | 网络边、CPT、Blanket、稳定边、交互网络图 |
表 B-49 空间结构关系分析总览:2. 页面与分析链条
| 目录 | 计算对象 | 典型条目 | 回答的问题 |
|---|---|---|---|
| 空间结构特征 | 分类/结构栅格在样方或窗口内的格局 | 类别占比、Shannon 熵、斑块密度、聚集度、边界密度、核心区指数 | “空间格局是什么样?” |
| 响应特征 | 连续响应栅格在样方内的统计或空间组织 | 均值、标准差、GLCM、半变异函数、梯度、频谱 | “响应在单元内处于什么状态并如何变化?” |
| 关系计算方法 | 结构特征与响应特征/目标的样本列 | Spearman、互信息、距离相关、GeoDetector、Moran、Elastic Net | “结构与响应之间有什么关系?” |
| 尺度分析方法 | 同一关系在多个尺度上的得分序列 | 合格固定序列的峰值、连续近峰平台、候选断点和有符号 AUC;未计算项单列 | “关系在哪些尺度最强、最稳或发生转折?” |
表 B-50 空间结构关系分析总览:3.1 四类目录的区别
| 角色 | 常见数据 | 推荐数据类型 | 后续用途 |
|---|---|---|---|
| 结构数据源 | 土地覆盖、蓝绿空间、建筑高度分级、道路结构 | 分类栅格优先,也可使用经分类的连续表面 | 计算组成、破碎化、邻接、连通、边界等特征 |
| 响应数据源 | LST、NDVI、ETa、PM2.5、CO2、产量、风险 | 连续栅格 | 计算统计、纹理、半变异、梯度或作为中心支持域响应 |
| 控制变量源 | DEM、坡度、建筑高度、人口、背景气象 | 连续或分类栅格 | 在控制变量/多目标模块中剥离背景影响 |
| 研究边界 | 行政区、研究区、有效观测范围 | GeoJSON 多边形 | 裁切和约束公共分析范围 |
表 B-51 空间结构关系分析总览:1.2 输入数据角色
| 统计量 | 代码/界面键 | 公式 | 适用说明 |
|---|---|---|---|
| 平均值 | mean | \[{\bar{v}}_{i} = \frac{1}{n_{i}}\sum_{j = 1}^{n_{i}}v_{ij}\] | 连续变量的中心水平 |
| 中位数 | median | \[median(V_{i})\] | 对异常值更稳健 |
| 标准差 | std | \[\sigma_{i} = \sqrt{\frac{1}{n_{i}}\sum_{j}^{}(v_{ij} - {\bar{v}}_{i})^{2}}\] | 单元内部离散程度;实现采用总体标准差 |
| 最小/最大值 | min / max | \(min(V_{i})\) / \(max(V_{i})\) | 极端状态 |
| 总和 | sum | \[\sum_{j}^{}v_{ij}\] | 总量型变量;会混入面积/有效像元数效应 |
| 多数值 | majority | \[\arg\max_{c}\sum_{j}^{}\mathbf{1}(v_{ij} = c)\] | 分类栅格;避免对类别编码求平均 |
表 B-52 空间结构关系分析总览:1.3 格网聚合统计
| 数据语义 | 推荐重采样 | 原因 |
|---|---|---|
| 分类编码、土地覆盖类别 | 最近邻 | 不产生不存在的中间类别 |
| 连续温度、指数、浓度 | 双线性或连续值适配方法 | 保持连续表面的平滑性 |
| 面积/总量 | 按业务语义选择并验证守恒 | 普通插值可能改变总量 |
表 B-53 空间结构关系分析总览:1.4.3 重采样选择
| 比较项 | 统计单元尺度 | 邻域作用尺度 |
|---|---|---|
| 尺度含义 | 聚合/统计单元大小 | 中心样本周围的作用窗口 |
| 响应支持域 | 随样方尺度变化 | 固定中心支持域或中心像元 |
| 样本位置 | 各尺度网格单元 | 尽量保持公共中心点 |
| 主要风险 | MAUP、粗尺度样本数下降 | 边界窗口损失、支持域锚点敏感 |
| 结论表述 | “在某统计单元尺度关系最强” | “某邻域范围对中心响应解释最强” |
表 B-54 空间结构关系分析总览:2.3 不可混用的结论
| 内部阶段 | 任务 | 典型文件 | 可复用价值 |
|---|---|---|---|
| A-0 | 构建或读取公共网格、源数据与分类元数据 | common_grid*.json/.npy、manifest | 保证各阶段使用同一空间定义 |
| A | 逐尺度提取结构特征 | stage_a_structure_features.csv、schema、positions | 更换关系方法时无需重算特征 |
| B | 提取响应特征或中心支持域响应值 | stage_b_response_features.csv | 更换关系方法时复用响应 |
| C | 按位置索引合并结构与响应 | stage_c_quadrat_dataset.csv | 贝叶斯网络及其他模型的直接输入 |
| D | 计算两两关系、多变量关系和局部空间结果 | stage_d_relations.csv、stage_d_multivariate.csv、stage_d_spatial_outputs.csv | 更换尺度诊断时无需重算关系 |
| E | 跨尺度诊断并生成报告 | stage_e_*diagnostics.csv、stage_e_scale_report.txt | 形成可审阅的尺度结论 |
表 B-55 空间结构关系分析总览:3. 共同的阶段化计算
| 内容 | 用途 |
|---|---|
| manifest / 配置 JSON | 记录数据源、尺度、特征、方法、参数、并行和版本 |
| schema JSON | 把机器字段名映射为来源、角色、特征和分量语义 |
| positions / grid metadata | 把表格行还原到空间位置 |
| 阶段 A–E CSV | 审计每一步结果,支持断点复用 |
| 报告与导出 GeoTIFF | 论文制图、规划表达和 GIS 复核 |
表 B-56 空间结构关系分析总览:4. 目录、manifest 与可复现性
| 术语 | 本系统中的含义 |
|---|---|
| 空间支持域 | 某个数值实际代表的空间范围,不等同于文件像元大小 |
| 对齐锚点 | 决定公共网格原点/相位的参考源或自动策略 |
| 统计单元 | 用于同时汇总结构和响应的规则样方 |
| 中心支持域 | 邻域模式中固定的响应提取单元 |
| 邻域窗口 | 围绕中心支持域提取结构特征的奇数方窗 |
| 特征分量 | 一个特征展开后的子列,例如各类别占比或各 GLCM 指标 |
| 关系得分 | 某方法输出的相关、依赖、解释力或模型拟合量 |
| 主尺度 | 得分峰值、平滑峰值、稳定平台或综合诊断支持的尺度候选 |
| 样方级空间输出 | 在每个样方/中心位置产生、可回写 GeoTIFF 的局部系数或指数 |
表 B-57 空间结构关系分析总览:5. 术语速查
B.11 结构/响应特征尺度轴
| 符号 | 含义 |
|---|---|
| \[A\] | 一个样方/窗口内有效像元总数 |
| \[m\] | 有效类别数 |
| \(A_{i}\)、\(p_{i} = A_{i}/A\) | 类别 \(i\) 的像元数与占比 |
| \[N_{p}\] | 所有类别的连通斑块总数 |
| \[a_{ij},e_{ij}\] | 类别 \(i\) 第 \(j\) 个斑块的面积(像元数)与周长(像元边数) |
| \[g_{ii}\] | 类别 \(i\) 的单计数同类邻接数 |
| \[G_{i}\] | 类别 \(i\) 的总邻接机会数 |
| \[E\] | 异类水平/垂直边数;若明确写 \(E_{b}\) 则包含外边界 |
| \[r_{0}\] | 公共网格基础分辨率 |
| \[s\] | 统计单元物理尺度 |
| \[w\] | 邻域窗口像元边长,必须为不小于 3 的奇数 |
表 B-58 结构/响应特征尺度轴:1. 分析目标与基本记号
| 配置方式 | 示例 | 说明 |
|---|---|---|
| 手工输入 | 30, 60, 120, 240 | 完全控制尺度列表 |
| 等距序列 | 起点 30、终点 300、步长 30 | \[s_{j} = s_{0} + j\Delta s\] |
| 倍数序列 | 起点 30、倍数 2、数量 7 | \[s_{j} = s_{0}q^{j}\] |
| 连续样方生成 | 按默认连续尺度生成 | 结合公共范围和基础分辨率产生可计算尺度 |
表 B-59 结构/响应特征尺度轴:1.3 尺度序列
| 项目 | 统计单元尺度 | 邻域作用尺度 |
|---|---|---|
| 尺度单位 | 通常为米 | 奇数像元窗口及其近似物理范围 |
| 结构支持域 | 当前样方 | 中心周围滑窗 |
| 响应支持域 | 同一尺度样方 | 固定公共中心支持域 |
| 尺度增大时样本 | 网格变粗,数量明显下降 | 中心位置尽量一致,边缘样本减少 |
| 解释 | 聚合单元尺度效应 | 邻域作用范围效应 |
表 B-60 结构/响应特征尺度轴:2.3 与统计单元尺度的关键差异
| 特征(键) | 当前实现公式/计算 | 解释 |
|---|---|---|
| 斑块大小 (clump_size) | \[\bar{a} = \frac{1}{N_{p}}\sum a_{ij}\] | PyLandStats;按 connectivity 指定斑块,平均面积为 m²,不是完整大小直方图 |
| 斑块大小统计 (clump_size_stats) | \[{CV}_{a} = 100\frac{\sigma(a)}{mean(a)}\] | PyLandStats;面积变异系数按百分比输出,解释时区分 CV 与 CV×100 |
| 层级分解/层级熵 | 每一层子块 \(H = - \sum_{c}^{}p_{c}ln(p_{c} + 10^{- 12})\),输出各层均值和跨层均值 | 描述不同粗分层级的类别异质性 |
| 层级多尺度 | 各层子块标准差均值 \(C_{l} = {mean}_{q}\lbrack\sigma(Q_{lq})\rbrack\) | 描述结构对分块尺度的对比度响应 |
| 图像块类别频数 (patch_histogram) | \(\mathbf{n} = (A_{1},\ldots,A_{m})\),摘要为 \(m\) | 保留各类别数量向量 |
| Shannon 熵 (shannon_entropy) | \[H = - \sum_{i = 1}^{m}p_{i}ln(p_{i} + 10^{- 12})\] | 类别组成多样性 |
| Shannon 均匀度 (shannon_evenness_index) | \(SHEI = H/lnm\),\(m > 1\) | 类别分布均匀程度 |
| 类别占比 (class_proportion) | \(p_{i} = A_{i}/A\),摘要为 \(\max_{i}p_{i}\) | 有效类别未出现占比为 0;无有效支持为缺失;联合解释类别份额 |
| 斑块密度 (patch_density) | \[PD = \frac{N_{p}}{A_{ha}}\] | PyLandStats;有效面积以 ha 计,输出斑块数/ha |
| 最大斑块指数 (largest_patch_index) | \[LPI = 100max(a_{ij})/A\] | 最大斑块控制程度 |
| 分裂指数 (split_index) | \[SPLIT = 1/\sum_{ij}^{}(a_{ij}/A)^{2}\] | 等效斑块分裂数,越大越破碎 |
| 景观分割指数 (landscape_division_index) | \[DIVISION = 1 - \sum_{ij}^{}(a_{ij}/A)^{2}\] | 两个随机像元位于不同斑块的概率型指标 |
| 有效网格面积 (effective_mesh_size) | \[MESH = \sum_{ij}^{}a_{ij}^{2}/A\] | PyLandStats;MESH 输出 m²,不使用像元数量作为面积单位 |
| 分形维数 (fractal_dimension) | \[D = slope\lbrack lnN(\epsilon),ln(1/\epsilon)\rbrack\] | 对类别内部界面占据盒计数,至少 3 个有效尺度;NoData 界面不当作地类界面 |
| 景观形状指数 (landscape_shape_index) | \[LSI = 0.25E_{b}/\sqrt{A}\] | PyLandStats 景观形状指数,边界条件与邻接规则随 schema 保存 |
表 B-61 结构/响应特征尺度轴:3.1 组成、破碎化、尺度与形态
| 特征(键) | 当前实现公式/计算 | 解释与参数 |
|---|---|---|
| 共现直方图 | \(P_{ab} = n_{ab}/\sum_{uv}^{}n_{uv}\);摘要 \(H_{c} = - \sum_{ab}^{}P_{ab}ln(P_{ab} + 10^{- 12})\) | 四方向类别共现及其熵 |
| 共现同类比例 | \[P_{same} = N_{same}/N_{valid\ pairs}\] | 相邻像元同类比例 |
| 共现转移比例 | \[P_{trans} = E/N_{valid\ pairs}\] | 相邻像元异类比例 |
| 方向连接度 | \(q_{\theta} = Pr(z_{u} = z_{v} \mid \theta)\);\(D_{ani} = std(q_{0},q_{45},q_{90},q_{135})\) | 值越大表示四方向同类邻接差异越明显 |
| 类别边界长度 | \(E_{i} =\) 类别 \(i\) 的异类边加外边界;摘要为 \(E_{b}\) | 输出各类别边长和景观总边长 |
| 邻接比/PLADJ 型 (contiguity_ratio) | \(PLADJ_{i} = 100 \cdot 2g_{ii}/G_{i}\);摘要按邻接机会加权 | 类内邻接程度;不是一般几何 contiguity 指数 |
| 聚集度 (aggregation_index) | \(AI_{i} = 100g_{ii}/g_{ii}^{\max}(A_{i})\);\(AI = \sum_{i}^{}p_{i}AI_{i}\) | \(g_{ii}^{\max}\) 按最紧凑方形排列估计 |
| 蔓延度 (contagion_index) | \[CONTAG = 100\left\lbrack 1 + \frac{\sum_{i}^{}{\sum_{j}^{}p_{i}}(g_{ij}/\sum_{k}^{}g_{ik})ln\lbrack p_{i}(g_{ij}/\sum_{k}^{}g_{ik})\rbrack}{2\ln m} \right\rbrack\] | 景观整体团聚与蔓延;单类景观无效 |
| 镶嵌与毗邻 (IJI) | \[IJI = - 100\frac{\sum_{k}^{}e_{k}^{*}ln(e_{k}^{*} + 10^{- 12})}{ln\lbrack m(m - 1)/2\rbrack}\] | \(e_{k}^{*}\) 为异类边类型占比;类别少于 3 时无效 |
| 斑块凝聚度 (patch_cohesion_index) | \[COHESION = 100\frac{1 - \sum e_{ij}/\sum(e_{ij}\sqrt{a_{ij}})}{1 - 1/\sqrt{A}}\] | 输出景观摘要及类别值 |
| 蔟集度 (clumpiness_index) | 令 \(G_{i} = 2g_{ii}/G_{i}^{total}\);按 \(G_{i} \geq p_{i}\)、\(p_{i} < 0.5\) 等分段计算 \((G_{i} - p_{i})/(1 - p_{i})\) 或 \((G_{i} - p_{i})/p_{i}\) | 输出范围截断到 \(\lbrack - 1,1\rbrack\);按类别解释 |
| 边界密度 (edge_density) | \[ED = \frac{E_{m}}{A_{ha}}\] | PyLandStats;边长以 m、有效面积以 ha 计,ED 为 m/ha |
| 欧氏最近邻 (nearest_neighbor) | \[ENN_{i} = {mean}_{j}\min_{k \neq j}d(P_{ij},P_{ik})\] | PyLandStats 标准最近邻距离 \(d\),单位 m;不把像元数当作物理距离 |
| 邻近度 (proximity_index) | \(PROX_{ij} = \sum_{k \neq j,d_{jk} \leq r}^{}a_{ik}/d_{jk}^{2}\),再对斑块求均值 | 默认搜索半径 search_radius=5 像元 |
| 连通度 (connectance_index) | \[CONNECT_{i} = 100N_{connected}/\lbrack n_{i}(n_{i} - 1)/2\rbrack\] | 当斑块最短距离不大于默认阈值 5 像元时视为连接 |
| 类别界面暴露 | \[IE_{i} = (G_{i} - 2g_{ii})/G_{i}\] | 异类邻接占总邻接比例 |
| 类别核心区比例 | \[CAR_{i} = A_{i}^{core}/A_{i}\] | USDA 欧氏像元中心距离及外边界策略;NoData 孔洞计入边界;默认深度按当前配置 |
| 总核心区面积 (total_core_area) | \[TCA = \sum_{i}^{}A_{i}^{core}\] | 单位为像元数 |
| 核心区指数 (core_area_index) | \[CAI = 100TCA/A\] | 核心腹地占整个有效样方的比例 |
表 B-62 结构/响应特征尺度轴:3.2 邻接、边界与连通
| 特征 | 实现式 | 注意 |
|---|---|---|
| 局部自相似度 | \[LSS = {mean}_{u}\lbrack\max_{c}n_{uc}/n_{u}\rbrack\] | 在奇数局部窗内计算主导类别比例后求均值 |
| 探索性组成集中度代理(已停用) | \[S = \sum_{i}^{}p_{i}^{2}\] | 不以该代理冒充 PCA/特征空间稀疏度,正式结果不参与该特征 |
| 探索性有效掩膜连接代理(已停用) | \[GSI = \max_{j}a_{j}/A_{valid}\] | 不以掩膜连通代理冒充类别图结构指标 |
表 B-63 结构/响应特征尺度轴:3.3 探索型补充特征
| 指标 | 公式 |
|---|---|
| Contrast | \[\sum_{ij}^{}(i - j)^{2}P(i,j)\] |
| Dissimilarity | \[\sum_{ij}^{}|i - j|P(i,j)\] |
| Homogeneity | \[\sum_{ij}^{}\frac{P(i,j)}{1 + (i - j)^{2}}\] |
| ASM | \[\sum_{ij}^{}P(i,j)^{2}\] |
| Energy | \[\sqrt{ASM}\] |
| Correlation | \[\sum_{ij}^{}\frac{(i - \mu_{i})(j - \mu_{j})P(i,j)}{\sigma_{i}\sigma_{j}}\] |
表 B-64 结构/响应特征尺度轴:4.2 GLCM 纹理
| 特征 | 当前实现 | 默认参数/解释 |
|---|---|---|
| 分形与尺度 | 连续表面 \({\gamma(h) \propto h}^{2H}\),\(D = 3 - H\);至少 3 个 lag,拟合 R²≥0.8、0≤H≤1 | 分类边界 box-counting 与连续表面分形分开;条件不足为未定义 |
| 梯度与边缘 | Sobel 使用有效 3×3 邻域;\({g = \sqrt{}(g}_{x}^{2}{+ g}_{y}^{2})\) 按物理分辨率归一,\({Pr(g > edge}_{t}hreshold)\) 用于边缘比例 | 不采用各窗口 75% 分位阈值固定约 25% 边缘比例;阈值与单位随配置保存 |
| 多尺度频率 | Hann 窗后 \(F = FFT2(z - \bar{z})\)、功率 \(P = |F|^{2}\);低/高频功率比为指定径向频带功率除总功率 | low_ratio=0.15、high_ratio=0.35 |
| 频谱熵 | \[H_{f} = - \sum_{k}^{}q_{k}ln(q_{k} + 10^{- 12}),\ q_{k} = P_{k}/\sum P\] | 衡量频谱分散程度 |
| 主导波长 | \[\lambda^{*} = 1/f^{*}\] | \(f^{*}\) 为非零径向峰值频率,结合分辨率返回物理波长;恒定窗口频率/波长未定义 |
表 B-65 结构/响应特征尺度轴:4.4 分形、梯度与频率
| 方法 | 公式 | 输出与解释 |
|---|---|---|
| Spearman | \[\rho_{s} = corr(rank(x),rank(y))\] | SciPy 输出 \(\rho_{s}\)、\({|\rho}_{s}|\) 及解析 P/FDR;IID 假设,不是空间置换检验 |
| 互信息 | \[I(X;Y) = \iint p(x,y)ln\frac{p(x,y)}{p(x)p(y)}dxdy\] | mutual_info_regression 的非负依赖量;0 近似独立 |
| 距离相关 | 对距离矩阵 \(a_{ij} = |x_{i} - x_{j}|\)、\(b_{ij} = |y_{i} - y_{j}|\) 双中心化为 \(A,B\);\(dCor = \frac{\sqrt{\overline{AB}}}{\sqrt{\sqrt{\overline{A^{2}}}\sqrt{\overline{B^{2}}}}}\) | dcor 真实后端,精确复杂度 \({O(n}^{2})\);抽样或跳过按实际参数记录 |
| GeoDetector | \[q = 1 - \frac{\sum_{h}^{}N_{h}\sigma_{h}^{2}}{N\sigma^{2}}\] | 分类 \(x\) 直接按类别分层,连续变量按配置分位分箱;\(q \in \lbrack 0,1\rbrack\),至少两个有效层 |
| 双变量 Moran | 标准化 \(z_{x},z_{y}\),以 Queen 邻域行标准化空间滞后 \(Wz_{y}\);\(I_{xy} = \frac{n}{S_{0}}\frac{z_{x}^{T}(Wz_{y})}{z_{x}^{T}z_{x}}\) | libpysal Queen 行标准化与 esda;\(x\) 与邻域 \(y\) 空间关联,孤立单元滞后为 0 |
表 B-66 结构/响应特征尺度轴:5.1 两两关系
| 方法 | 核心公式/实现 | 作用 |
|---|---|---|
| Elastic Net | \[\min_{\beta}\frac{1}{2n} \parallel y - X\beta \parallel_{2}^{2} + \lambda\lbrack\alpha \parallel \beta \parallel_{1} + \frac{1 - \alpha}{2} \parallel \beta \parallel_{2}^{2}\rbrack\] | Pipeline/GridSearchCV 内层空间调参,外层有效折 \(R^{2}\),训练折预处理 |
| PLS | \(X = TP^{T} + E,\ y = Uq^{T} + f\),潜变量使 \(Cov(t,u)\) 尽可能大 | 默认 2 个分量,适合相关结构特征的联合建模 |
| VIF/相关聚类 | \[VIF_{j} = 1/(1 - R_{j}^{2})\] | 默认阈值 VIF=10、相关阈值 0.9,用于冗余诊断 |
| Boruta | 将真实特征重要度与随机打乱的 shadow 特征重要度比较 | 可选 BorutaPy 依赖可用时执行;默认最大 50 轮 |
| Spatial Block CV | 将空间位置划为块,逐块训练/验证并汇总 \(R^{2} = 1 - \frac{\sum(y - \widehat{y})^{2}}{\sum(y - \bar{y})^{2}}\) | 共同有效样本、外层空间划分、至少 3 个有效折;邻域窗口强制训练/测试隔离 |
| MGWR | \[y_{i} = \beta_{0}(u_{i},v_{i}) + \sum_{k}^{}\beta_{k}(u_{i},v_{i})x_{ik} + \epsilon_{i}\] | mgwr 真实后端;样本内拟合标为 descriptive_fit,不作为预测可靠性证据 |
| Spatial Durbin | \[y = \rho Wy + X\beta + WX\theta + \epsilon\] | spreg 真实后端;pr2 为描述性伪 R²,不与外层验证 R² 混排 |
表 B-67 结构/响应特征尺度轴:5.2 多变量与稳健性方法
| 诊断 | 当前实现公式 | 解释 |
|---|---|---|
| 优势尺度峰值 | \[s^{*} = arg\max_{s}\bar{R}(s)\] | 只在固定对象、同指标及合格记录中识别候选统计峰值 |
| 平台区 | 若 \(R_{\max} > 0\),\(\{ s:R(s) \geq 0.95R_{\max}\}\);否则 \(\{ s:R(s) \geq R_{\max} - 0.05\}\) | 取峰值周围连续近峰区段,不能将不连续近峰点拼成整轴稳定平台 |
| 平滑峰值 | \({\widetilde{R}}_{j} = 0.25R_{j - 1} + 0.5R_{j} + 0.25R_{j + 1}\),端点复制;\(s_{sm}^{*} = argmax\widetilde{R}\) | 抑制单点锯齿噪声 |
| Bootstrap 峰值区间 | 空间重抽样峰值区间当前未计算,\(B\) 不启用,不能生成置信度 | \(B\) 无有效重复样本设计;不以零宽区间或不同对象重复充当 Bootstrap |
| 斜率突变断点 | \(d_{j} = (R_{j + 1} - R_{j})/(s_{j + 1} - s_{j})\);\(s_{b} = s_{argmax|d_{j + 1} - d_{j}| + 1}\) | 至少 3 个尺度 |
| 分段回归断点 | \[{J = \Sigma}_{segments}{RSS + \beta K;\ length}_{segment} \geq 3\] | 每段至少 3 个点;常数/线性曲线不强制分段 |
| 尺度积分 | \[{AUC = \int}_{s_{\min}}^{s_{\max}}R(s)ds\] | 梯形积分保留得分符号;负 R² 不因绝对值大变为优秀 |
| 标准化积分 | \[AUC_{norm} = AUC/(s_{\max} - s_{\min})\] | 按合法尺度跨度归一,不能跨异质指标直接排名 |
| 半变异参考尺度 | \[s_{vario} = mean(\widehat{a})\] | 用响应半变异函数有效变程校验主尺度 |
| 变程偏差 | \[\Delta_{s} = |s^{*} - s_{vario}|\] | 越小表示关系峰值与响应内在空间作用尺度越接近 |
| 独立尺度一致性(未计算) | \[{\bar{\tau}}_{b} = {mean}_{a < b}\tau_{b}(rank_{a},rank_{b})\] | 方法间排序描述不等于独立验证;当前不生成稳定性结论 |
表 B-68 结构/响应特征尺度轴:6.1 代码实际采用的指标
| 预设 | Bootstrap 状态 | 数值精度 | 适用 |
|---|---|---|---|
| 快速 | 未计算 | 通常 float32 | 参数试跑与流程检查 |
| 平衡 | 未计算 | float32 | 默认正式分析起点 |
| 精确 | 未计算 | 可选 float64 | 数值精度配置不代表已开展重抽样检验 |
表 B-69 结构/响应特征尺度轴:6.2 尺度分析性能/精度
| 阶段 | 统计单元尺度 | 邻域作用尺度 | 主要输出 |
|---|---|---|---|
| A-0 | 公共规则网格 | 公共中心支持域 | 网格元数据、源配置 |
| A | 各样方结构特征 | 各窗口结构特征 | stage_a_structure_features.csv |
| B | 各样方响应特征 | 中心支持域响应值 | stage_b_response_features.csv |
| C | 统一样方数据 | 统一滑窗样本数据 | stage_c_quadrat_dataset.csv |
| D | 关系、多变量和空间输出 | 关系、多变量和空间输出 | stage_d_relations.csv、stage_d_multivariate.csv、stage_d_spatial_outputs.csv |
| E | 尺度诊断与报告 | 尺度诊断与报告 | stage_e_feature_scale_diagnostics.csv、stage_e_method_scale_diagnostics.csv、stage_e_scale_report.txt |
表 B-70 结构/响应特征尺度轴:7.1 阶段 A–E
| 分区 | 参数 | 当前默认/规则 | 影响 |
|---|---|---|---|
| 数据源 | 结构/响应波段 | 用户选择 | 决定变量语义 |
| 对齐 | grid_alignment_source | 自动或指定源 | 决定公共网格相位和边界 |
| 统计单元 | 尺度模式 | 基础分辨率整数倍或任意连续 | 决定 \(s \rightarrow b(s)\) 的换算 |
| 邻域 | 窗口 | 3 以上奇数正方形 | 决定作用范围与边缘损失 |
| 结构斑块 | connectivity | 2,即 8 连通 | 决定斑块数量与面积 |
| GLCM | distance / levels / angles | 1 / 32 / 0,45,90,135 | 纹理尺度和量化精度 |
| 半变异 | max_lag / lag_step / model | 6 / 1 / spherical | 经验半方差范围与模型 |
| GeoDetector | bins | 6 | 分层粒度 |
| Elastic Net | cv | 5 | 惩罚参数选择稳定性 |
| PLS | n_components | 2 | 潜变量复杂度 |
| 尺度诊断 | Bootstrap 峰值区间 | 未计算 | 不得生成置信度或稳定区间 |
| 并行 | workers | -1 自动 | 速度、CPU 与内存占用 |
| 复用 | reuse | 默认勾选 | 读取参数匹配的正式阶段文件 |
| 恢复 | resume | 默认不勾选 | 从匹配的中断临时快照继续 |
表 B-71 结构/响应特征尺度轴:[9] 参数与默认值速查
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 公共范围为空 | CRS 错误或数据不相交 | 在“数据与对齐”检查坐标和范围 |
| 分类结构出现小数类别 | 使用了双线性重采样 | 改用最近邻并重新预处理 |
| 粗尺度得分很高但不稳定 | 有效样本太少 | 缩小最大尺度或增加研究范围 |
| 曲线峰值在最小/最大端点 | 尺度搜索范围不足 | 向相应方向扩展尺度序列 |
| 距离相关未执行 | 精确 \(O(n^{2})\) 样本超过保护阈值 | 调整样本/参数或使用互信息 |
| MGWR/Spatial Durbin 不可用 | 可选依赖缺失或样本条件不足 | 查看方法执行状态与日志 |
| 复用后结果不是当前参数 | 结果目录或 manifest 不匹配 | 关闭复用后重算,并使用独立批次目录 |
| GeoTIFF 波段难以识别 | 未保存 schema/波段顺序 | 同步归档导出说明与 schema |
表 B-72 结构/响应特征尺度轴:[11] 常见误区与排错
B.12 控制变量 / 多目标分析
| 角色 | 符号 | 含义 | 示例 |
|---|---|---|---|
| 主结构源 | \[\mathbf{X}\] | 研究重点的空间结构或结构特征 | 土地覆盖、蓝绿格局、道路形态 |
| 控制变量源 | \[\mathbf{C}\] | 可能同时影响结构与响应的背景变量 | DEM、建筑高度、人口、背景气象 |
| 响应目标源 | \[\mathbf{Y} = (Y_{1},\ldots,Y_{T})\] | 需要同时优化或解释的多个结果 | 降低 LST/PM2.5,同时提高 NDVI/生态服务 |
| 空间尺度 | \[s\] | 规则统计单元边长或邻域窗口 | 500–3000 m,或 3×3–17×17 |
表 B-73 控制变量 / 多目标分析:1. 分析问题与变量角色
| 选项 | 公式 | 适用情形 |
|---|---|---|
| 均值(默认) | \[y_{i} = \frac{1}{n_{i}}\sum_{j}^{}v_{ij}\] | 稳定表达中心支持域总体水平 |
| 中位数 | \[y_{i} = Q_{0.5}(V_{i})\] | 异常值或偏态明显 |
| 75 分位数 | \[y_{i} = Q_{0.75}(V_{i})\] | 关注高暴露/高值状态 |
| 最大值 | \[y_{i} = max(V_{i})\] | 关注极端风险;对噪声敏感 |
| 中心点单像元 | \[y_{i} = v(r_{i},c_{i})\] | 原始响应像元可靠且无需支持域平滑 |
表 B-74 控制变量 / 多目标分析:2.2 中心支持域响应聚合
| 方法 | 公式 | 解释 |
|---|---|---|
| Pearson 协同/权衡 | \[r = \frac{\Sigma_{i}{(x}_{ik}{- x\bar{}}_{k}{)(y}_{i} - ȳ)}{\sqrt{\Sigma_{i}{(x}_{ik}{- x\bar{}}_{k})^{2}\Sigma_{i}{(y}_{i}{- ȳ)}^{2}}}\] | 相关正负描述响应关系,需核对改善方向;不直接称生态协同/权衡 |
| Spearman | \[\rho_{s} = corr(rank(x),rank(y))\] | 基础阶段逐结构特征计算,报告相关与 P 值 |
| Kendall | \(\tau = (N_{c} - N_{d})/\binom{n}{2}\)(实现使用可处理并列的 SciPy Kendall) | 秩次关系,对异常值更稳健;可设 sample_cap |
表 B-75 控制变量 / 多目标分析:4.2 Pearson、Spearman 与 Kendall
| 方法 | 当前默认 | 说明 |
|---|---|---|
| Random Forest | n_estimators=400, max_depth=12, min_samples_leaf=2 | Bagging 非线性回归,稳健起点 |
| XGBoost | 300 棵、深度 4、学习率 0.05、hist | 复杂非线性和交互;依赖可用时执行 |
| LightGBM | 300 棵、31 叶、学习率 0.05 | 高效梯度提升;依赖可用时执行 |
| CatBoost | 300 轮、深度 6、学习率 0.05 | 稳健提升树;依赖可用时执行 |
表 B-76 控制变量 / 多目标分析:7.1 树模型
| 曲线 | 较大值通常表示 |
|---|---|
| 控制后净效应 | 主结构在控制背景后的解释增量更高 |
| Synergy Index | 方向校正物理目标对的正 Spearman 关联强度均值 |
| Trade-off Intensity | 方向校正物理目标对的负 Spearman 关联强度均值 |
| CCD | 固定源数据参考满意度的几何/算术均值比与目标水平组合 |
| Pareto share | pymoo 精确非支配前沿成员占比;不证明真实改善或共赢 |
表 B-77 控制变量 / 多目标分析:[9] 共赢—冲突尺度曲线
| 方法 | 计算含义 | 结论写法 |
|---|---|---|
| 净效应峰值 | \[s_{NE}^{*} = arg\max_{s}\Delta R_{X}^{2}(s)\] | 控制后主结构解释增量最大的尺度 |
| 协同峰值 | \[s_{S}^{*} = arg\max_{s}S_{global}(s)\] | 合格目标正关联强度峰值,作为候选分析尺度 |
| 权衡峰值 | \[s_{T}^{*} = arg\max_{s}T_{global}(s)\] | 合格目标负关联强度峰值,作为冲突候选范围,非优化目标 |
| 共赢峰值 | \[s_{P}^{*} = arg\max_{s}P_{win}(s)\] | Pareto 第一前沿占比最大的尺度 |
| 独立尺度一致性(未计算) | 未开展独立复验,跨方法峰值 \({\sigma(s}^{*})\) 的描述不构成独立一致性验证 | 方法峰值描述不替代独立稳定性检验 |
| 转折尺度 | 真实尺度横轴下的惩罚分段模型,需优于未分段模型;最少每段 3 个点 | 协同—权衡趋势发生明显切换的候选尺度 |
| 支持域敏感性 | 重算不同锚点和窗口方案并比较结论 | 仅邻域模式可用 |
| 综合协同报告 | 汇总净效应、协同、权衡、Pareto、平台、断点与一致性 | 形成最终多目标尺度摘要 |
表 B-78 控制变量 / 多目标分析:10.1 专用尺度方法
| 方法 | 样方级字段示例 | 值的含义 |
|---|---|---|
| 综合目标水平 | stage_d__objective_level | \(T_{i}\),固定参考满意度均值,不是局部协同效应 |
| 目标水平不均衡度 | stage_d__objective_imbalance | \(I_{i}\),固定参考满意度标准差,不直接解释生态冲突 |
| CCD | stage_d__local_coupling_coordination | \(D_{i}\),局部协调度 |
| Pareto | stage_d__pareto_front_membership | 1=非支配成员,0=被支配;未输出完整多层 rank |
| 旧版共赢掩膜 | stage_d__pareto_winwin_mask(历史字段) | 按旧 schema 识别,不自动当作新版有效成员或真实共赢 |
| 模型样本外预测 | stage_d__oof_prediction__<token> | 预测值不是局部因果净效应;未验证样本保留缺失 |
| MGWR / 空间模型 | 局部系数、局部 \(R^{2}\) 等 | 空间非平稳结果,视依赖与方法而定 |
表 B-79 控制变量 / 多目标分析:13.1 可导出的局部量
| 阶段 | 主要内容 | 典型文件 |
|---|---|---|
| A | 多主结构与控制变量特征 | stage_a_structure_features.csv 及 schema |
| B | 响应特征或中心支持域响应 | stage_b_response_features.csv |
| C | 统一多角色样本 | stage_c_quadrat_dataset.csv |
| D | 基础关系、多变量、控制/多目标与局部空间输出 | stage_d_relations.csv、stage_d_multivariate.csv、stage_d_control_target.csv、stage_d_spatial_outputs.csv |
| E | 响应组/方法尺度诊断与综合协同报告 | stage_e_feature_scale_diagnostics.csv、stage_e_method_scale_diagnostics.csv、stage_e_scale_report.txt |
| E+ | 邻域支持域锚点/窗口情景比较 | support sensitivity 比较表、报告与 scenario manifest |
表 B-80 控制变量 / 多目标分析:[14] 阶段文件与复用
| 方法 | 关键参数 | 当前默认/说明 |
|---|---|---|
| Pearson / Kendall | min_samples | 最少 12;当前逐结构字段相关及 FDR,不以方向直接认定生态协同 |
| Partial Correlation | min_samples, sample_cap, max_control_features | 最少 12、默认控制上限 16;超上限显式拒绝,不悄悄删除控制源 |
| Synergy | aggregation | 方向校正的物理目标对 Spearman 正部均值 |
| Trade-off | aggregation | 方向校正的物理目标对 Spearman 负部均值 |
| CCD | alpha | 0.5 |
| Pareto | directions、algorithm | 必须明确物理目标方向;exact_physical_front,不使用近似前沿 |
| Elastic Net | cv, l1_ratio_grid | 5;默认比例网格 0.2–1.0 |
| PLS | n_components | 2 |
| Random Forest | 树数、深度、叶最小样本 | 400 / 12 / 2 |
| XGBoost | 树数、深度、学习率 | 300 / 4 / 0.05 |
| LightGBM | 树数、叶数、学习率 | 300 / 31 / 0.05 |
| CatBoost | 轮数、深度、学习率 | 300 / 6 / 0.05 |
| 树重要度 | importance_mode, shap_sample_cap, permutation_repeats | 按实际 SHAP/置换/原生身份记录;依赖失败不冒充 SHAP |
| Spatial Block CV | blocks / cv | 基础默认 4 / 4 |
表 B-81 控制变量 / 多目标分析:[15] 方法参数速查
| 误区 | 正确处理 |
|---|---|
| 把控制后净效应当作因果效应 | 说明只控制了已纳入的变量,仍可能有遗漏混杂 |
| 把 Trade-off 峰值当作最佳尺度 | 它表示冲突最强,应与 Synergy、CCD、Pareto 联合判断 |
| 自动方向推断后不复核 | 根据业务语义人工确认每个响应的期望方向 |
| 用树模型训练 \(R^{2}\) 宣称泛化性能 | 查看实际模型评分协议、至少 3 个有效空间折及异常记录 |
| 把 SHAP 当作因果贡献 | SHAP 分解模型预测,不证明干预效应 |
| 比较不同方法的原始得分大小 | 按各方法语义比较曲线、排序和尺度诊断 |
| 忽略支持域 | 在报告中写明对齐锚点、中心响应聚合和窗口序列 |
| 只看总体值不看空间图 | 导出样方级结果,检查热点是否由边界、NoData 或异常样本造成 |
表 B-82 控制变量 / 多目标分析:[17] 解释边界与常见误区
B.13 贝叶斯网络分析
| 来源类型 | 目录 | 前置条件 |
|---|---|---|
| 1 对 1 统计单元尺度 | statistical_unit_scale | 各尺度目录存在 stage_c_quadrat_dataset.csv |
| 控制变量/多目标统计单元尺度 | control_target_unit_scale | 各尺度目录存在统一多角色样本表 |
表 B-83 贝叶斯网络分析:1.2 可用来源
| 分箱较少 | 分箱较多 |
|---|---|
| CPT 更稠密、样本要求较低、细节损失较大 | 状态更细、CPT 组合快速增加、稀疏风险更高 |
表 B-84 贝叶斯网络分析:2.3 分箱数的影响
| 参数 | 界面范围 | 默认 | 含义与建议 |
|---|---|---|---|
| 离散分箱数 | 2–12 | 4 | 小样本 3 箱;样本多且变量少可 5–6 箱 |
| 单节点最大父节点数 | 1–6 | 3 | 控制 CPT 复杂度;常规 2–3 |
| 结构搜索最大迭代 | 1–500 | 80 | 变量越多可提高;搜索提前收敛时不会用满 |
| 最小改进阈值 | 0–10 | 0.01 | 越高越保守;小样本建议 0.02–0.05 |
| 稳定边阈值 | 0.1–1.0 | 0.60 | 两端节点都有效的尺度中方向边复现比例;至少 2 个尺度 |
| 并行任务数 | 正整数或 -1 | -1 | 仅调度并行;重启默认固定 3 次,种子 42,BDeu ESS=5 |
| 复用 | 开/关 | 开 | 复用请求签名完全匹配的正式结果 |
| 从临时文件恢复 | 开/关 | 关 | 恢复参数签名匹配的已完成重启快照 |
| 固定随机重启次数 | 正整数 | 3 | 与并行调度分离,同尺度比较保持预算 |
| 基础随机种子 | 整数 | 42 | 按尺度与重启编号派生确定性种子 |
| BDeu 等效样本量 | 正有限数 | 5 | 参数先验强度;仅先验父配置必须标记 |
表 B-85 贝叶斯网络分析:[4] 结构学习参数
| 尺度数 | 自动阈值 |
|---|---|
| 1 | 不判定跨尺度稳定 |
| 2 | 0.80 |
| 3–4 | 0.67 |
| 5–6 | 0.60 |
| 7 及以上 | 0.55 |
表 B-86 贝叶斯网络分析:稳定边阈值
| 列 | 含义 |
|---|---|
| 尺度 / 尺度目录 | 该 DAG 对应的统计单元尺度 |
| 父节点 / 子节点 | 有向边 \(parent \rightarrow child\) |
| 父节点角色 / 子节点角色 | 主结构、控制、响应或其他候选 |
| BIC 增益 | 从最终 DAG 删除该边的条件 BIC 损失,非搜索历史增益 |
表 B-87 贝叶斯网络分析:[5] 网络边
| 稳定度 | 含义 |
|---|---|
| 高 | 在两端节点均有效的多个尺度重复,属于复现描述,非因果/独立验证 |
| 中 | 只在部分尺度复现,可能存在尺度机制或样本量差异 |
| 低 | 尺度特异、搜索不稳定或数据证据较弱 |
表 B-88 贝叶斯网络分析:8.1 如何解释稳定度
| 模式 | 内容 | 是否支持条件推断 |
|---|---|---|
| 单尺度概率网络 | 某尺度的 DAG、角色、CPT 与状态 | 是 |
| 跨尺度稳定网络(稳定边) | 达到阈值的重复方向边 | 否,仅结构比较 |
| 跨尺度稳定网络(全部边) | 所有跨尺度方向边及稳定度 | 否,仅结构比较 |
表 B-89 贝叶斯网络分析:9.1 图模式
| 文件 | 内容 |
|---|---|
| bn_manifest.json | 来源指纹、变量、分箱、父节点、固定重启/种子、BDeu ESS、后端版本及完成签名 |
| bn_overview.csv | 每尺度样本、节点、边、平均 Blanket、总 BIC、最佳重启 |
| bn_edges.csv | 所有尺度的有向边与 BIC 增益 |
| bn_blankets.csv | 所有尺度的 Markov Blanket |
| bn_cpt.csv | 完整父状态组合 CPT、观测计数、先验伪计数及仅先验标记 |
| bn_edge_stability.csv | 两端节点有效尺度数、方向复现率及至少 2 尺度的阈值标记 |
| bn_overview.txt | 数据与尺度概览 |
| bn_report.txt | 程序生成综合报告 |
表 B-90 贝叶斯网络分析:11.1 分析根目录
| 文件 | 内容 |
|---|---|
| bn_variable_profiles.csv | 字段角色、有效性、完整样本覆盖、剔除理由与离散化概要 |
| bn_discretization.csv | 原值分箱、同值同状态、重复边界处理及保存的标签范围 |
| bn_edges.csv | 当前尺度网络边 |
| bn_blankets.csv | 当前尺度 Blanket |
| bn_cpt.csv | 当前尺度 CPT |
| bn_quality.json | 完整样本覆盖、自由参数、CPT 稀疏/仅先验与模型检查;预测 CV/Bootstrap 未计算 |
表 B-91 贝叶斯网络分析:11.2 每尺度子目录
| 现象 | 原因与处理 |
|---|---|
| 没有可用批次 | 前置目录缺少 stage_c_quadrat_dataset.csv;先完成统计单元分析 |
| 可选变量很少 | 多尺度公共字段不足、常量列或缺失率过高 |
| 网络边过多 | 分箱过少、父节点上限/迭代过高、变量冗余;提高阈值并筛选变量 |
| 网络几乎无边 | 样本不足、阈值过高、分箱过细或变量条件依赖弱 |
| CPT 很稀疏 | 状态数与父配置组合过多;减少分箱/父节点或增加样本 |
| 不同重启结果不同 | 贪心结构搜索存在局部最优;增加重启并比较总 BIC |
| 跨尺度边方向反转 | 可能为尺度机制、样本变化、等价 DAG 或搜索不稳定;逐尺度检查 |
| 证据后验无变化 | 目标与证据不在有效依赖路径、CPT 条件信息弱或状态常见 |
| 推断拒绝证据或概率模型 | 非法状态、无正概率支持或 CPT 不一致时明确错误,不返回均匀分布 |
| AI 声称因果 | 将措辞改为条件依赖/统计方向,并用外部理论或设计验证 |
表 B-92 贝叶斯网络分析:[13] 常见问题与解释边界
V3.5.0 补充质量文件:bn_quality.json 记录完整样本、自由参数、CPT 稀疏/仅先验状态和模型检查。check_model 是概率一致性检查;预测交叉验证与 Bootstrap 未计算,不能以其通过称网络预测稳健。默认重启 3 次、种子 42、BDeu ESS=5,参数与后端身份写入 manifest。
附录 C 方法—实现—界面—输出可追踪关系
C.1 核心技术追踪矩阵
本附录把城市蓝绿空间课题所需的方法、当前工程实现、交互入口和成果文件一一对应。该矩阵说明动态土地覆盖生产、生态系统服务响应组织、双尺度结构分析和多目标机制方法如何落实为软件行为,并为公式、参数、界面和输出的交叉核验提供统一索引。
| 方法链 | 理论/算法 | 核心实现 | 界面入口 | 代表输出 |
|---|---|---|---|---|
| 空间对齐 | 公共范围、目标网格、重采样、有效掩膜 | spatial_structure_analysis/* 对齐/数据集模块 | 数据与对齐页 | aligned_modeling_dataset.npz、positions、schema、manifest |
| 地图回显 | CRS 转换、GeoJSON、栅格渲染 | tab_map.py / DataLoader | 地图工作台 | 图层注册与显示图层 |
| 数据管理 | 元数据扫描与索引 | 数据管理模块 / tab_dm.py | GIS 数据库管理 | SQLite 元数据索引 |
| 分割特征 | 波段、指数、标准化、PCA | map/seg_sampling/seg_feature_* | B 特征 | 特征栈与参数 |
| 对象分割 | SLIC/SLICO、Felzenszwalb、Quickshift、Watershed、MeanShift | map/seg_sampling/segmentation_* | C 分割 | segment_id、segments.geojson |
| 对象采样 | segment_id 映射、选择、类别与保存 | map/seg_sampling/*sampling* | E 采样 | samples_live.geojson、samples.geojson |
| LC 空间增强 | 30 m 多光谱与 15 m 全色 Brovey 融合、公共范围 | modeltrain/landsat2LC/data_preparation.py | 数据准备/全色融合页 | 15 m 融合多光谱 GeoTIFF 与波段语义 |
| LC 光谱 | NDVI/EVI/SAVI/MNDWI/NDBI 等 | modeltrain/landsat2LC/featureCal/spectral.py | 光谱特征页 | 光谱特征栅格 |
| LC 地形/纹理/时序 | DEM 派生、GLCM/GLRLM/LBP、窗口统计、时序统计 | featureCal/terrain.py、glcm.py、spatial.py、temporal*.py | 地形/纹理/时序/空间页 | 多域与多景特征栈 |
| 训练集与类别 | 像元/多边形样本、class_column、动态标签编码、过滤与划分 | generate_training_data.py、data_generator_panel.py | 训练集生成页 | 训练数组、classes、标签编码器与 schema |
| 传统分类 | RF、GBDT、XGBoost 等 | landsat2LC/train 与模型模块 | 传统模型训练页 | 模型、classification_report、confusion_matrix |
| ResNet | 残差网络训练与块式推理 | landsat2LC/resnet* | ResNet 配置/预测页 | 权重、日志、分类 GeoTIFF |
| 模型融合 | 按类别名称重映射、多数/加权/概率/按类优选 | landsat2LC/fusion_selector_module.py | 融合页 | 统一类别顺序的融合分类 GeoTIFF 与评价 |
| LST | ST_B10 缩放、QA_PIXEL、有效范围 | LST_landsat_processor.py | LST 生产页 | LST GeoTIFF 与 QC tags |
| ETa | 场景冷热端、ETf、ETo 与 ETa 估算 | landsat2eta_processor.py | ETa 估算生产页 | ETa 估算 GeoTIFF 与 Tc/Th/ETo tags |
| 统计单元尺度 | b(s) 聚合、结构/响应支持域同步变化 | statistical_unit_scale.py | 统计单元尺度页 | 高效益单元尺度特征、关系表、诊断表 |
| 邻域作用尺度 | 奇数窗口、中心响应支持域固定 | statistical_unit_scale.py 的 neighborhood_effect_scale 模式 | 邻域作用尺度页 | 作用范围窗口特征、关系表、诊断表 |
| 控制/多目标 | 偏相关、ΔR²、Synergy、Trade-off、CCD、Pareto | control_target_unit_scale.py | 控制变量/多目标页 | 净效应、局部指标、曲线与 GeoTIFF |
| 贝叶斯网络 | 离散化、BIC、CPT、稳定性、变量消元 | bayesian_network_analysis.py | 贝叶斯网络页 | 边、CPT、稳定性、推断与网络图 |
表 C-1 方法—代码—界面—输出追踪矩阵
C.2 关键公式核验矩阵
| 对象 | 报告公式/规则 | 实现语义 | 核验依据 |
|---|---|---|---|
| LST | K=DN×0.00341802+149.0;℃=K−273.15 | 直接对 ST_B10 缩放;230—360 K 有效范围 | LST_landsat_processor.py;USGS C2 L2 指南 |
| QA_PIXEL | 位 0—5 联合无效 | Fill、膨胀云、卷云、云、云影、雪 | 处理器位运算;USGS QA Bands |
| ETa | ETf=(Th−Ts)/(Th−Tc),截断至 [0,1];ETa=ETf×ETo;结果为场景相对估算,绝对量需独立验证 | 冷/热候选的 5/95 百分位端元 | landsat2eta_processor.py |
| 统计尺度 | round(s/r₀) 或 ceil(s/r₀−10⁻⁹) | 离散整数倍与连续尺度映射分开 | scale_axis_analysis.md;统计尺度实现 |
| GeoDetector | q=1−ΣNhσh²/(Nσ²) | 分层内方差相对总体方差 | 关系方法实现与应用文档 |
| 尺度平滑 | 0.25zk−1+0.50zk+0.25zk+1 | 用于平滑峰值诊断 | 尺度诊断实现与应用文档 |
| CCD | \[D_{i}{= C}_{i}^{\alpha}T_{i}^{1 - \alpha}\] | 固定参考满意度;T 为算术均值,C 为几何/算术均值比;α=0.5,零均值时 C=0 | control_target_unit_scale.py |
| BIC | ℓ−0.5k ln n,较大者优 | 本实现采用最大化记号 | bayesian_network_analysis.md 与实现 |
| 边稳定性 | 方向边出现数/两端节点均有效尺度数;单尺度不称跨尺度稳定 | 仅以成功学习的尺度为分母 | 贝叶斯网络跨尺度实现 |
表 C-2 关键公式、实现语义与核验依据
C.3 输出证据与复现要素
| 成果类型 | 最小复现信息 | 判读用途 |
|---|---|---|
| 专题 GeoTIFF | CRS、transform、NoData、波段说明、缩放/端元/QC 标签 | 空间范围、值域、空值边缘和成果叠加 |
| 分类模型 | 特征顺序、标签编码、超参数、随机种子、训练/验证划分 | 重放训练与保持推理一致 |
| 评价文件 | 混淆矩阵、分类报告、样本量与划分方式 | 类别级与总体精度解释 |
| 尺度结果 | 尺度序列、每尺度样本数、方法参数、曲线与诊断 | 识别峰值、平台、不确定区间与断点 |
| 局部空间结果 | positions、schema、目标网格、多波段字段说明 | OOF 预测、目标水平/不均衡度、描述性协调与精确非支配成员;按实际 schema 解释 |
| 贝叶斯结果 | 离散化边界、状态、DAG、CPT、证据和推断输出 | 解释条件依赖与后验变化 |
表 C-3 成果类型、最小复现信息与判读用途
附录 D 应用界面与成果图谱
本附录保留原有应用截图,展示软件流程及成果组织。图中旧布局、旧指标字段和历史案例分数仅为界面示例;V3.5.0 的当前功能、算法与质量要求以正文及参数附录为准,不将历史截图作为新版有效计算或最佳尺度证明。
D.1 地图工具
本节按地图工具栏按钮从上到下排列现有补充截图,先展示 WhiteboxTools 地学分析工具,再展示分割采样各页。地图加载等已在正文展示的界面不在本附录重复收录。
D.1.1 WhiteboxTools
本组展示地图工具中位于分割采样之前的 WhiteboxTools 地学分析入口。
图 D-1 WhiteboxTools 地学分析工具集成界面
D.1.2 分割采样
分割采样截图依次对应 B. 特征、C. 分割和 D. 区划;同一功能页的配置、结果与方法库保持连续。
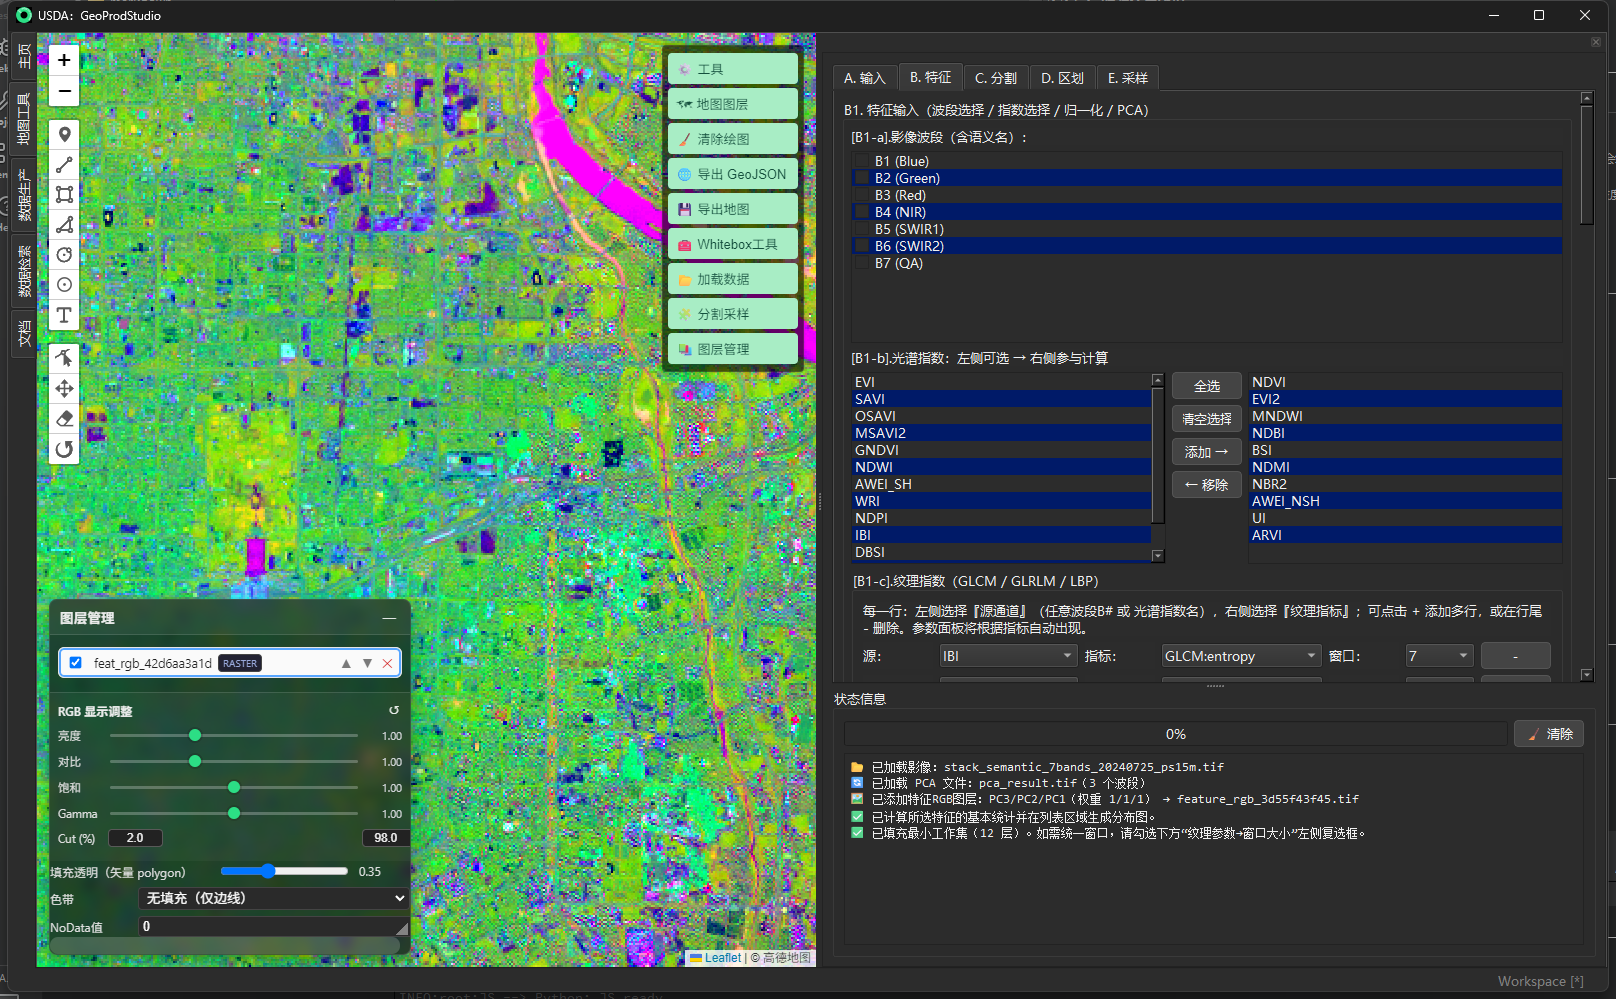
图 D-2 分割采样特征构建:波段、指数、纹理与主成分配置及地图预览
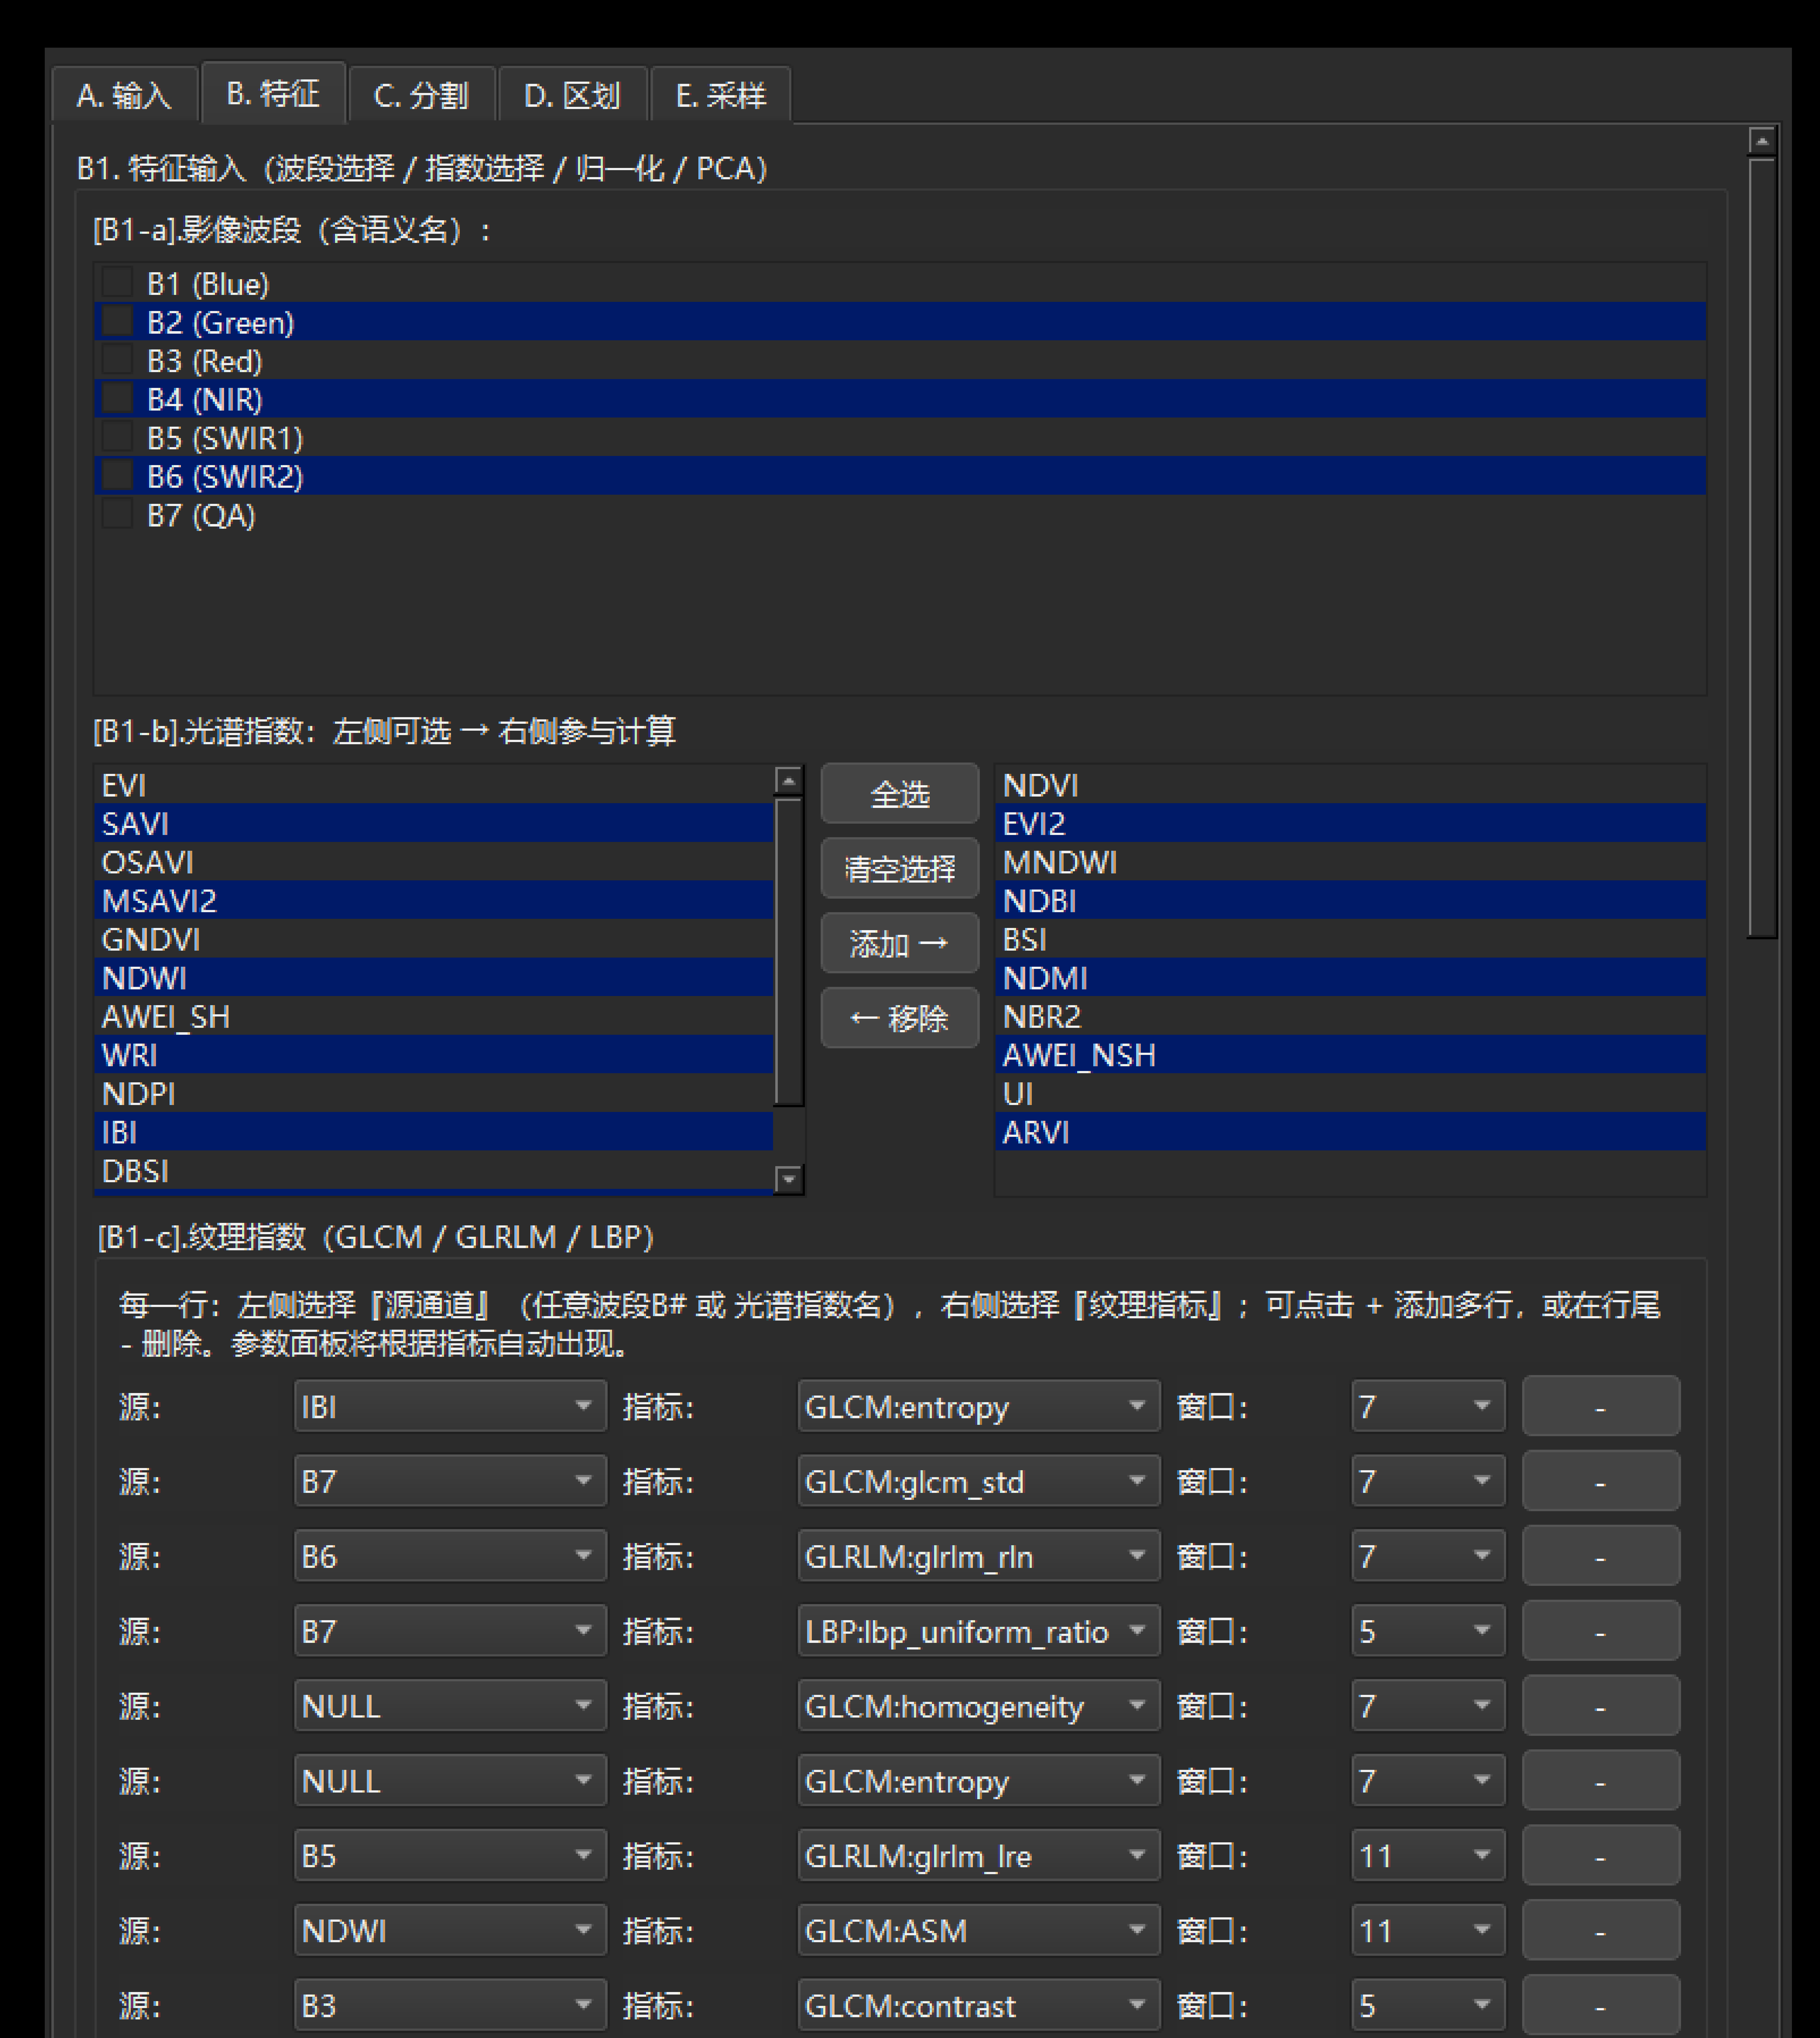
图 D-3 分割采样特征页:特征构建、预览、统计与分布诊断(第 1/3 部分)
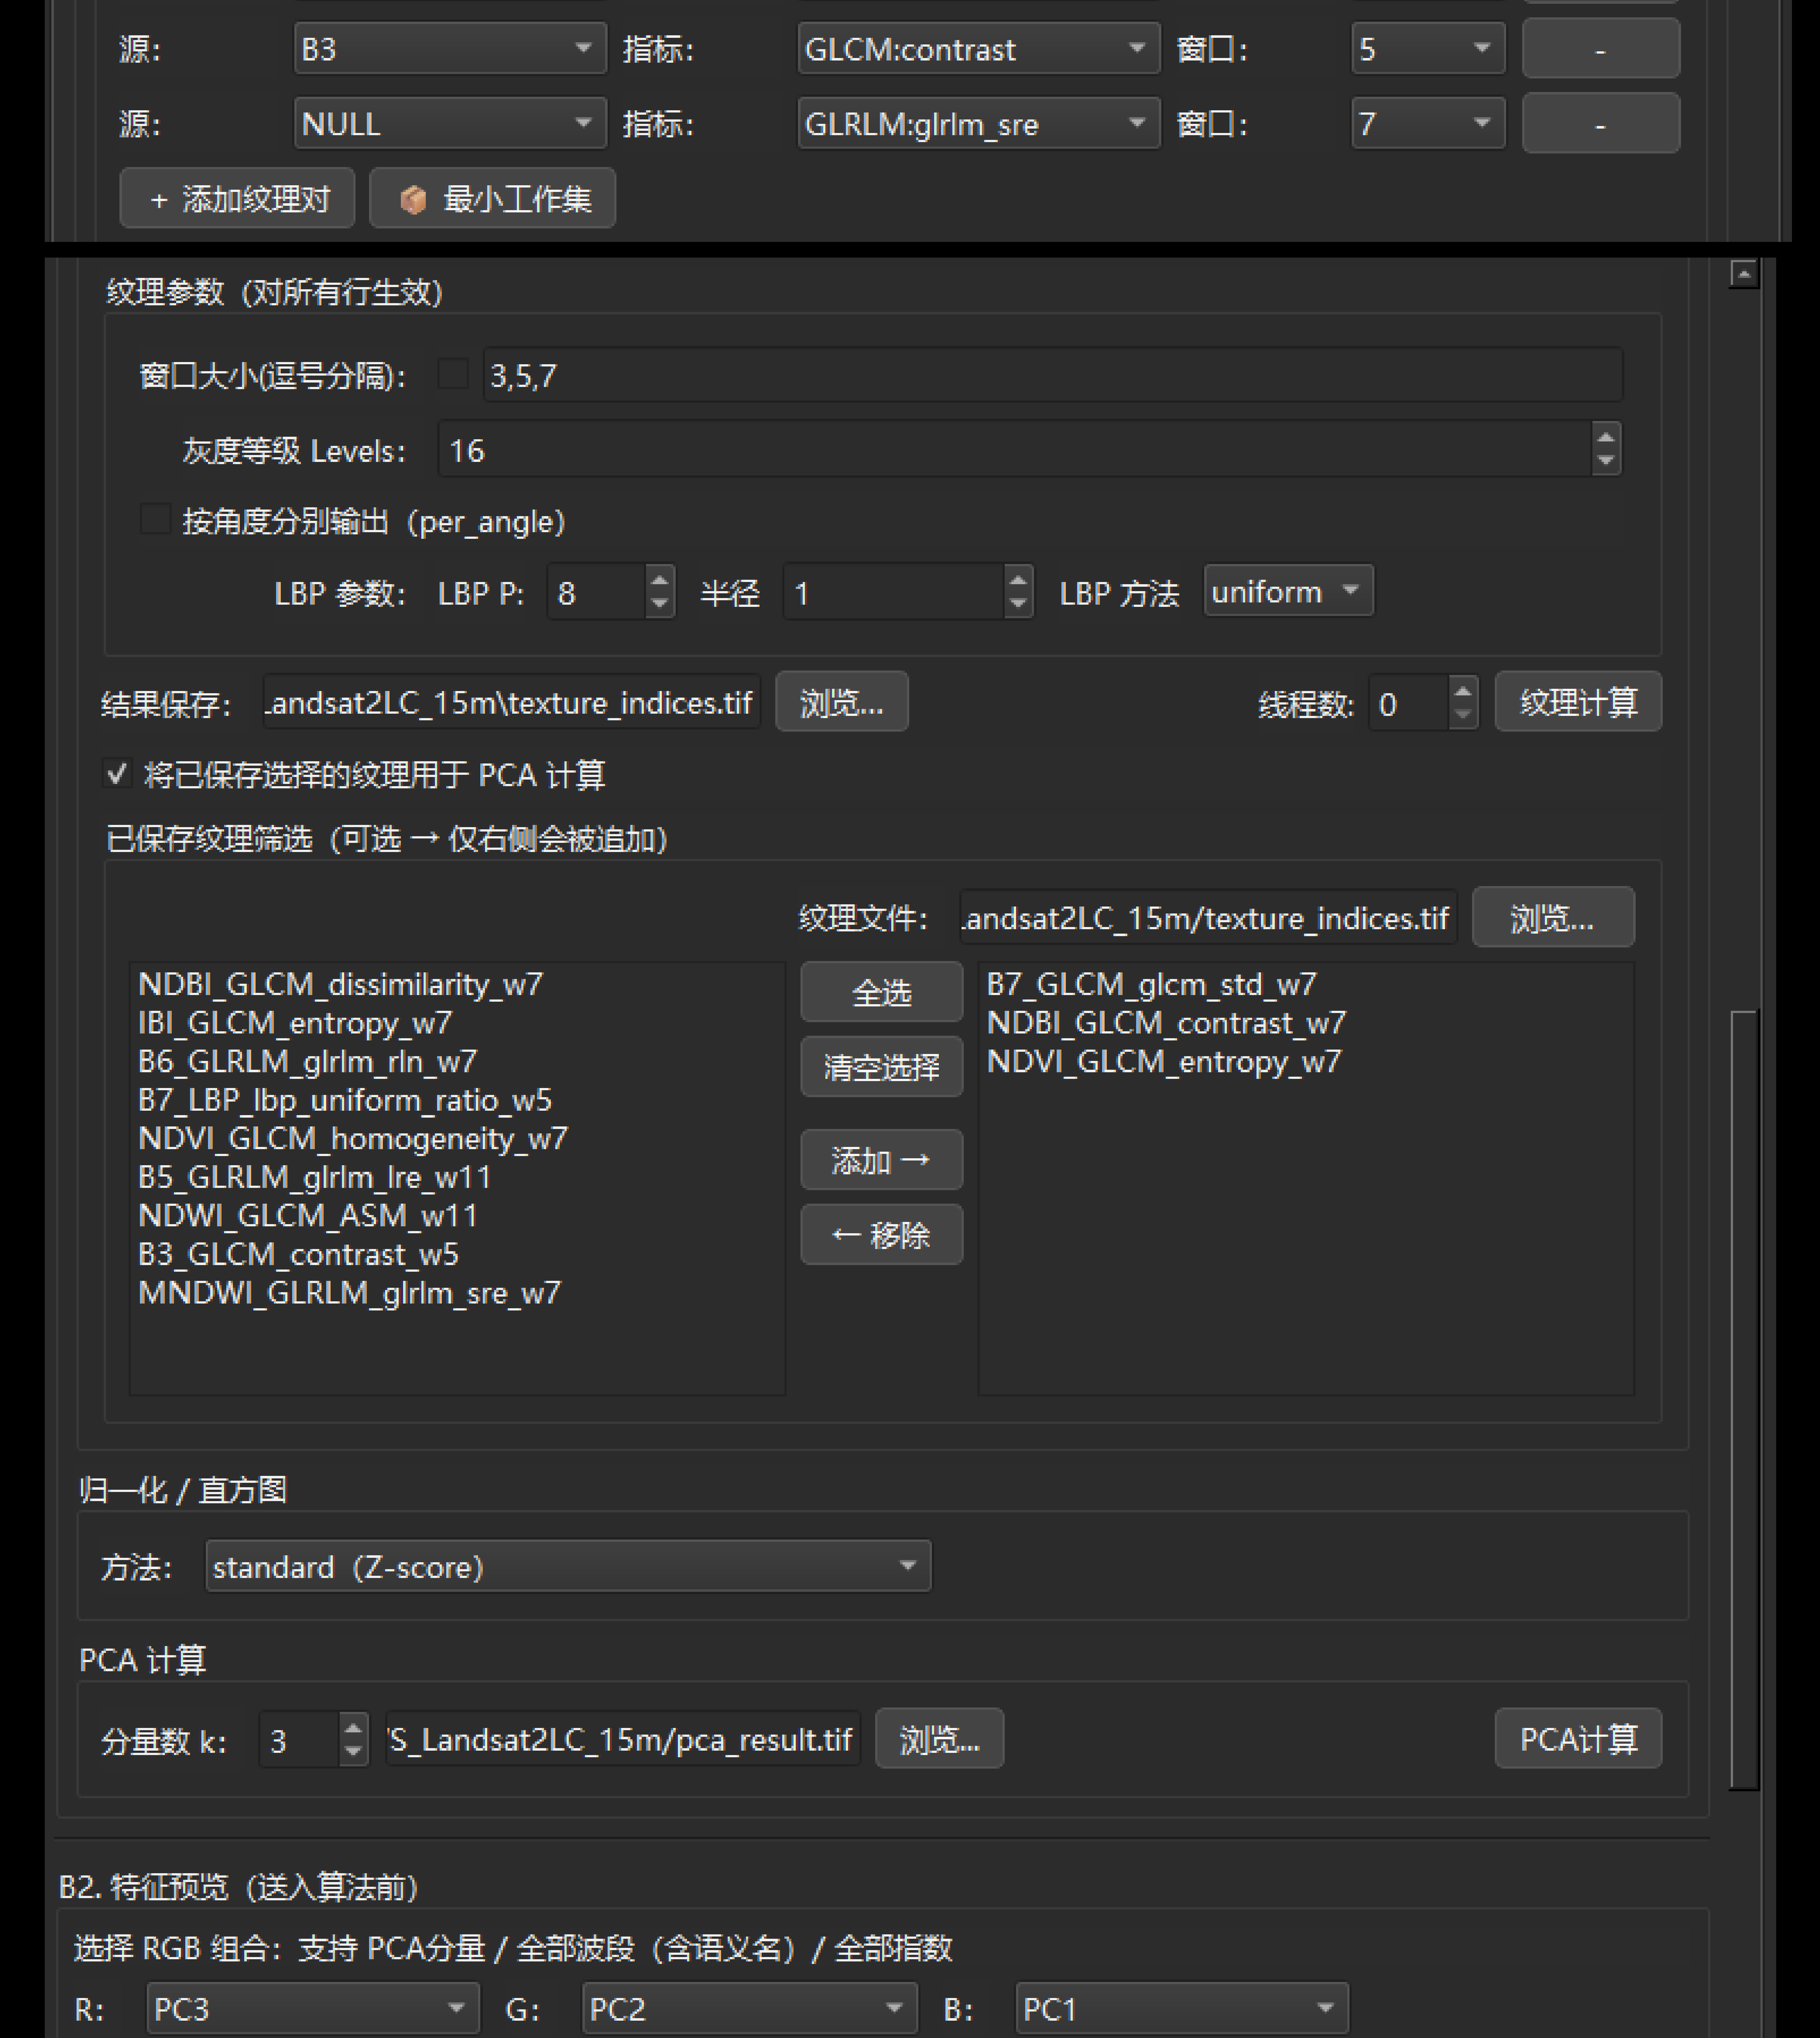
图 D-3 分割采样特征页:特征构建、预览、统计与分布诊断(第 2/3 部分)
图 D-3 分割采样特征页:特征构建、预览、统计与分布诊断(第 3/3 部分)
图 D-4 分割采样:可选影像分割算法及计算后端
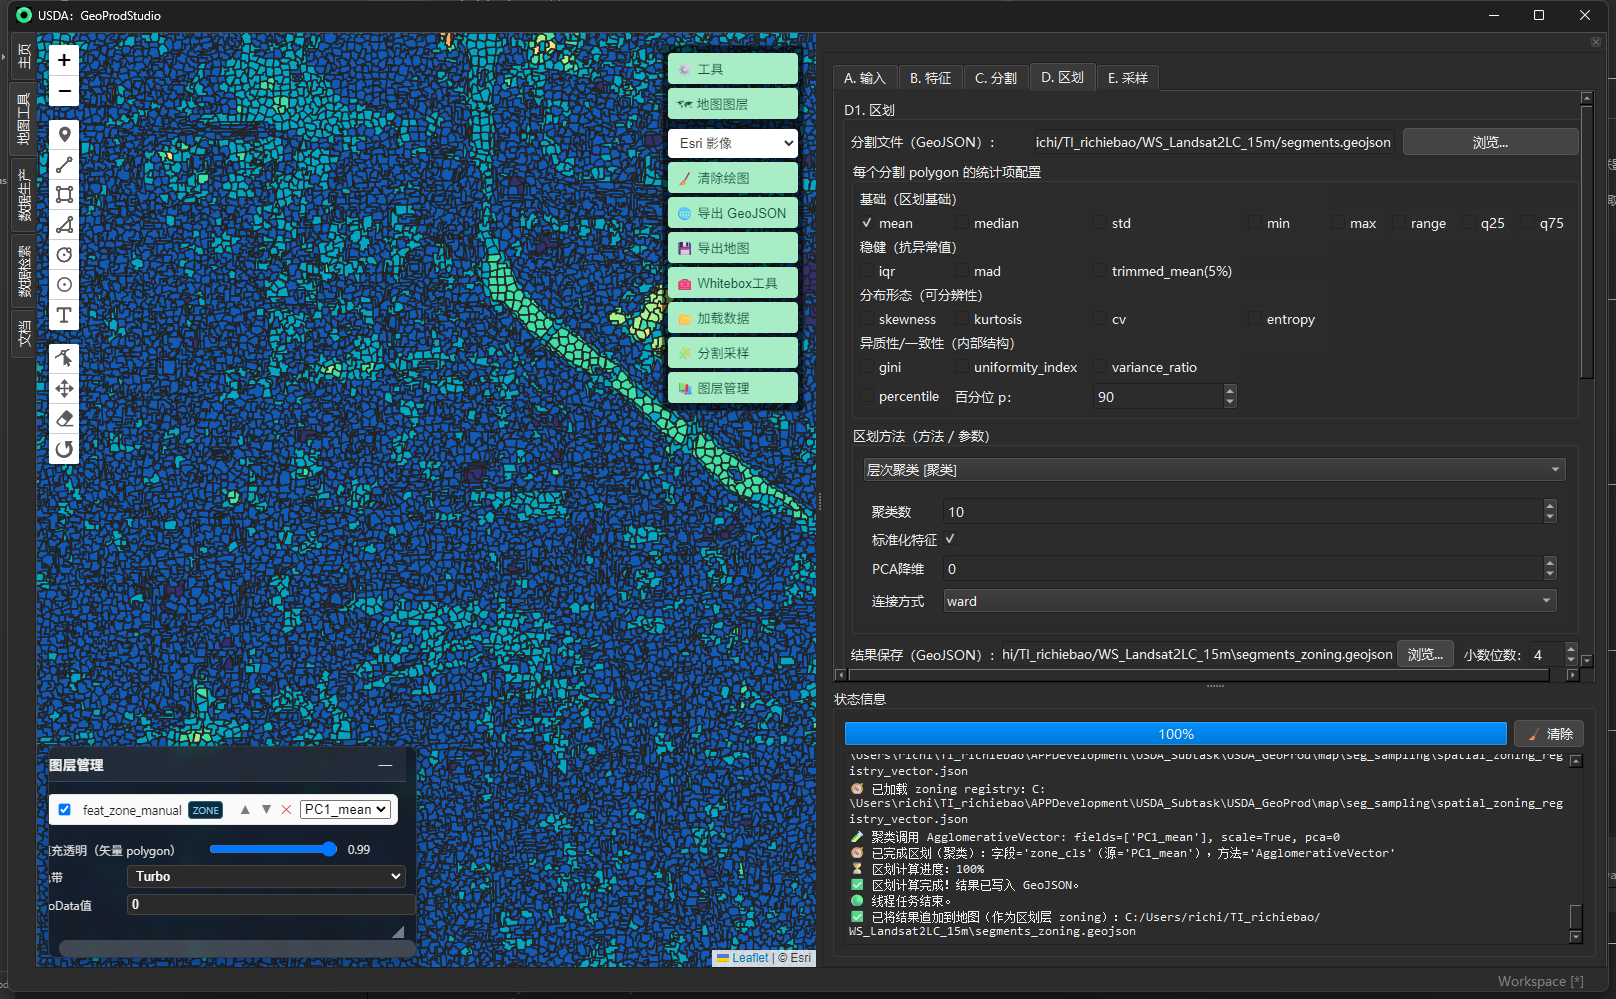
图 D-5 分割对象空间区划:统计特征、区划参数与结果回显
图 D-6 分割对象空间区划:区划计算与可编程判别规则配置
图 D-7 空间区划方法库:地图分类、空间自相关与聚类方法
D.2 数据生产
本节按数据生产左侧模块及其内部页签顺序排列,先展示 Landsat 土地覆盖产品生产,再展示 Landsat 地表温度产品生产。
D.2.1 Landsat 土地覆盖产品生产
土地覆盖截图依次对应数据准备、指数计算、样本过滤、随机森林训练与预测、ResNet50 深度模型及结果融合。指数计算内部按界面从上到下排列为地形指数、两两差分、时序统计、空间窗口统计、特征包合并及 NPZ 转 GeoTIFF。
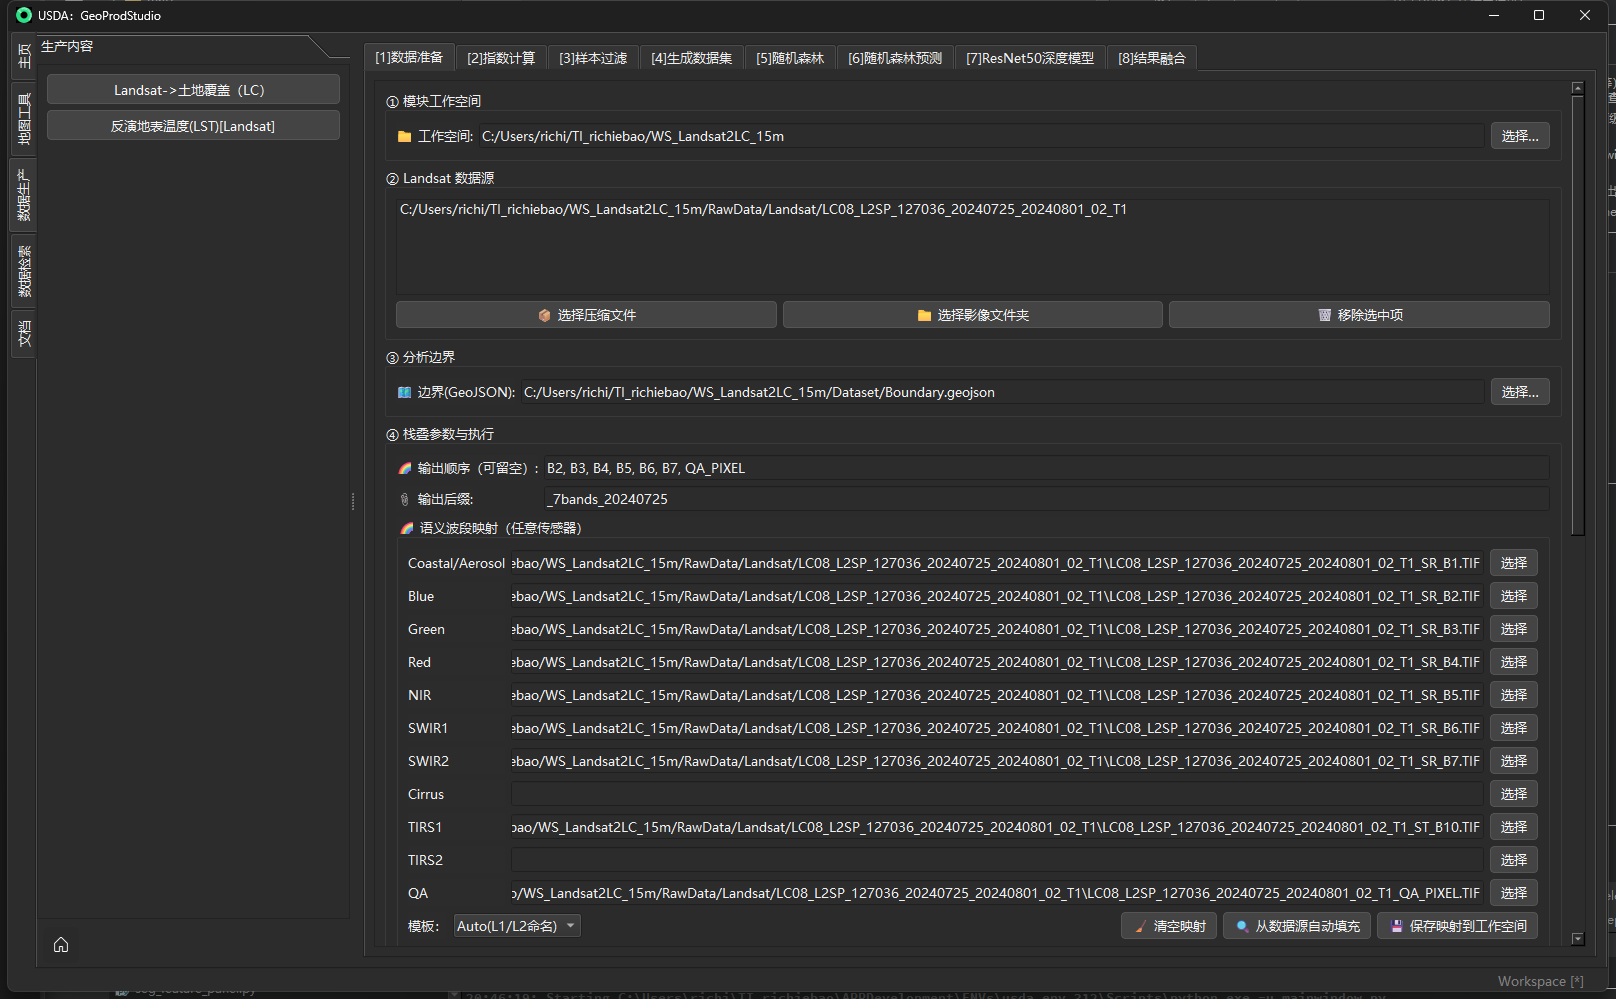
图 D-8 Landsat 8/9 土地覆盖数据准备:数据源、分析边界与波段栈叠
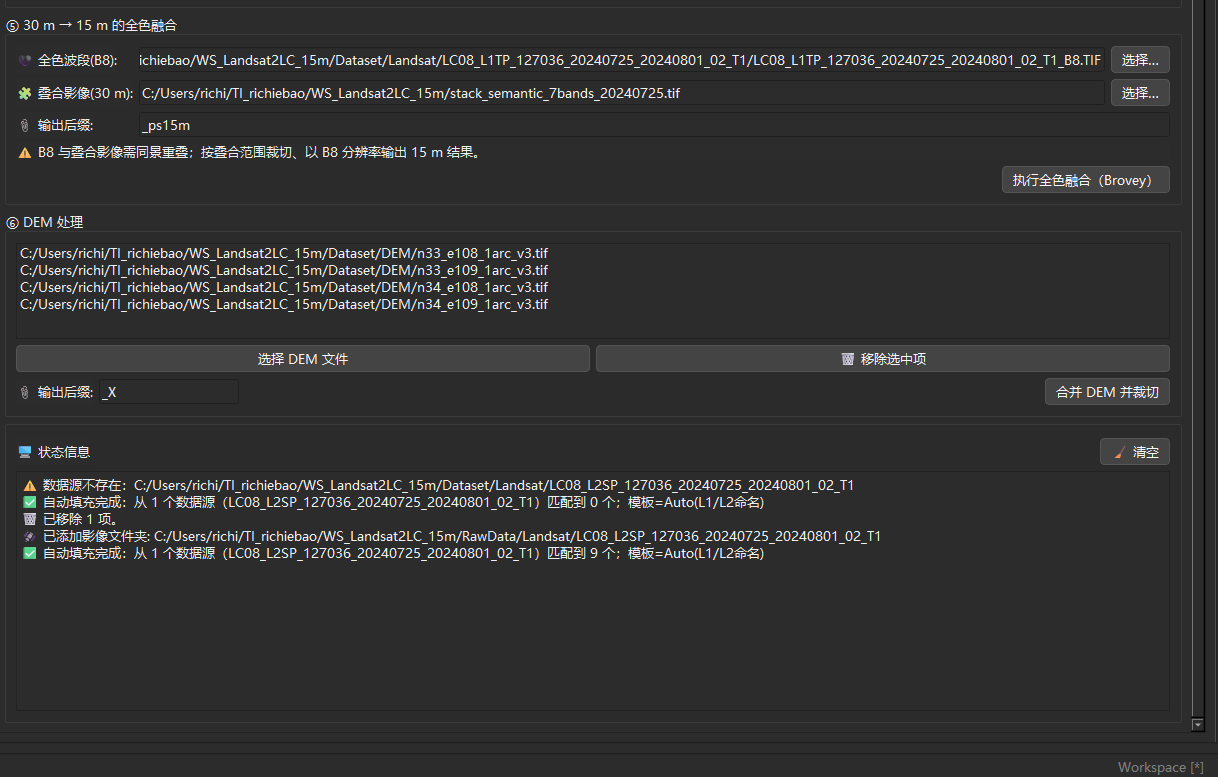
图 D-9 Landsat 8/9 土地覆盖数据准备:15 m 全色融合与数字高程模型处理
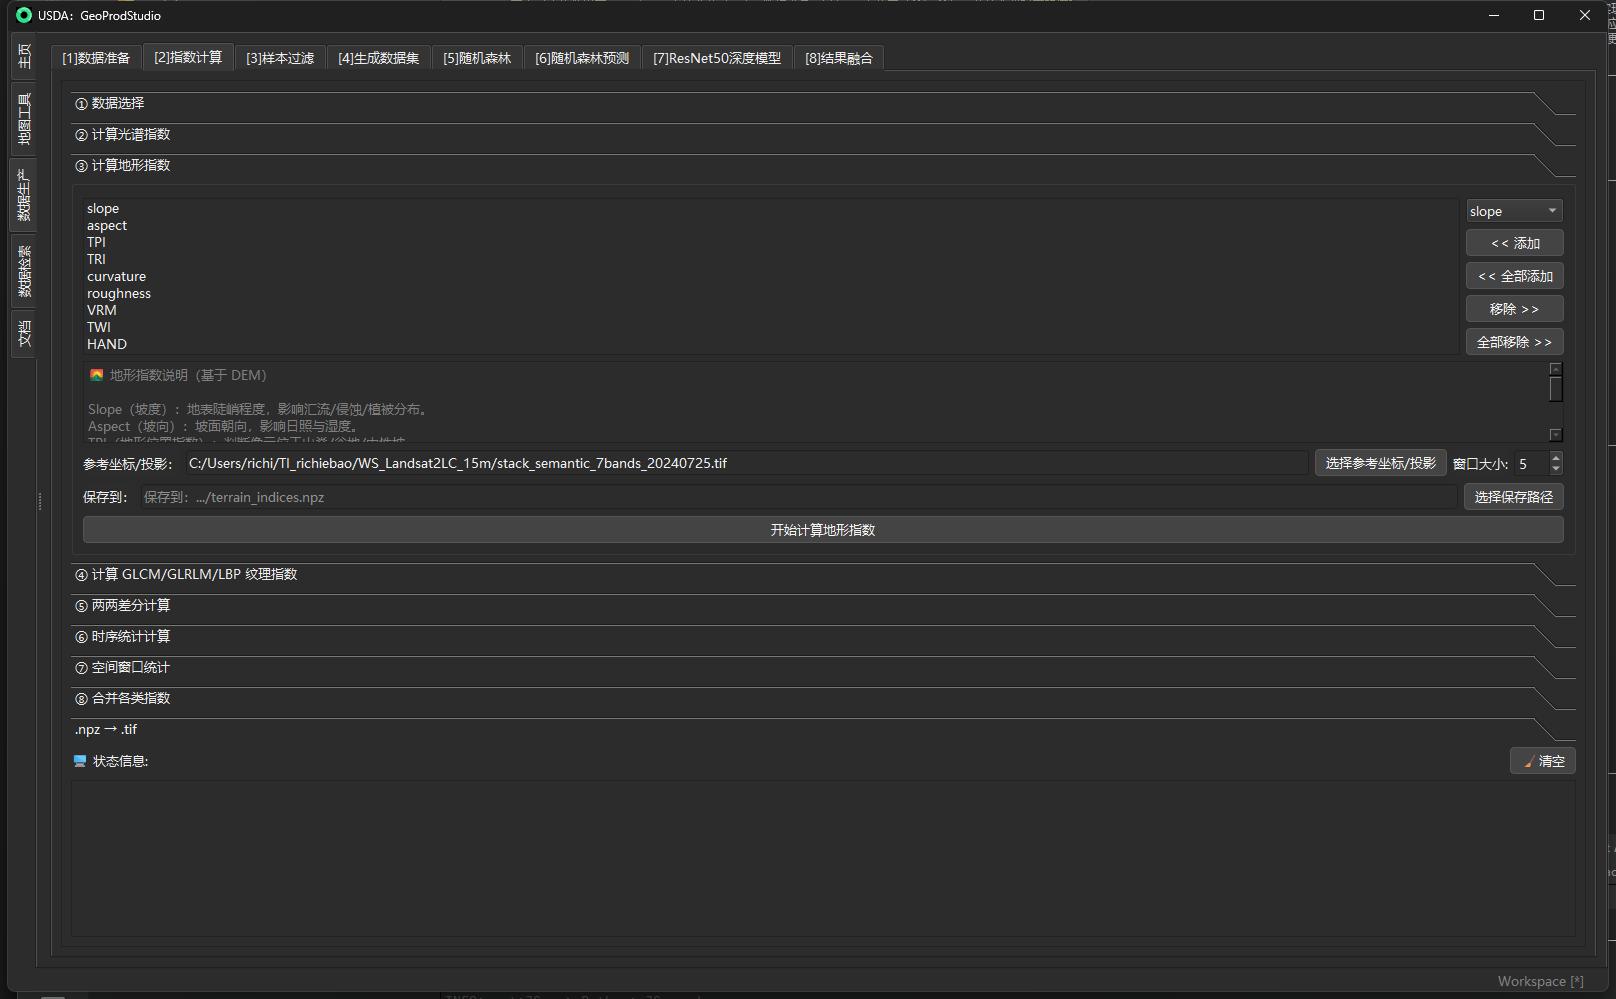
图 D-10 土地覆盖特征工程:基于数字高程模型的地形指数计算
图 D-11 土地覆盖特征工程:多时相特征两两差分计算
图 D-12 土地覆盖特征工程:多时相指数时序统计
图 D-13 土地覆盖特征工程:单期指数空间窗口统计
图 D-14 土地覆盖特征工程:多类指数特征包合并与空间对齐
图 D-15 土地覆盖特征工程:NumPy 压缩数组(NPZ)转多波段地理标记图像(GeoTIFF)
图 D-16 土地覆盖样本质量与稳定性过滤配置
图 D-17 随机森林土地覆盖模型:矢量对象级训练配置与运行状态
图 D-18 随机森林土地覆盖模型:像元级预测配置
图 D-19 随机森林土地覆盖模型:矢量对象级预测配置
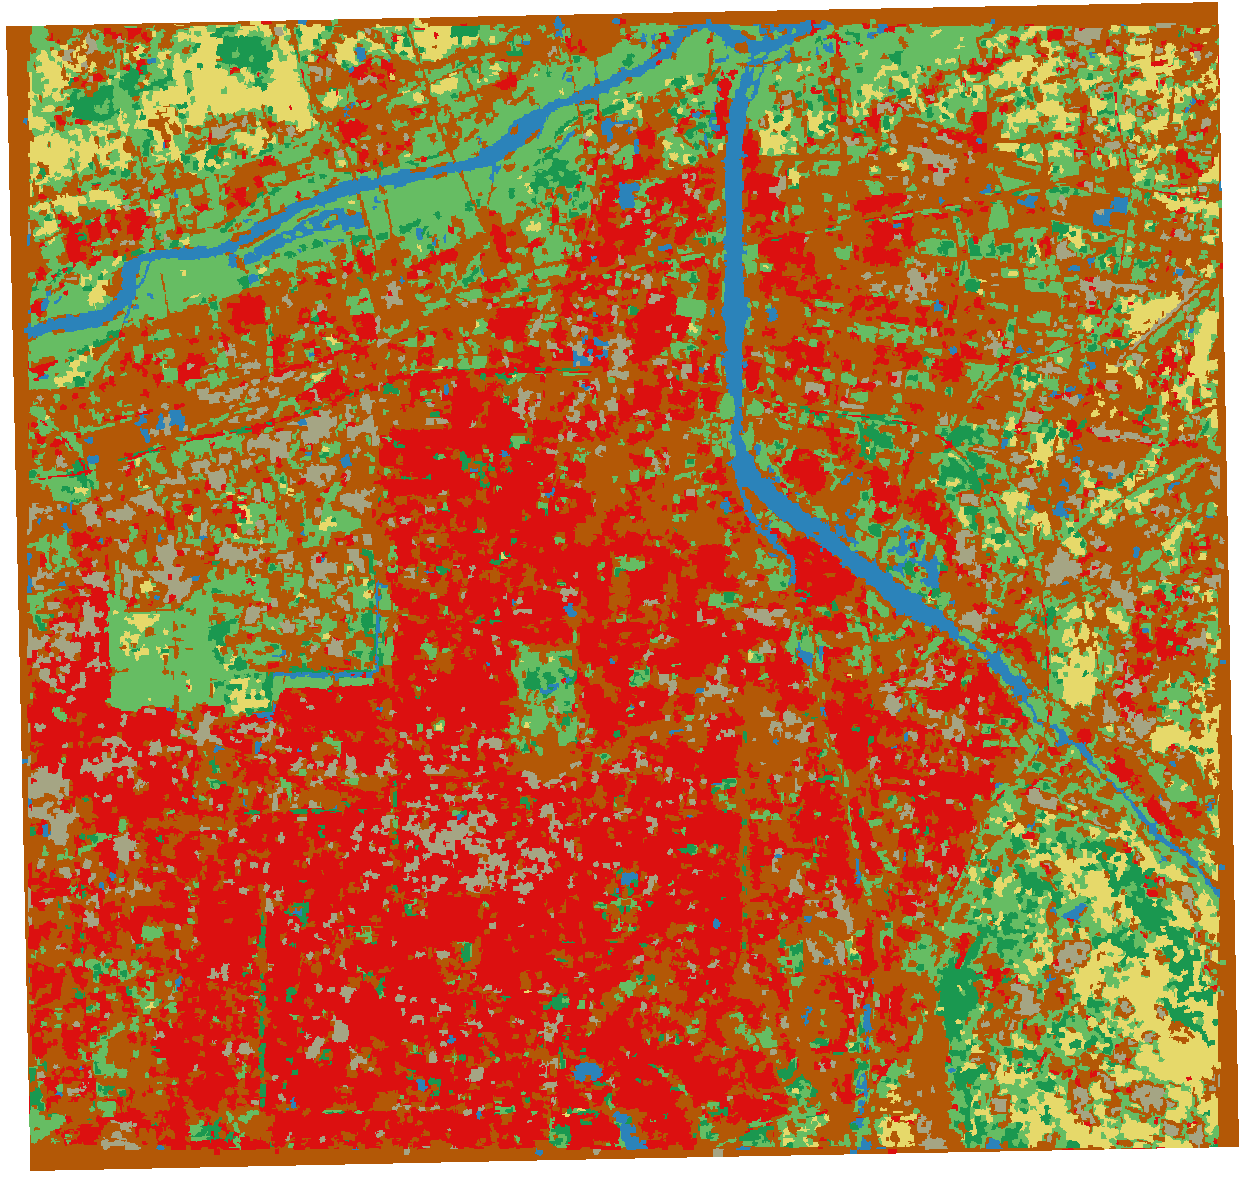
图 D-20 随机森林土地覆盖模型:矢量对象级预测结果
图 D-21 ResNet50 土地覆盖模型:训练数据与类别选择
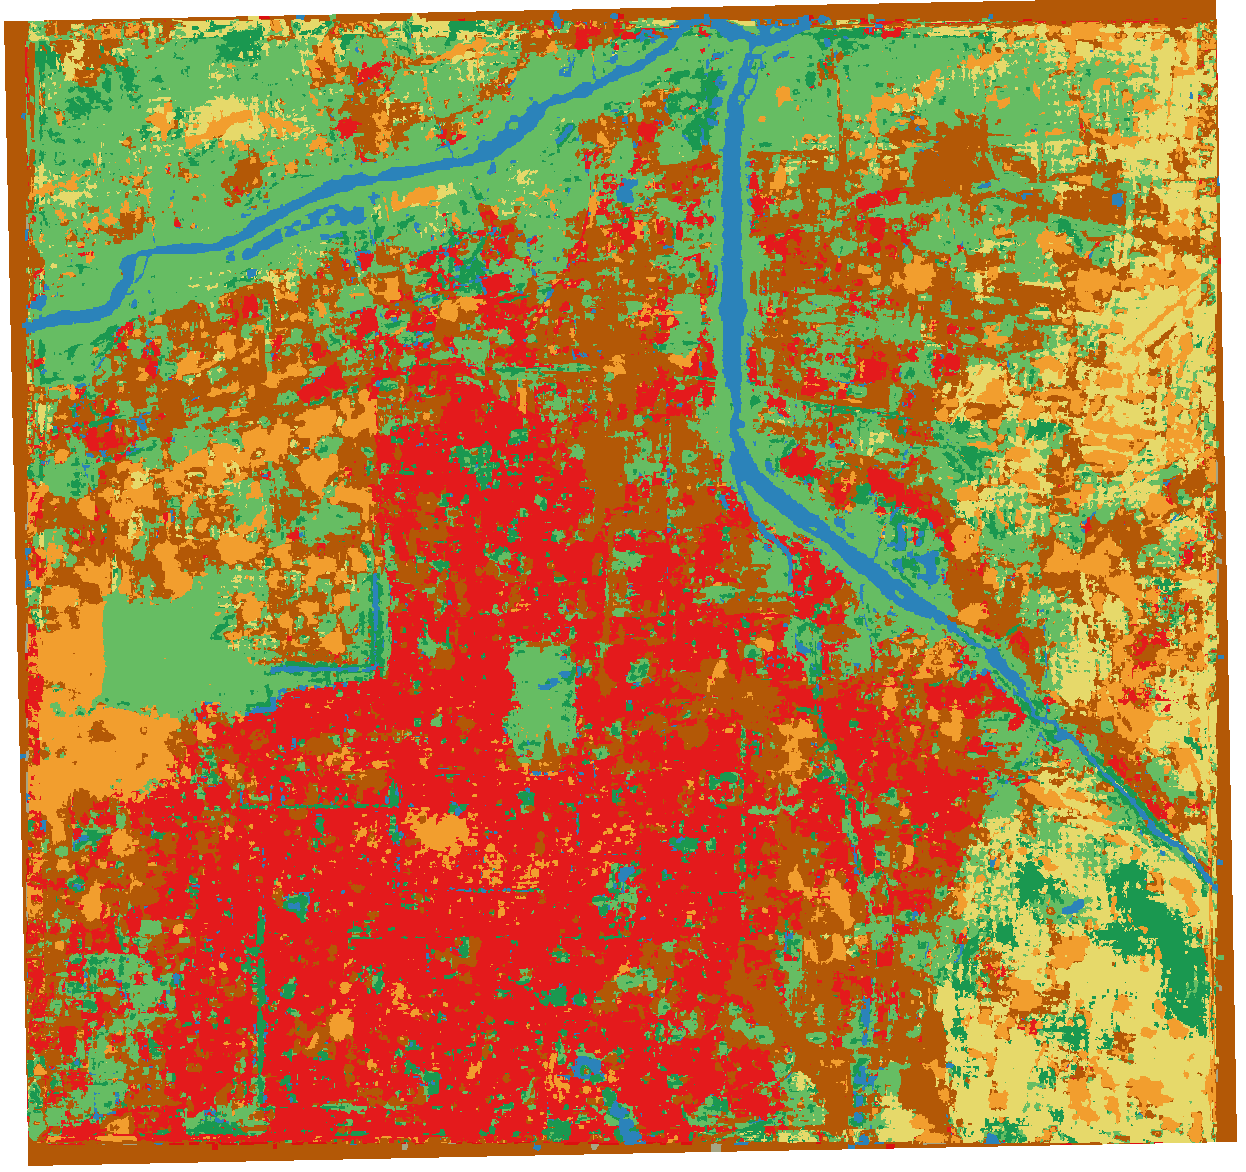
图 D-22 ResNet50 土地覆盖模型:全类别预测结果
图 D-23 ResNet50 土地覆盖模型:选定类别预测结果
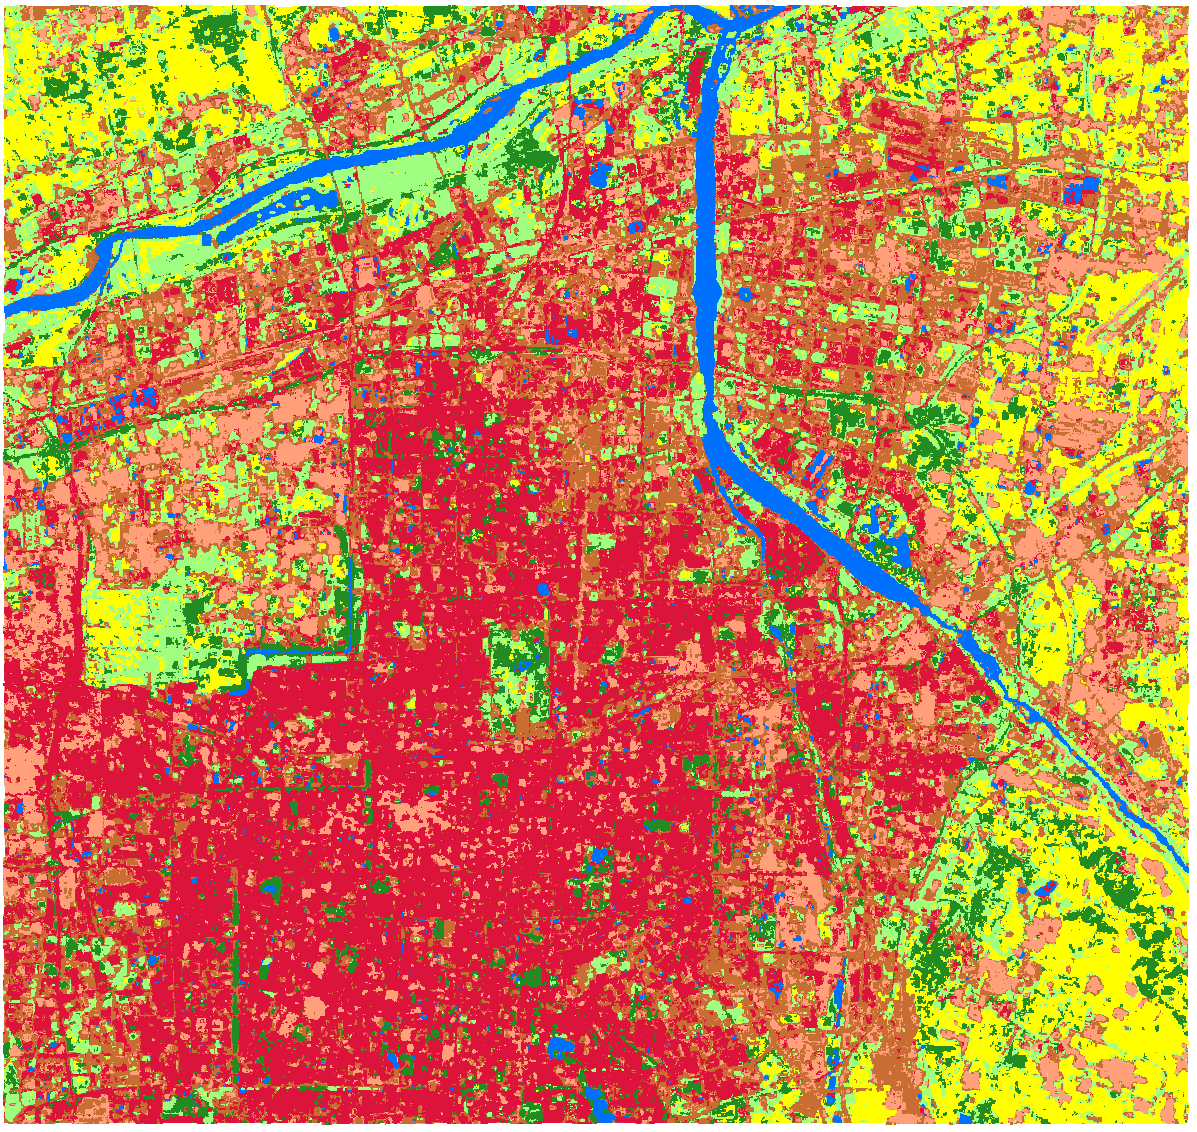
图 D-24 土地覆盖模型融合策略 A:主模型与 ResNet50 交集细化结果
D.2.2 Landsat 地表温度产品生产
本组展示 Landsat 8/9 地表温度反演的输入、质量控制和运行结果。
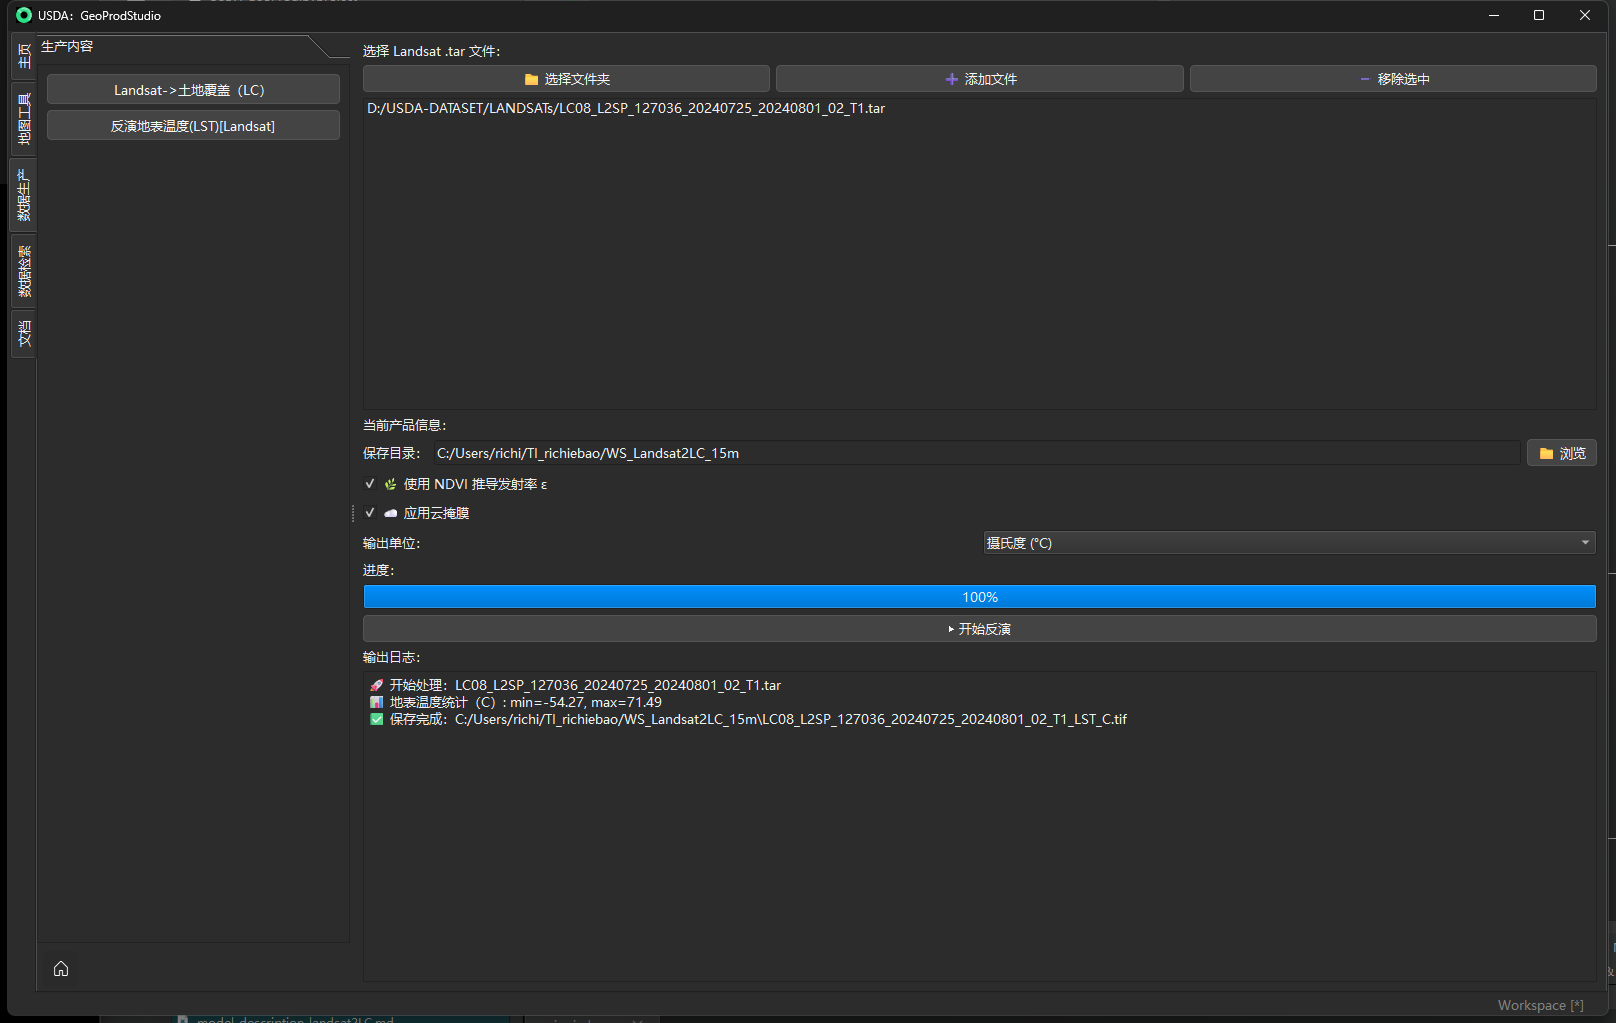
图 D-25 Landsat 8/9 地表温度反演:数据选择、质量控制与运行结果
D.3 空间结构关系分析
本节严格按空间结构关系分析左侧模块及顶部页签顺序排列:结构/响应特征尺度轴、控制变量/多目标分析、贝叶斯网络分析;每个尺度页内部再按右侧结果页签从左到右排列。
D.3.1 结构/响应特征尺度轴—统计单元尺度
先展示统计单元尺度完整配置,再依次展示固定尺度批处理、综合报告、结果导出及导出成果示例;连续尺度曲线和尺度诊断已在正文展示,故本附录不重复收录。
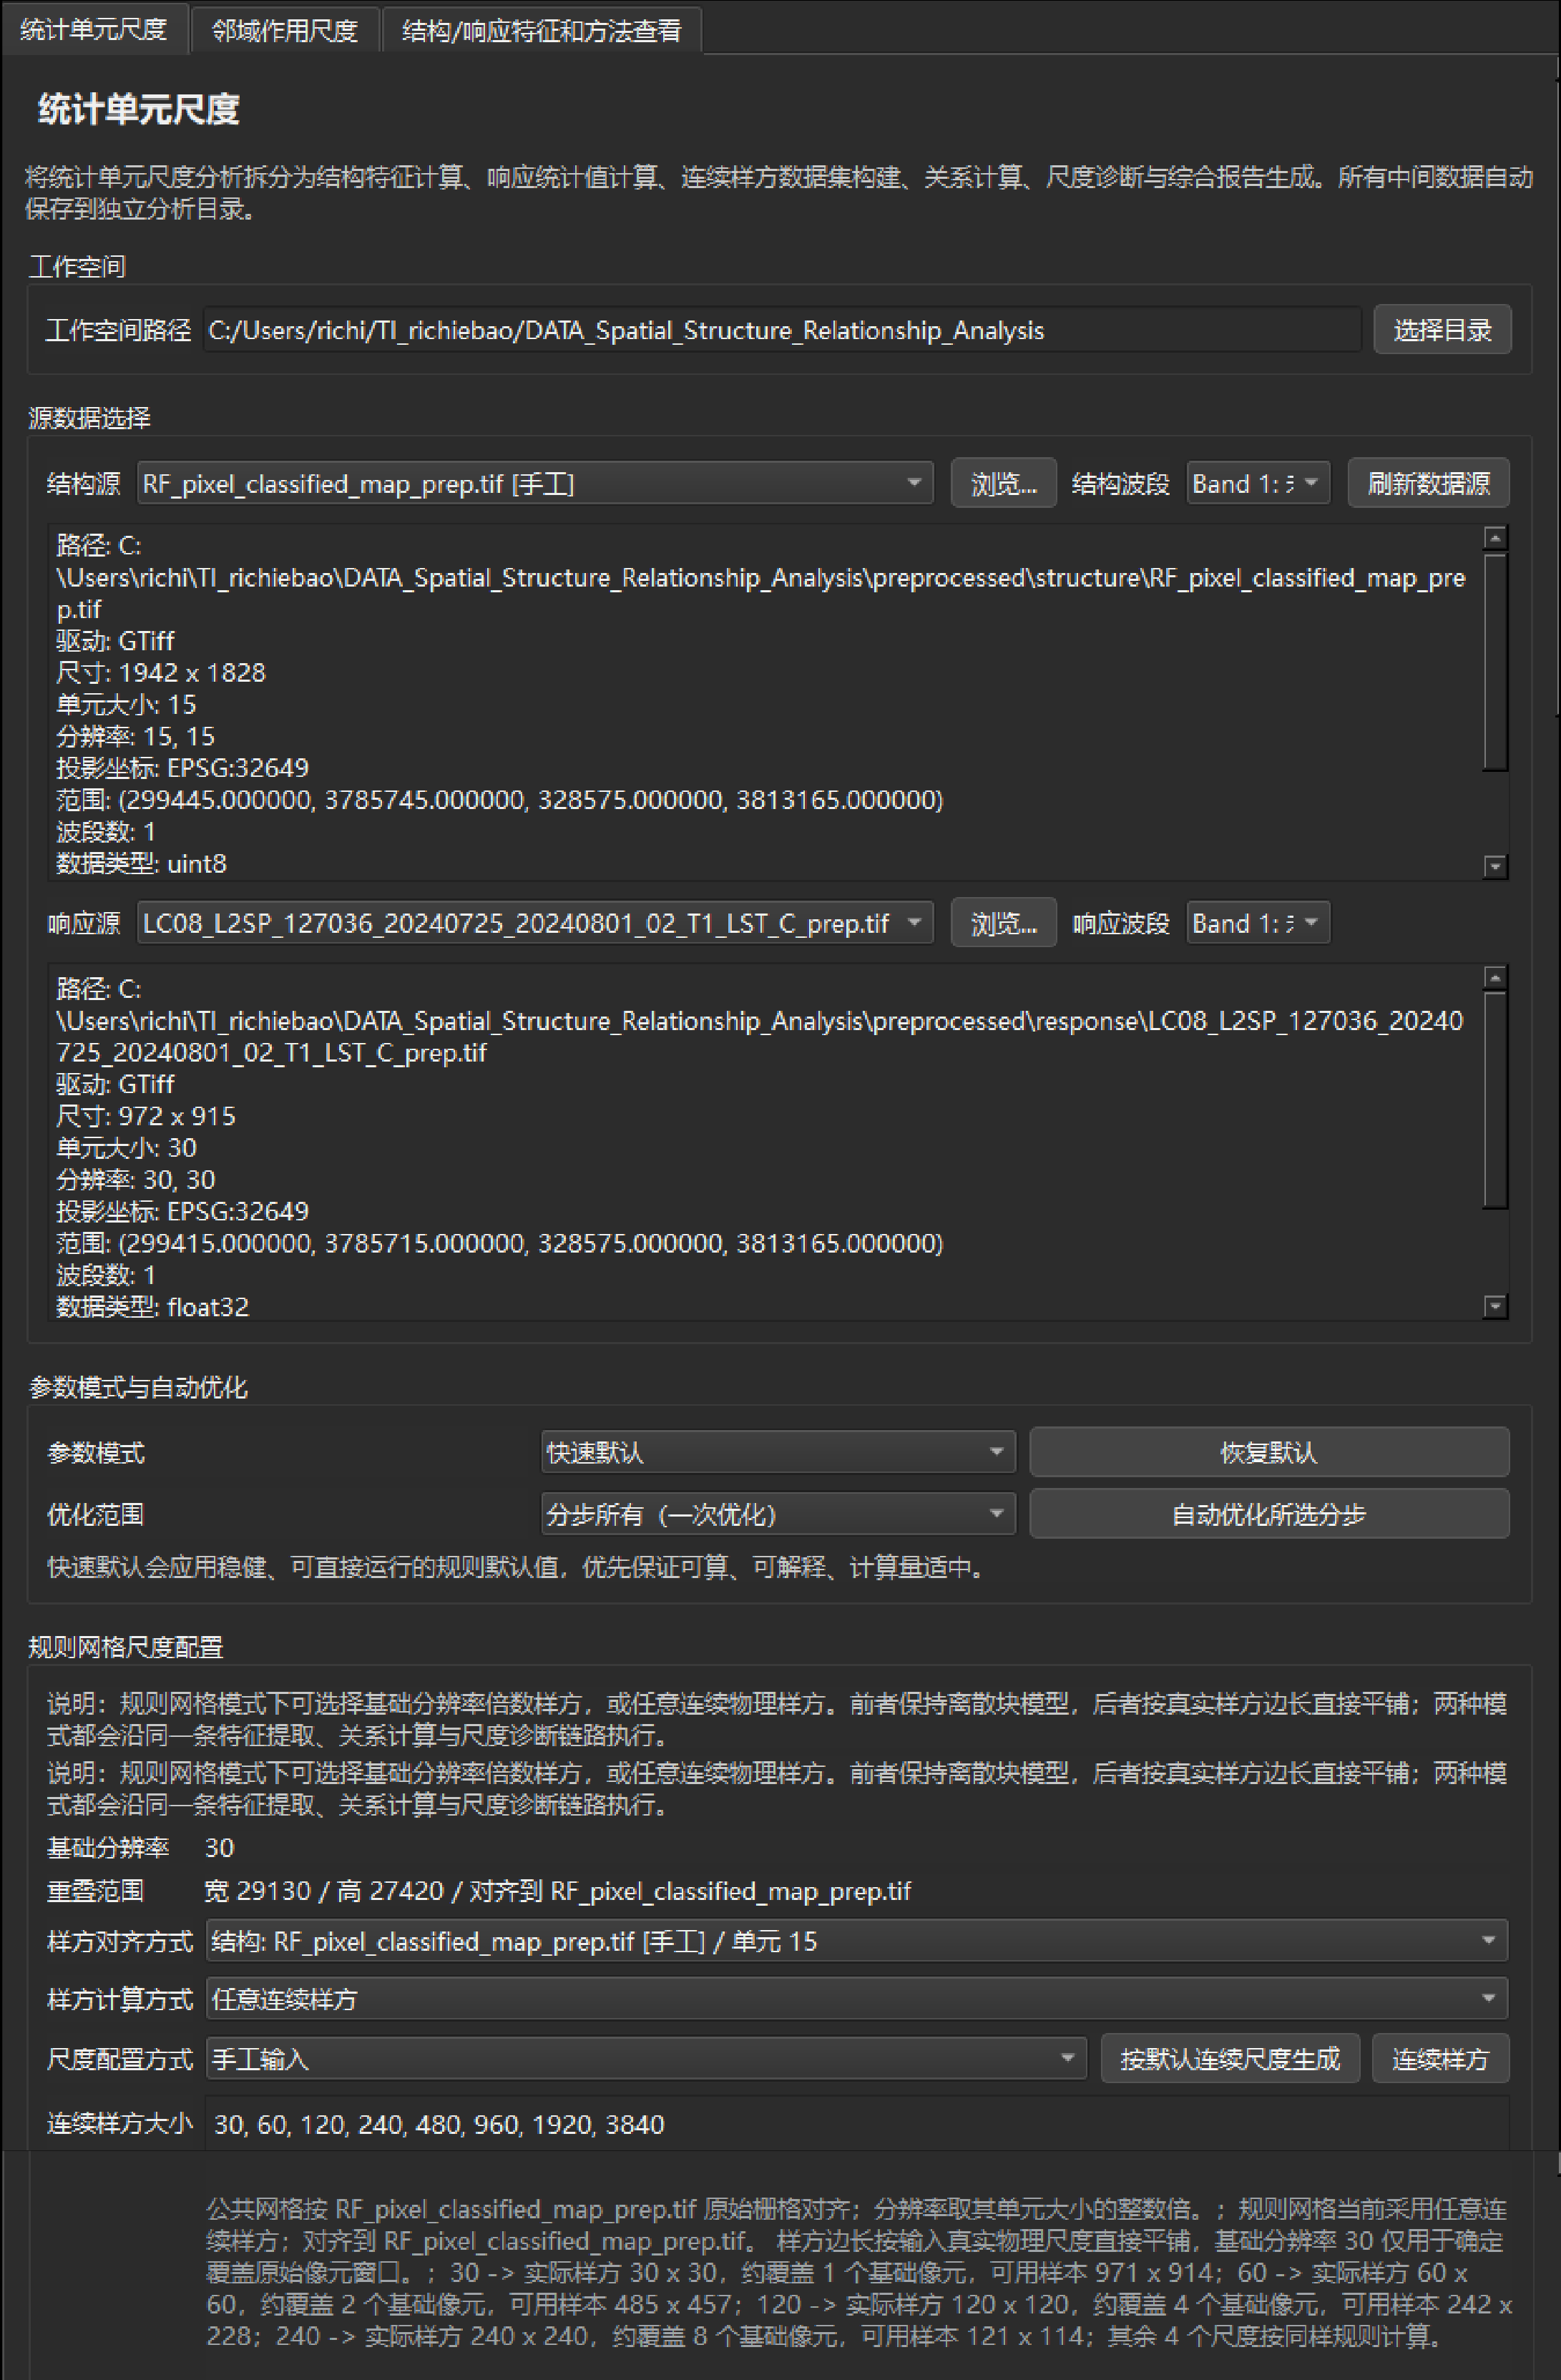
图 D-26 统计单元尺度完整配置:数据源、规则网格、结构与响应特征、关系及尺度方法(第 1/3 部分)
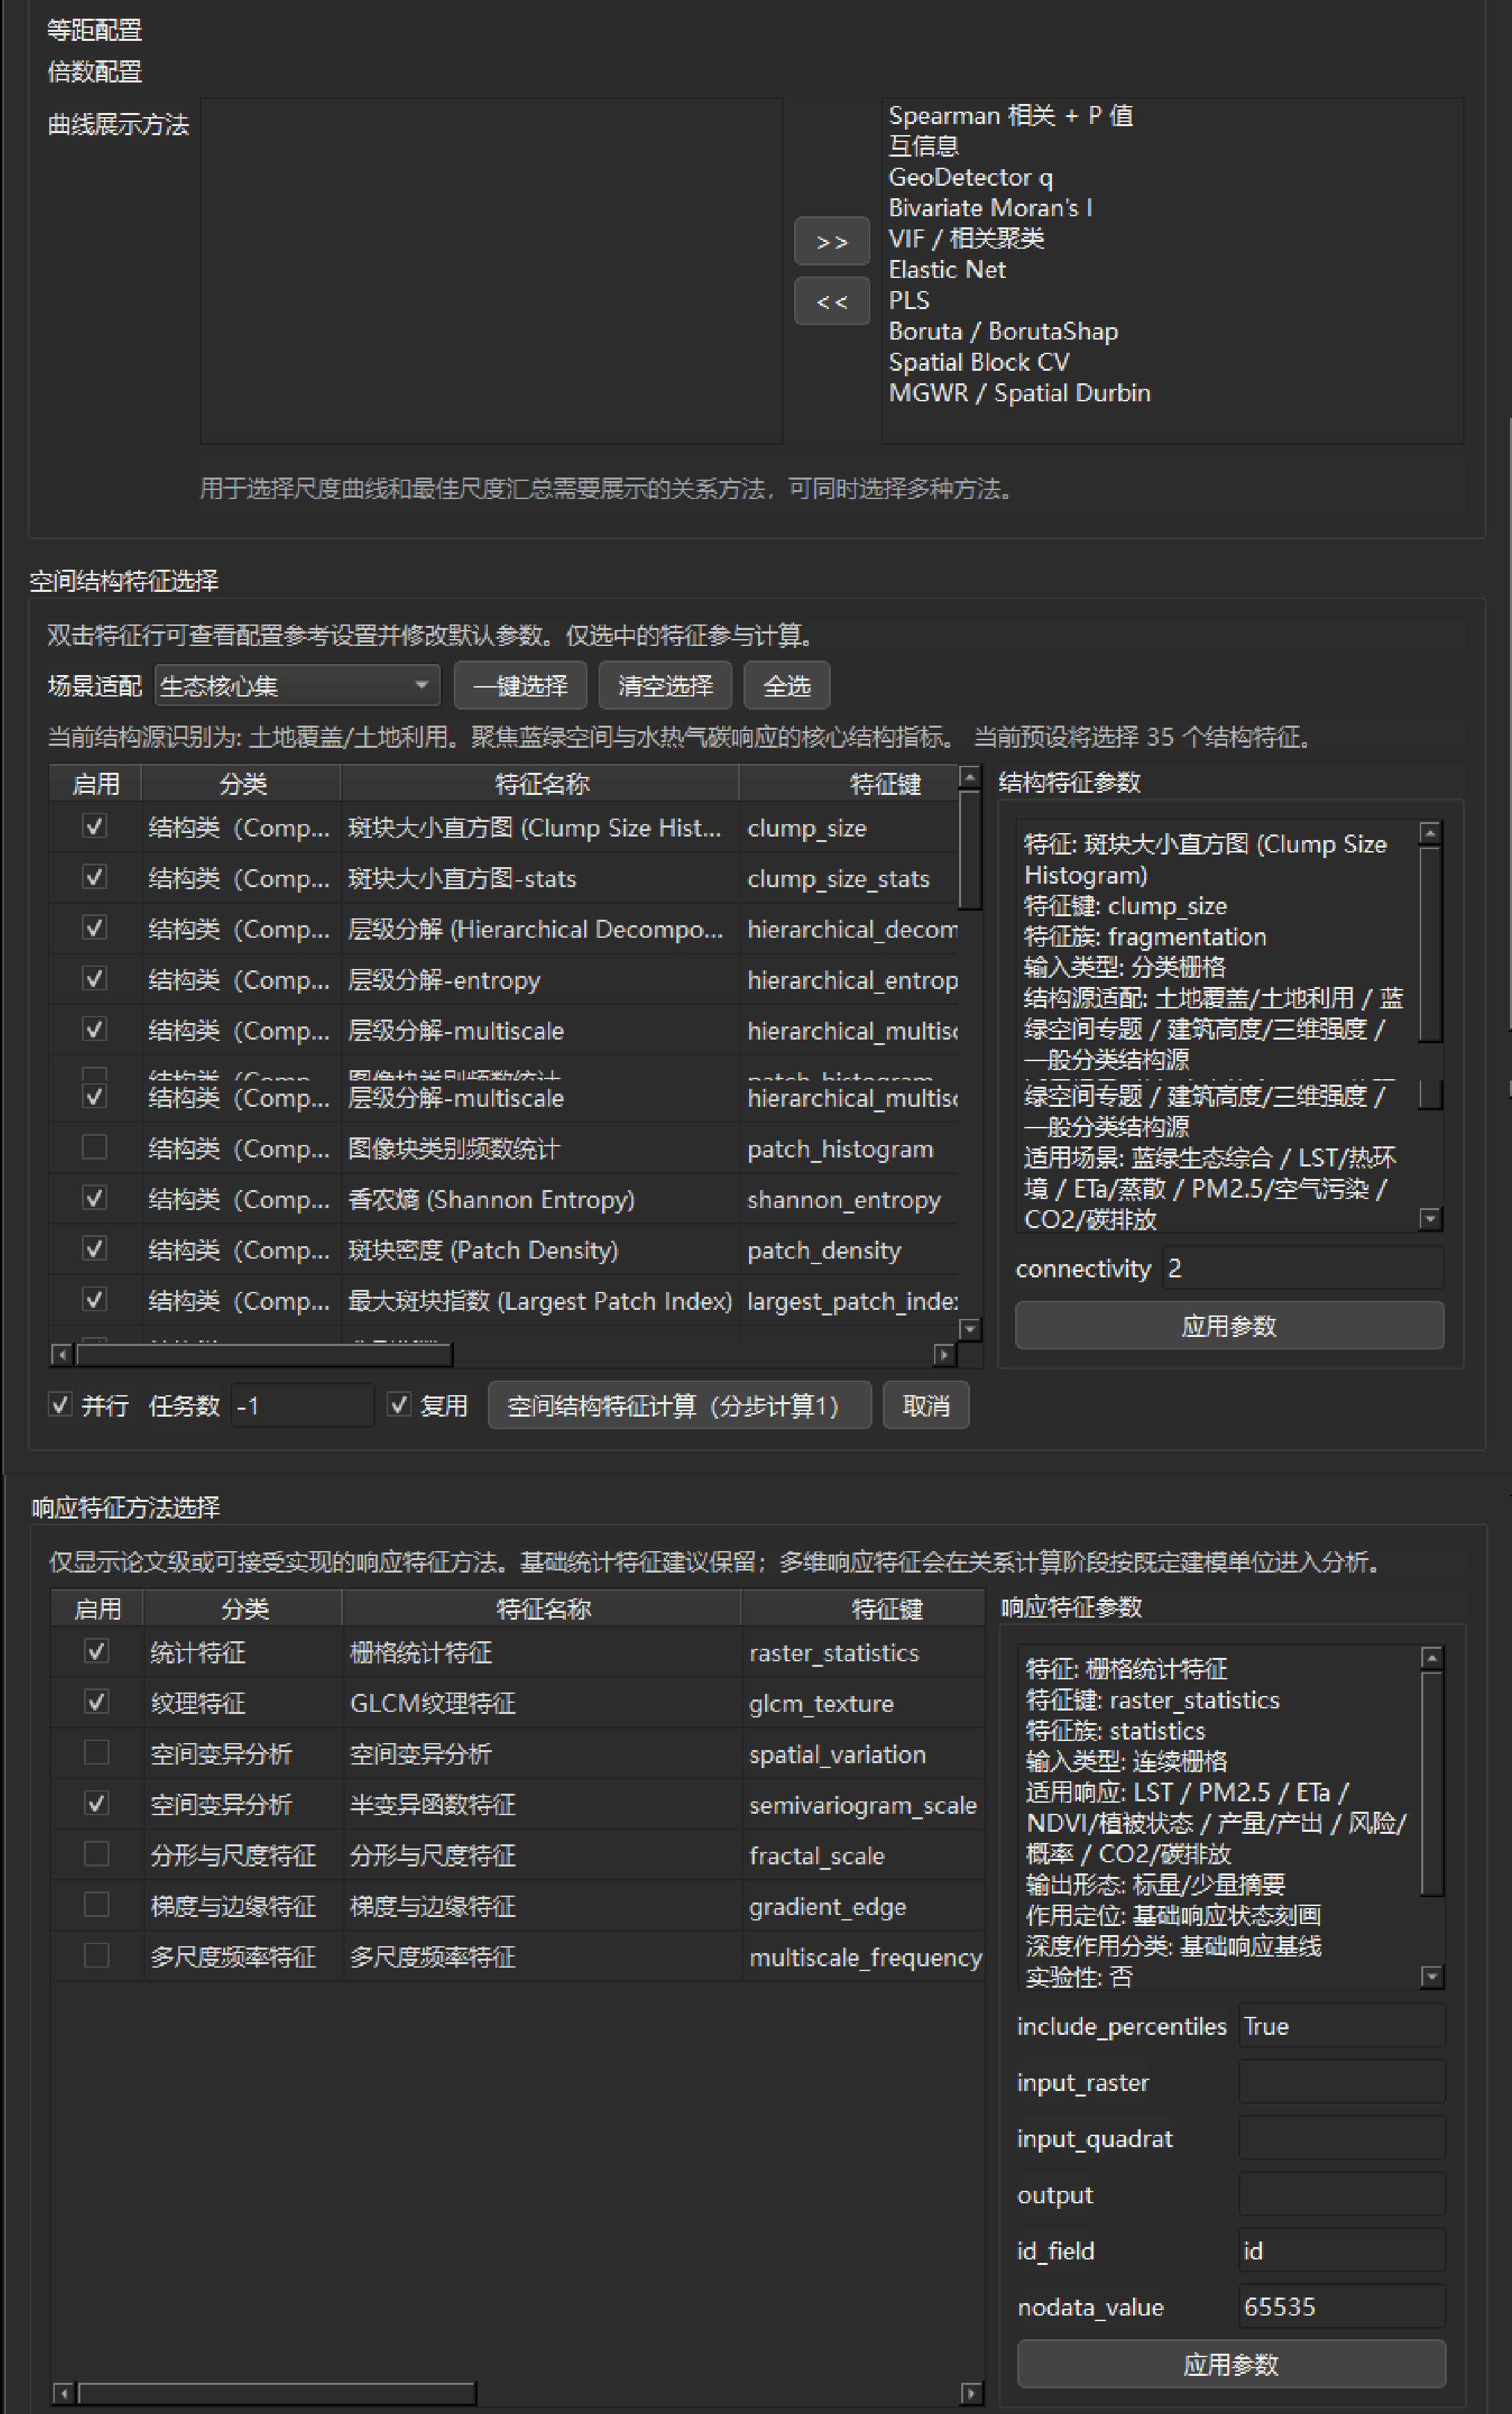
图 D-26 统计单元尺度完整配置:数据源、规则网格、结构与响应特征、关系及尺度方法(第 2/3 部分)
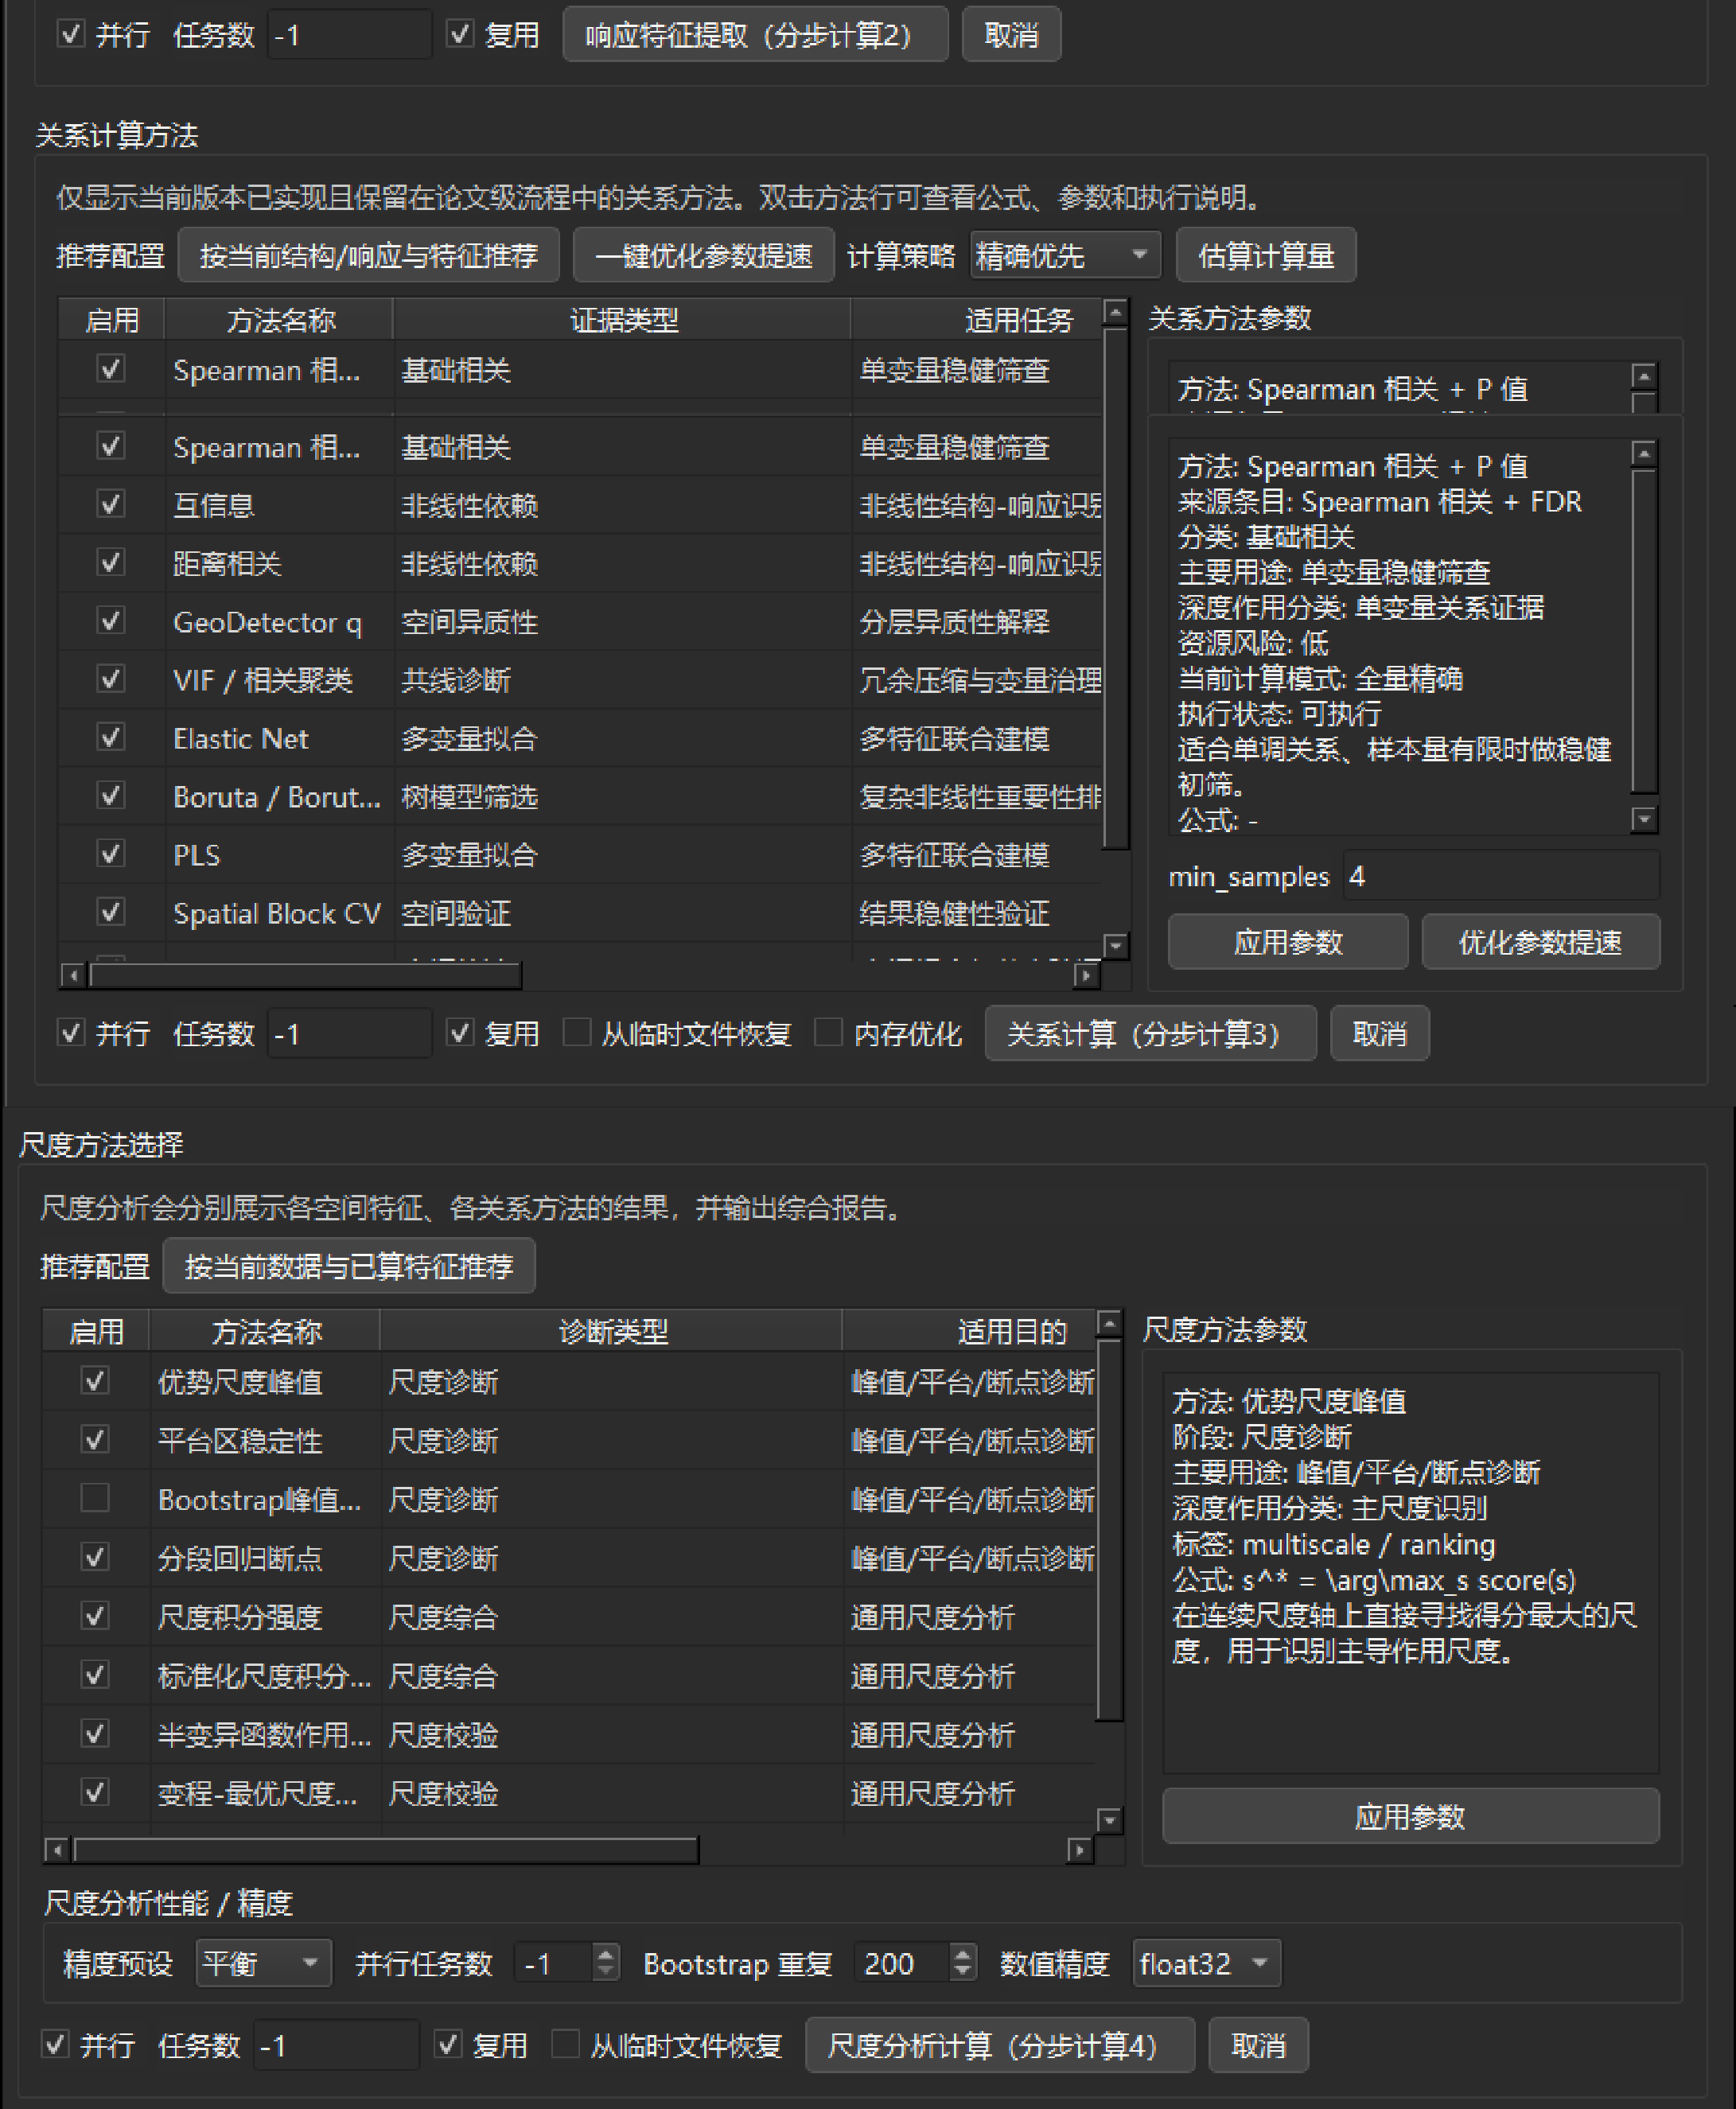
图 D-26 统计单元尺度完整配置:数据源、规则网格、结构与响应特征、关系及尺度方法(第 3/3 部分)
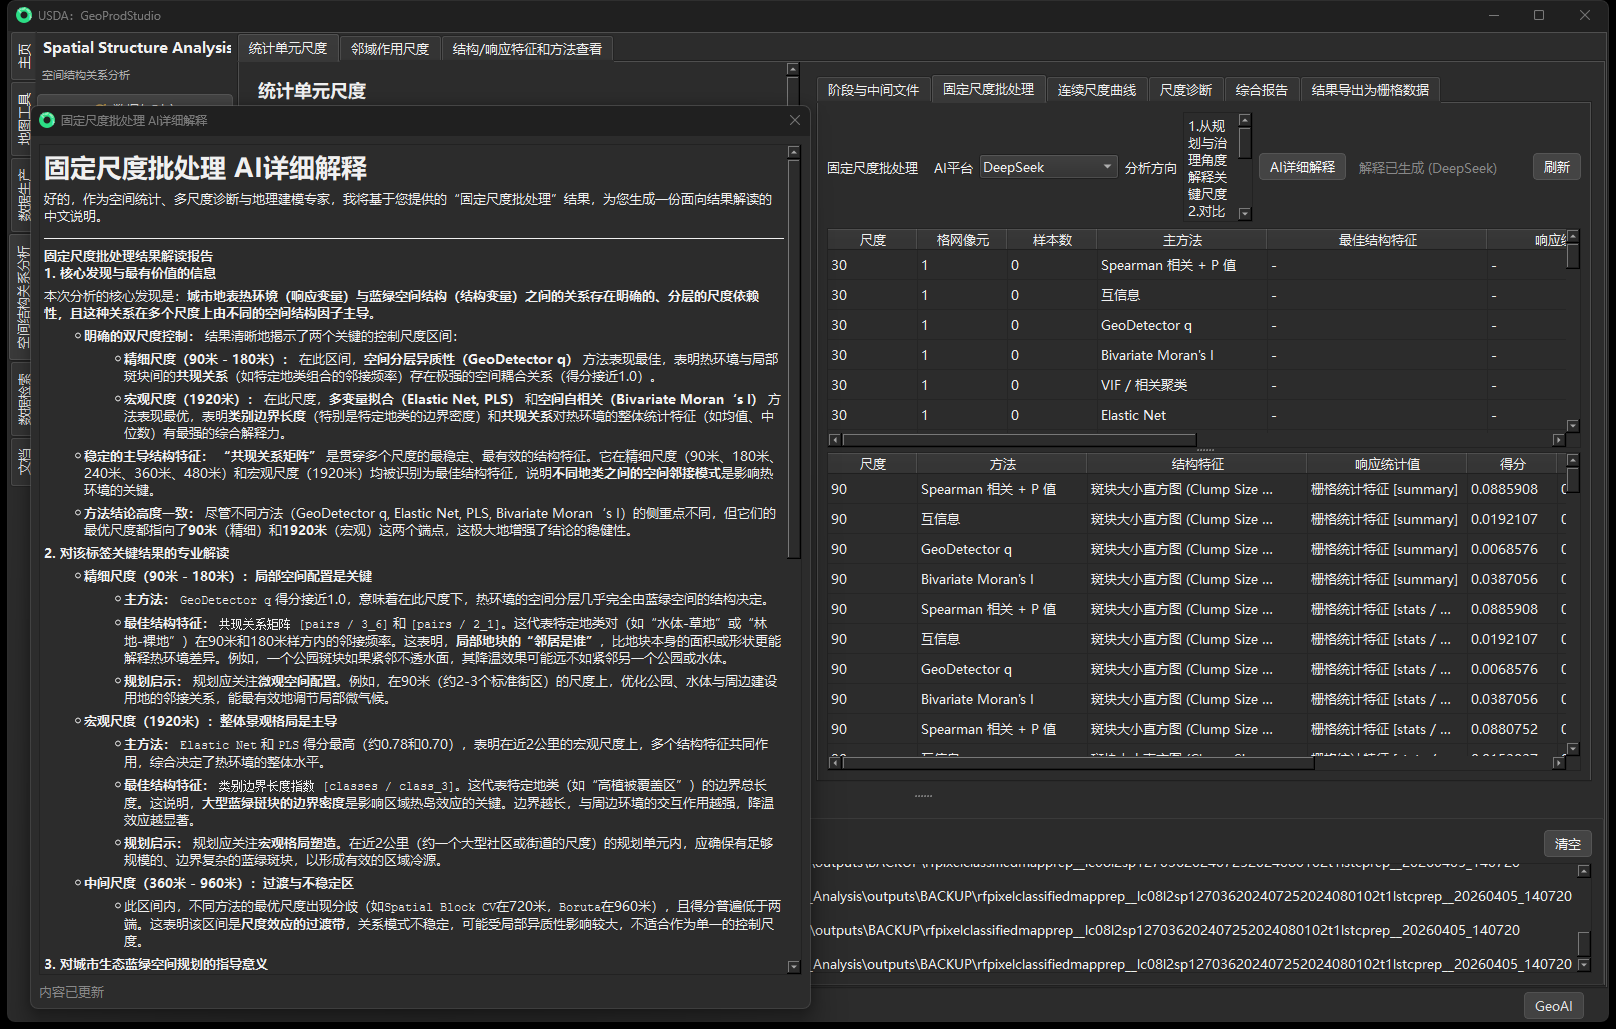
图 D-27 统计单元尺度固定尺度批处理:关系、多变量结果、样本数与备注
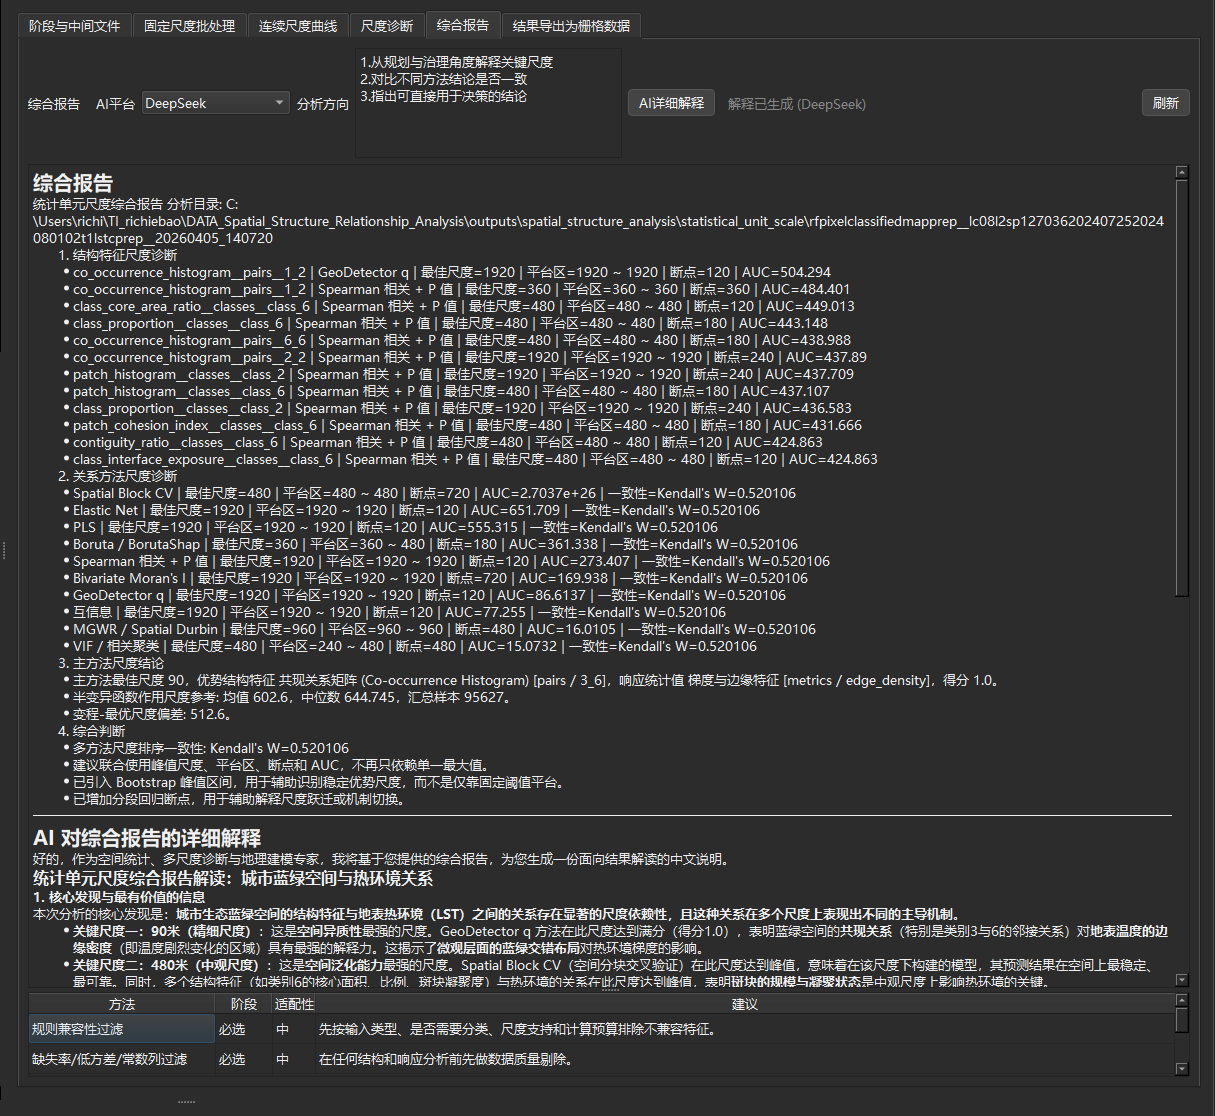
图 D-28 统计单元尺度综合报告:关键特征、关系方法、主尺度候选与解释汇总
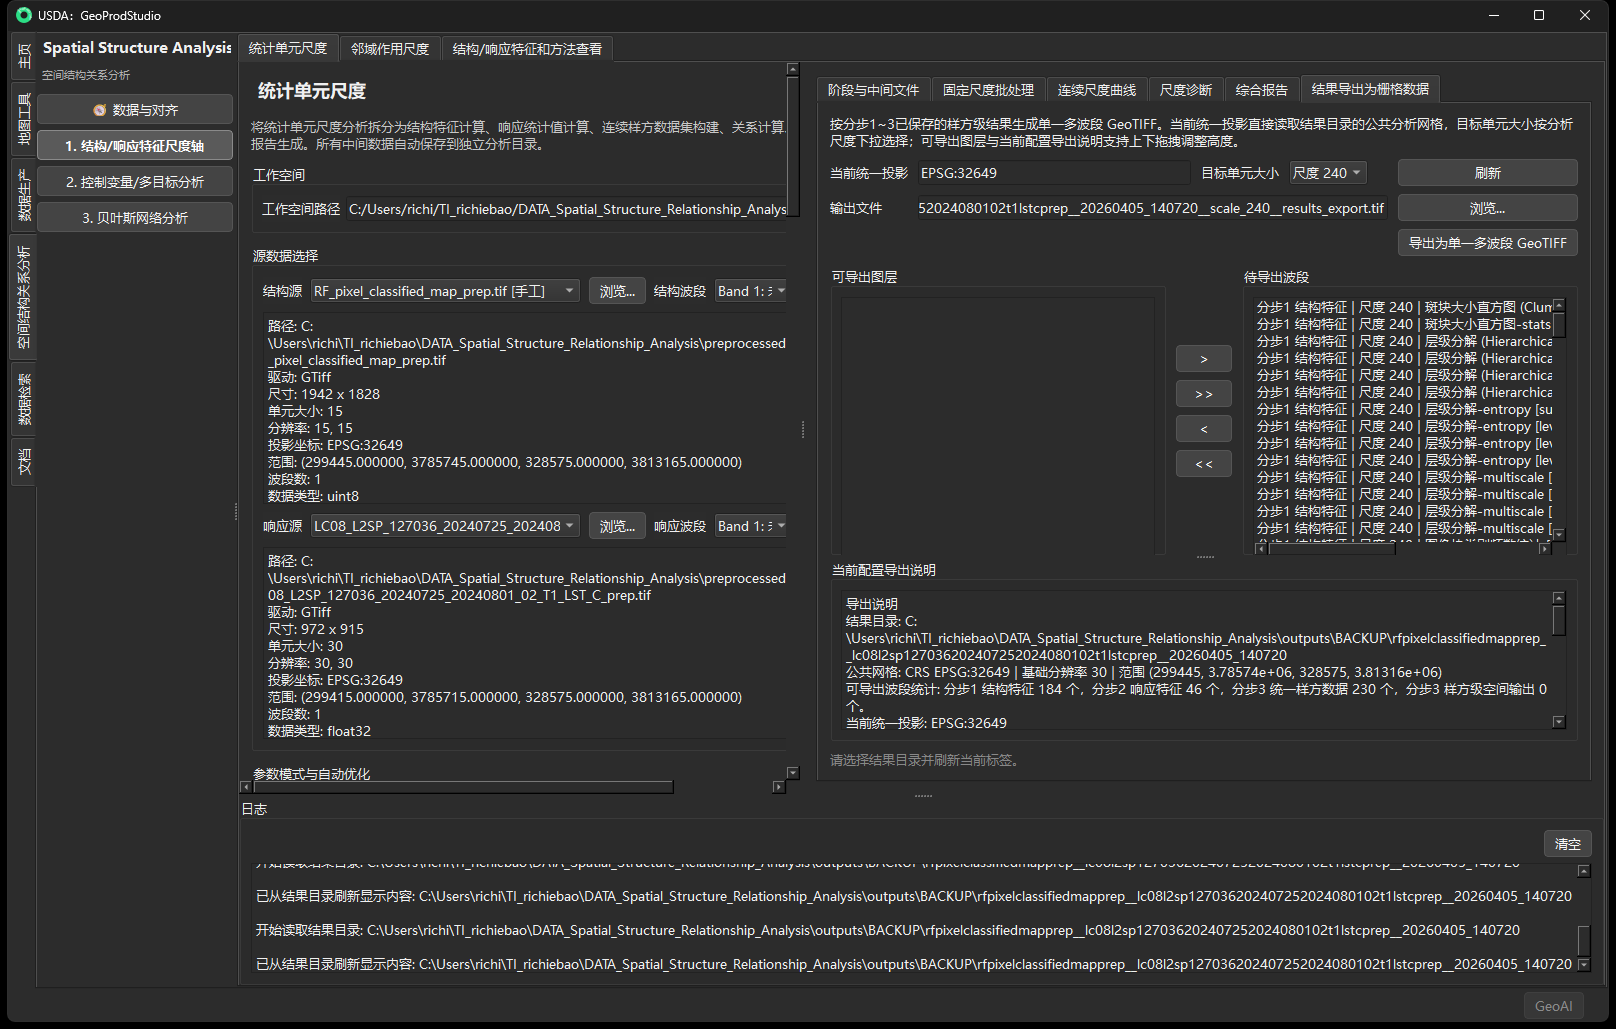
图 D-29 统计单元尺度结果空间化导出:目标坐标系、单元大小、尺度、图层与路径配置
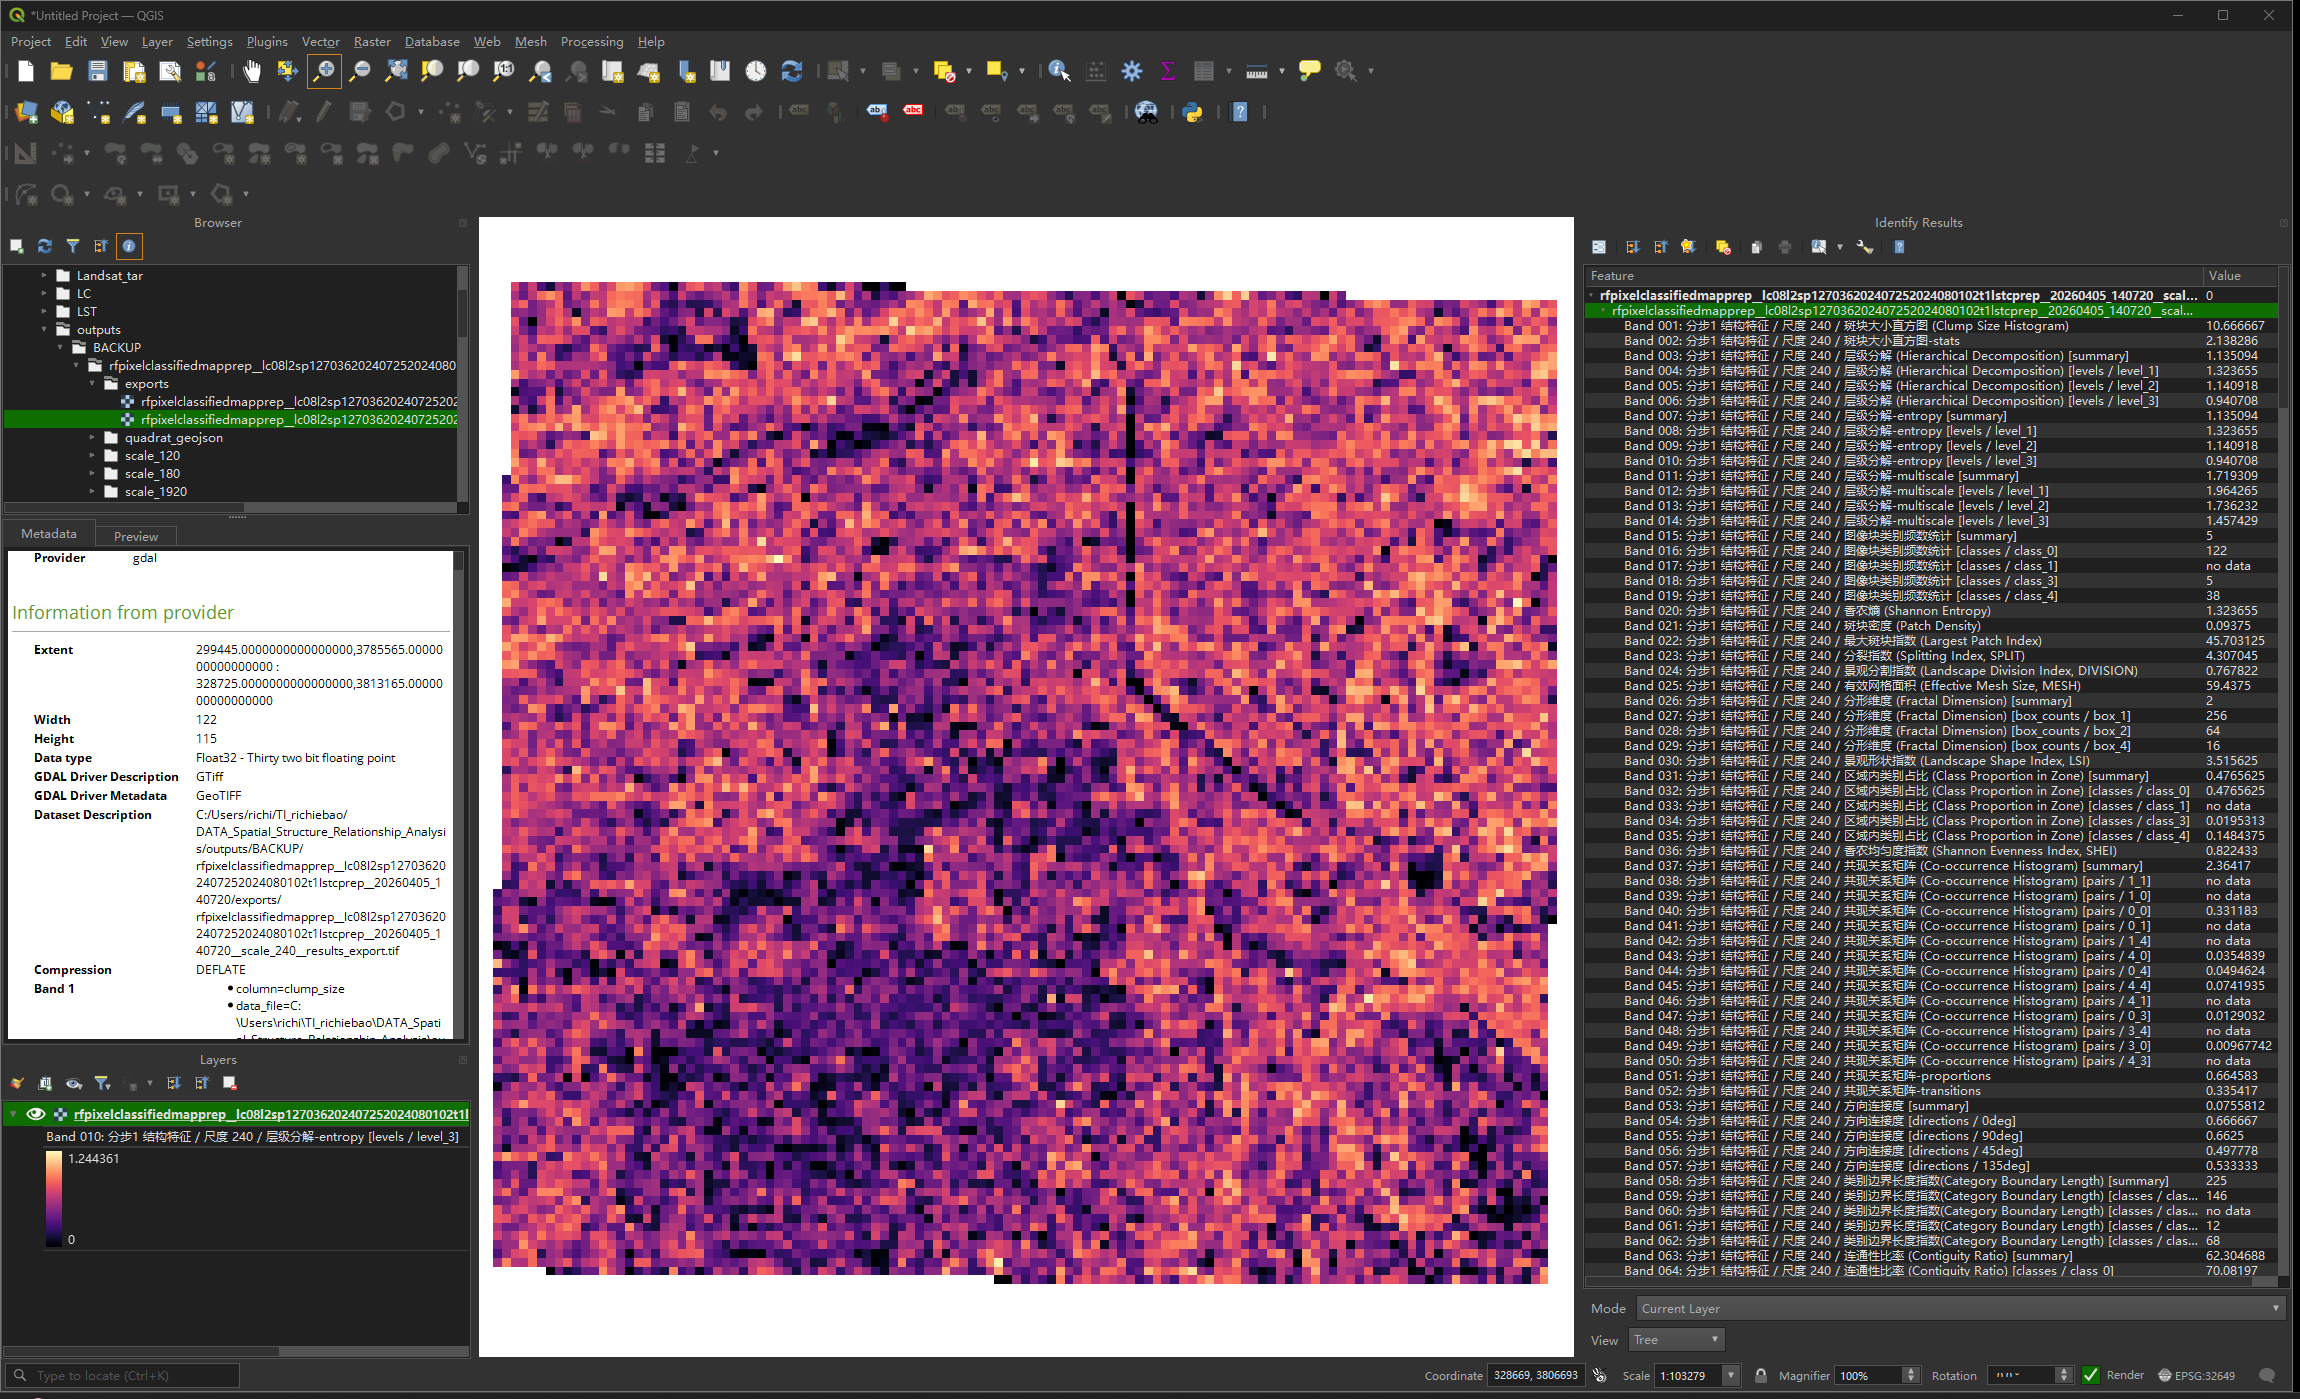
图 D-30 统计单元尺度多波段空间结果:波段栅格展示与属性核验
D.3.2 结构/响应特征尺度轴—邻域作用尺度
先展示邻域作用尺度完整配置,再按固定窗口批处理、连续尺度曲线、尺度诊断、综合报告、结果导出及导出成果示例的页签顺序排列。
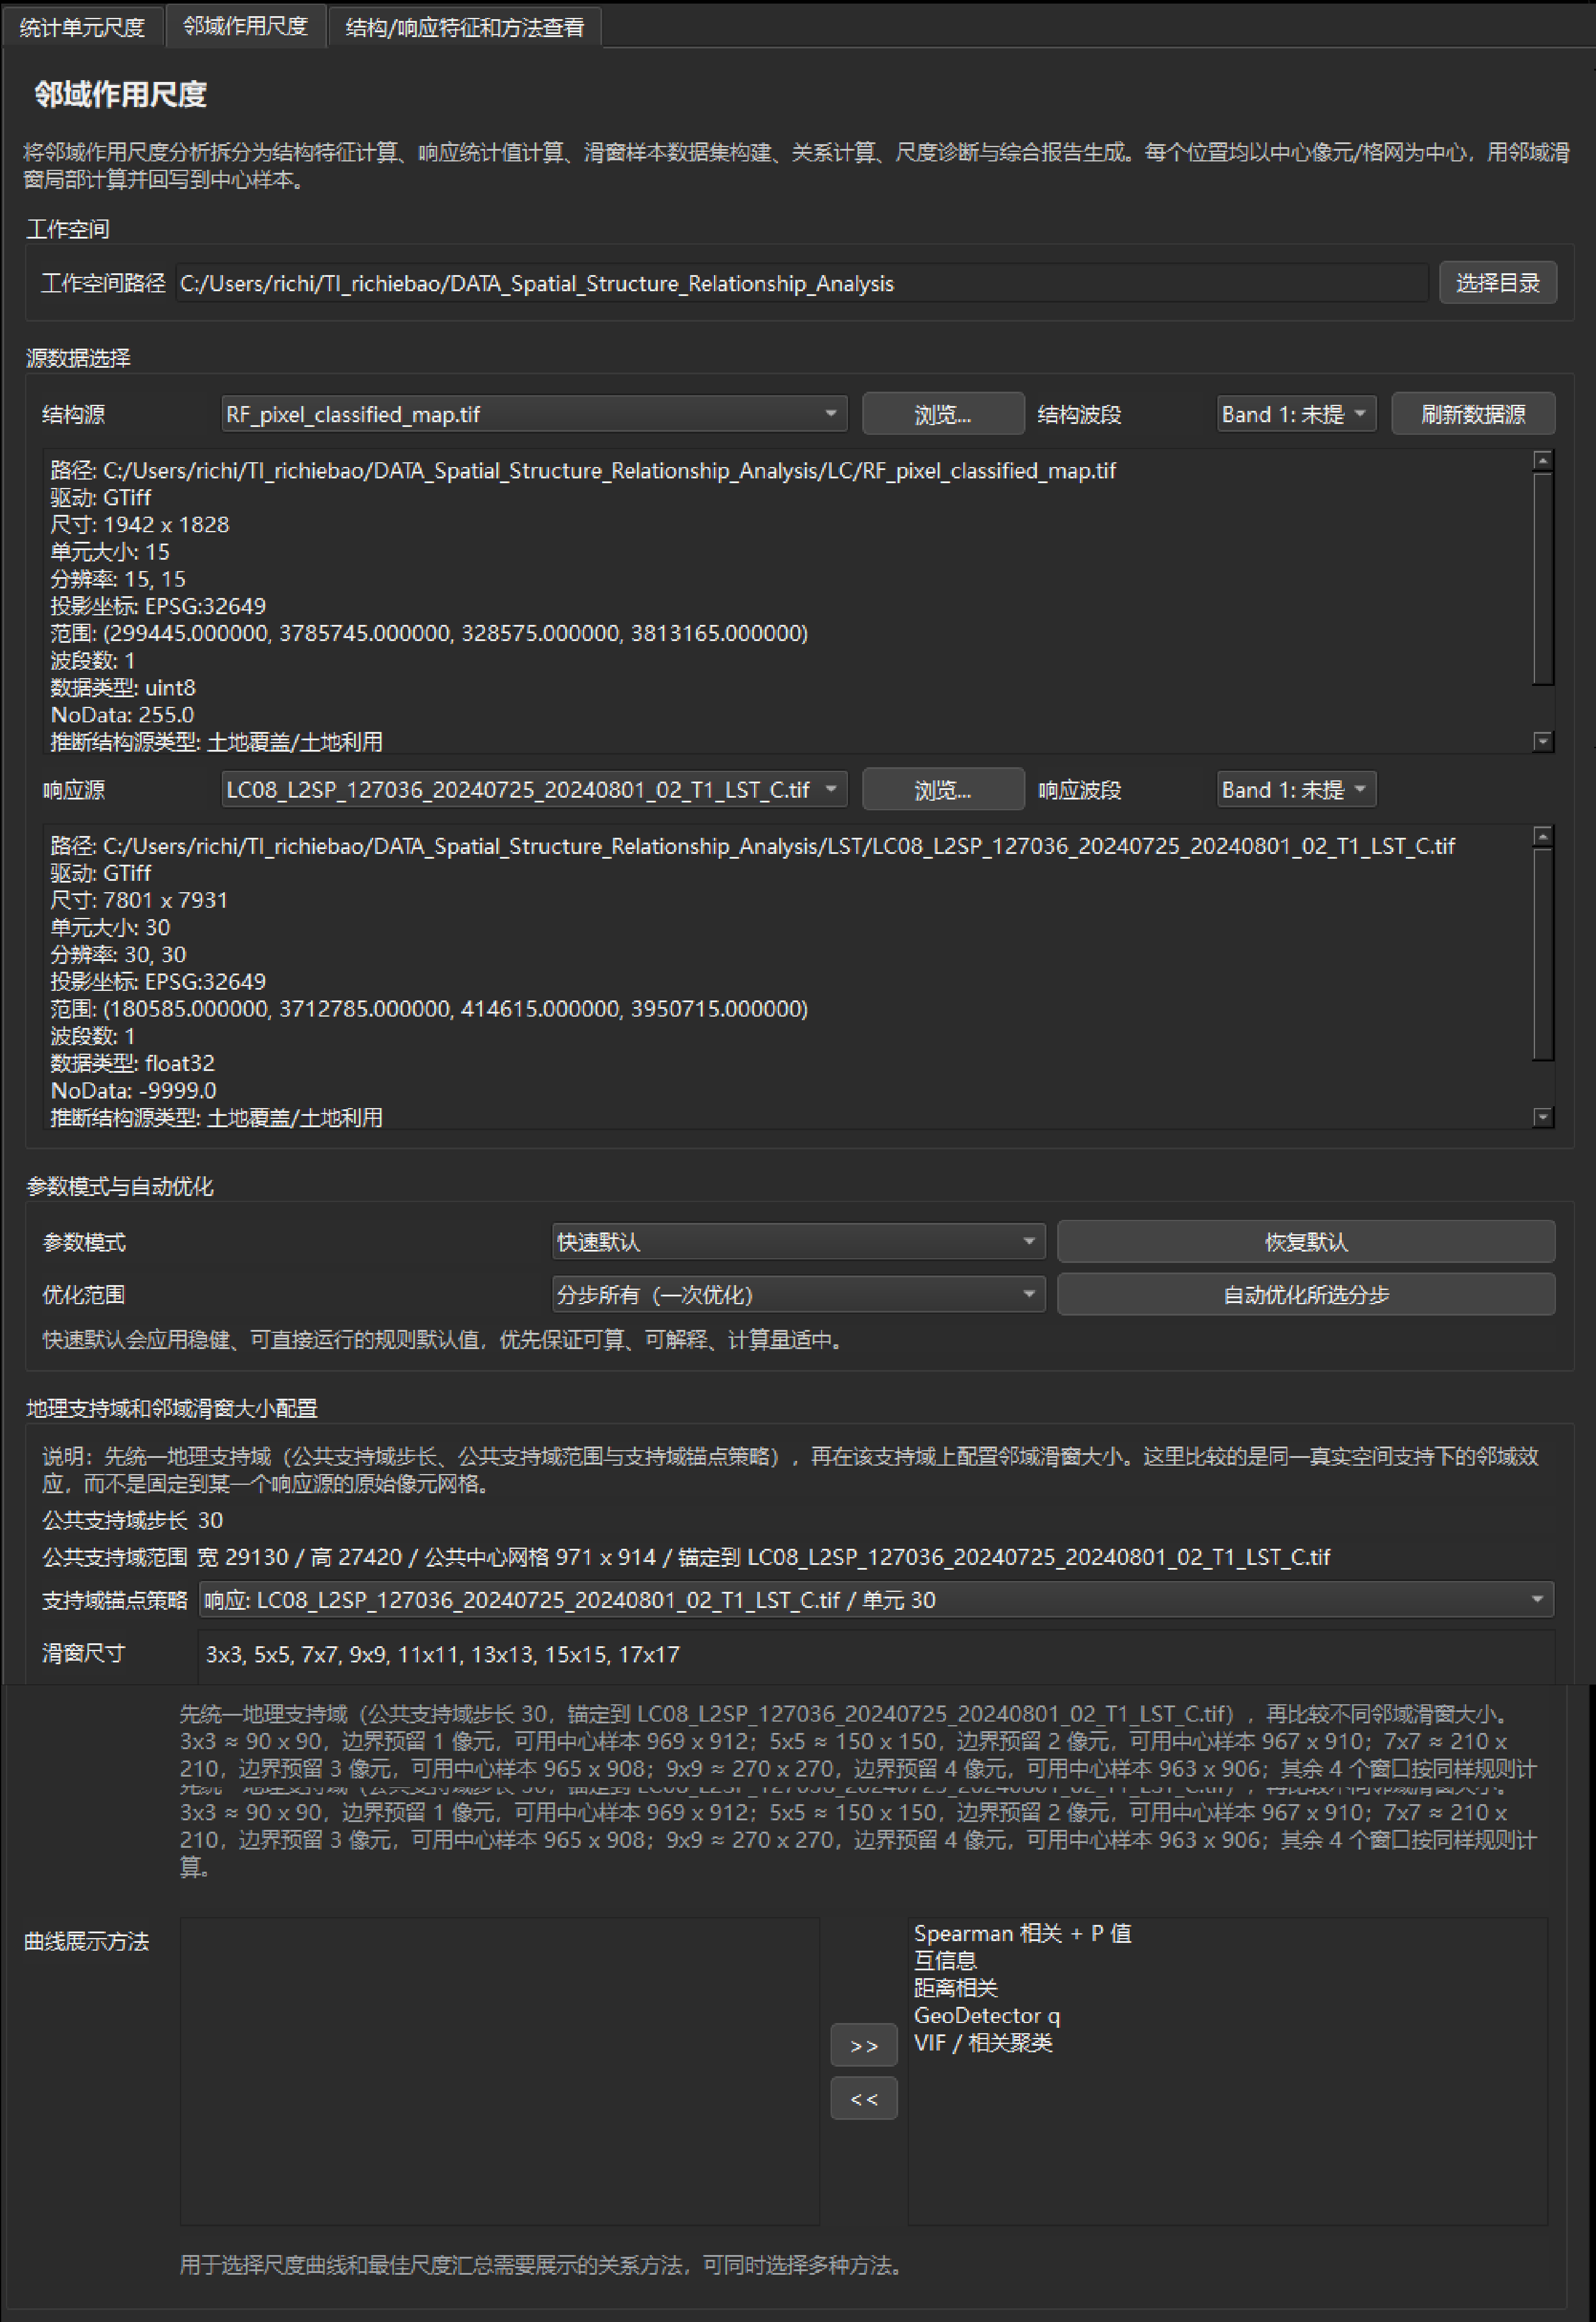
图 D-31 邻域作用尺度完整配置:公共支持域、锚点、滑窗、结构特征、关系与尺度方法(第 1/2 部分)
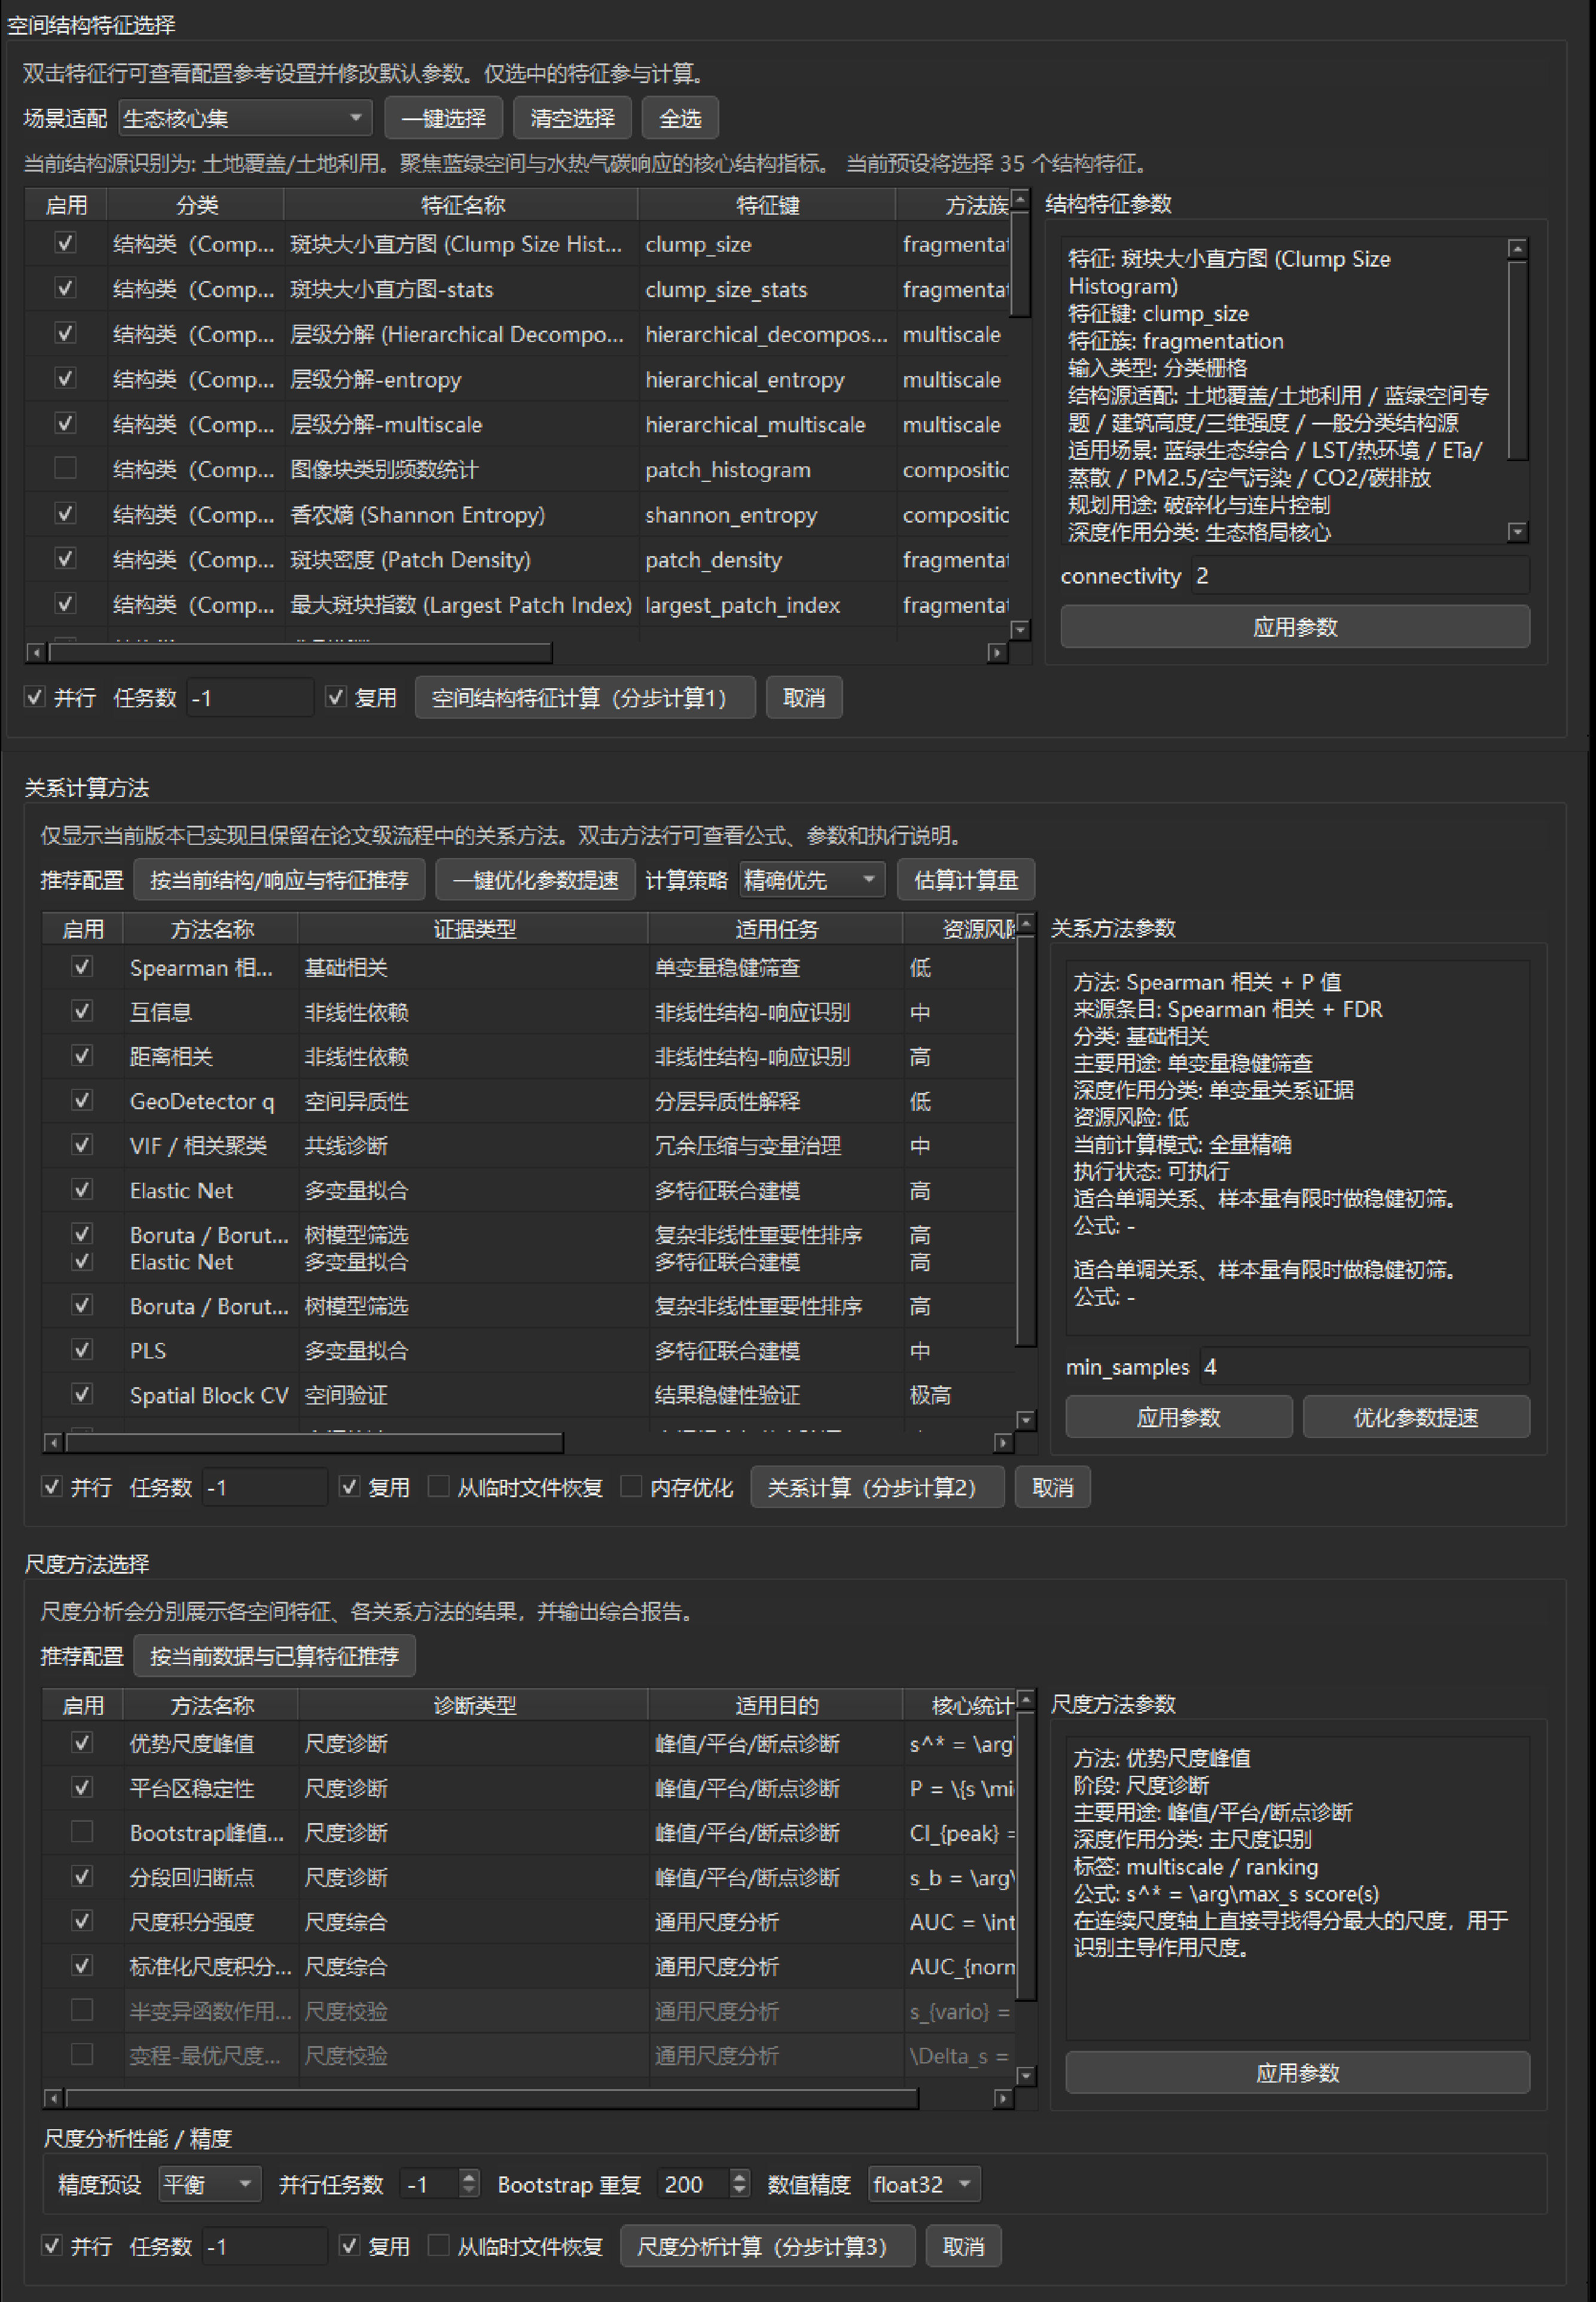
图 D-31 邻域作用尺度完整配置:公共支持域、锚点、滑窗、结构特征、关系与尺度方法(第 2/2 部分)
图 D-32 邻域作用尺度固定窗口批处理:结构特征与中心响应关系比较
图 D-33 邻域作用尺度连续曲线:局地至较大邻域的结构—响应关系变化
图 D-34 邻域作用尺度诊断:窗口峰值、稳定区间与转折候选
图 D-35 邻域作用尺度综合报告:窗口曲线、诊断指标与主要关系汇总
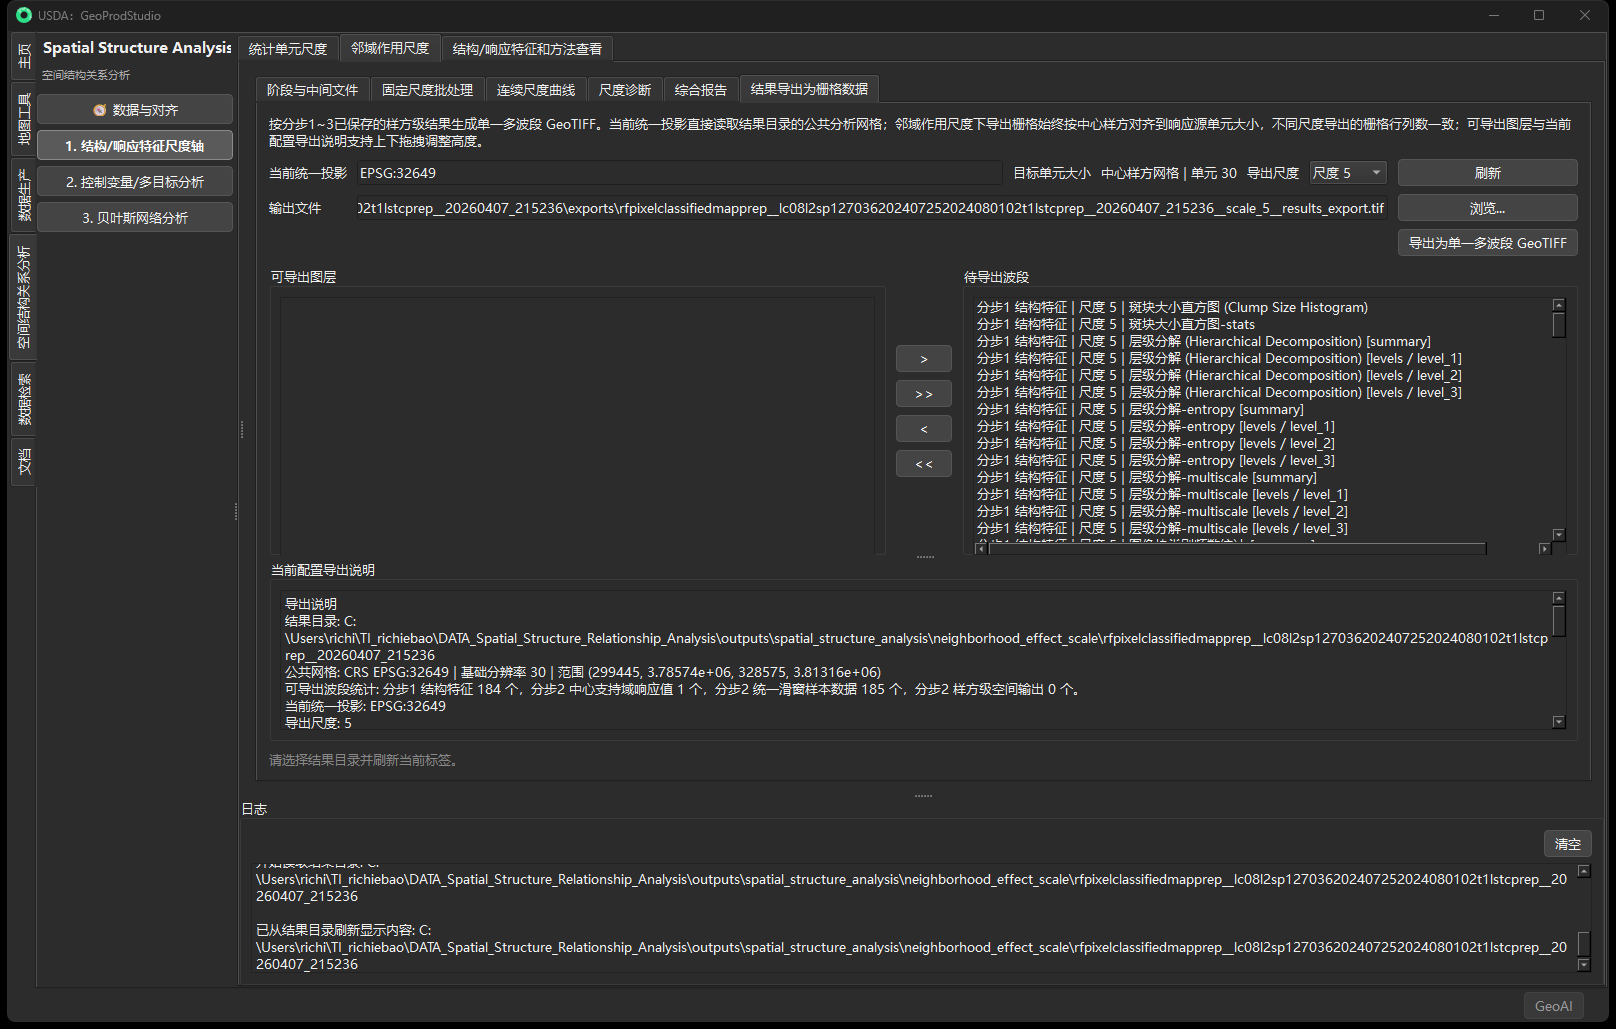
图 D-36 邻域作用尺度结果空间化导出:按窗口与公共中心位置回写关系和局部结果
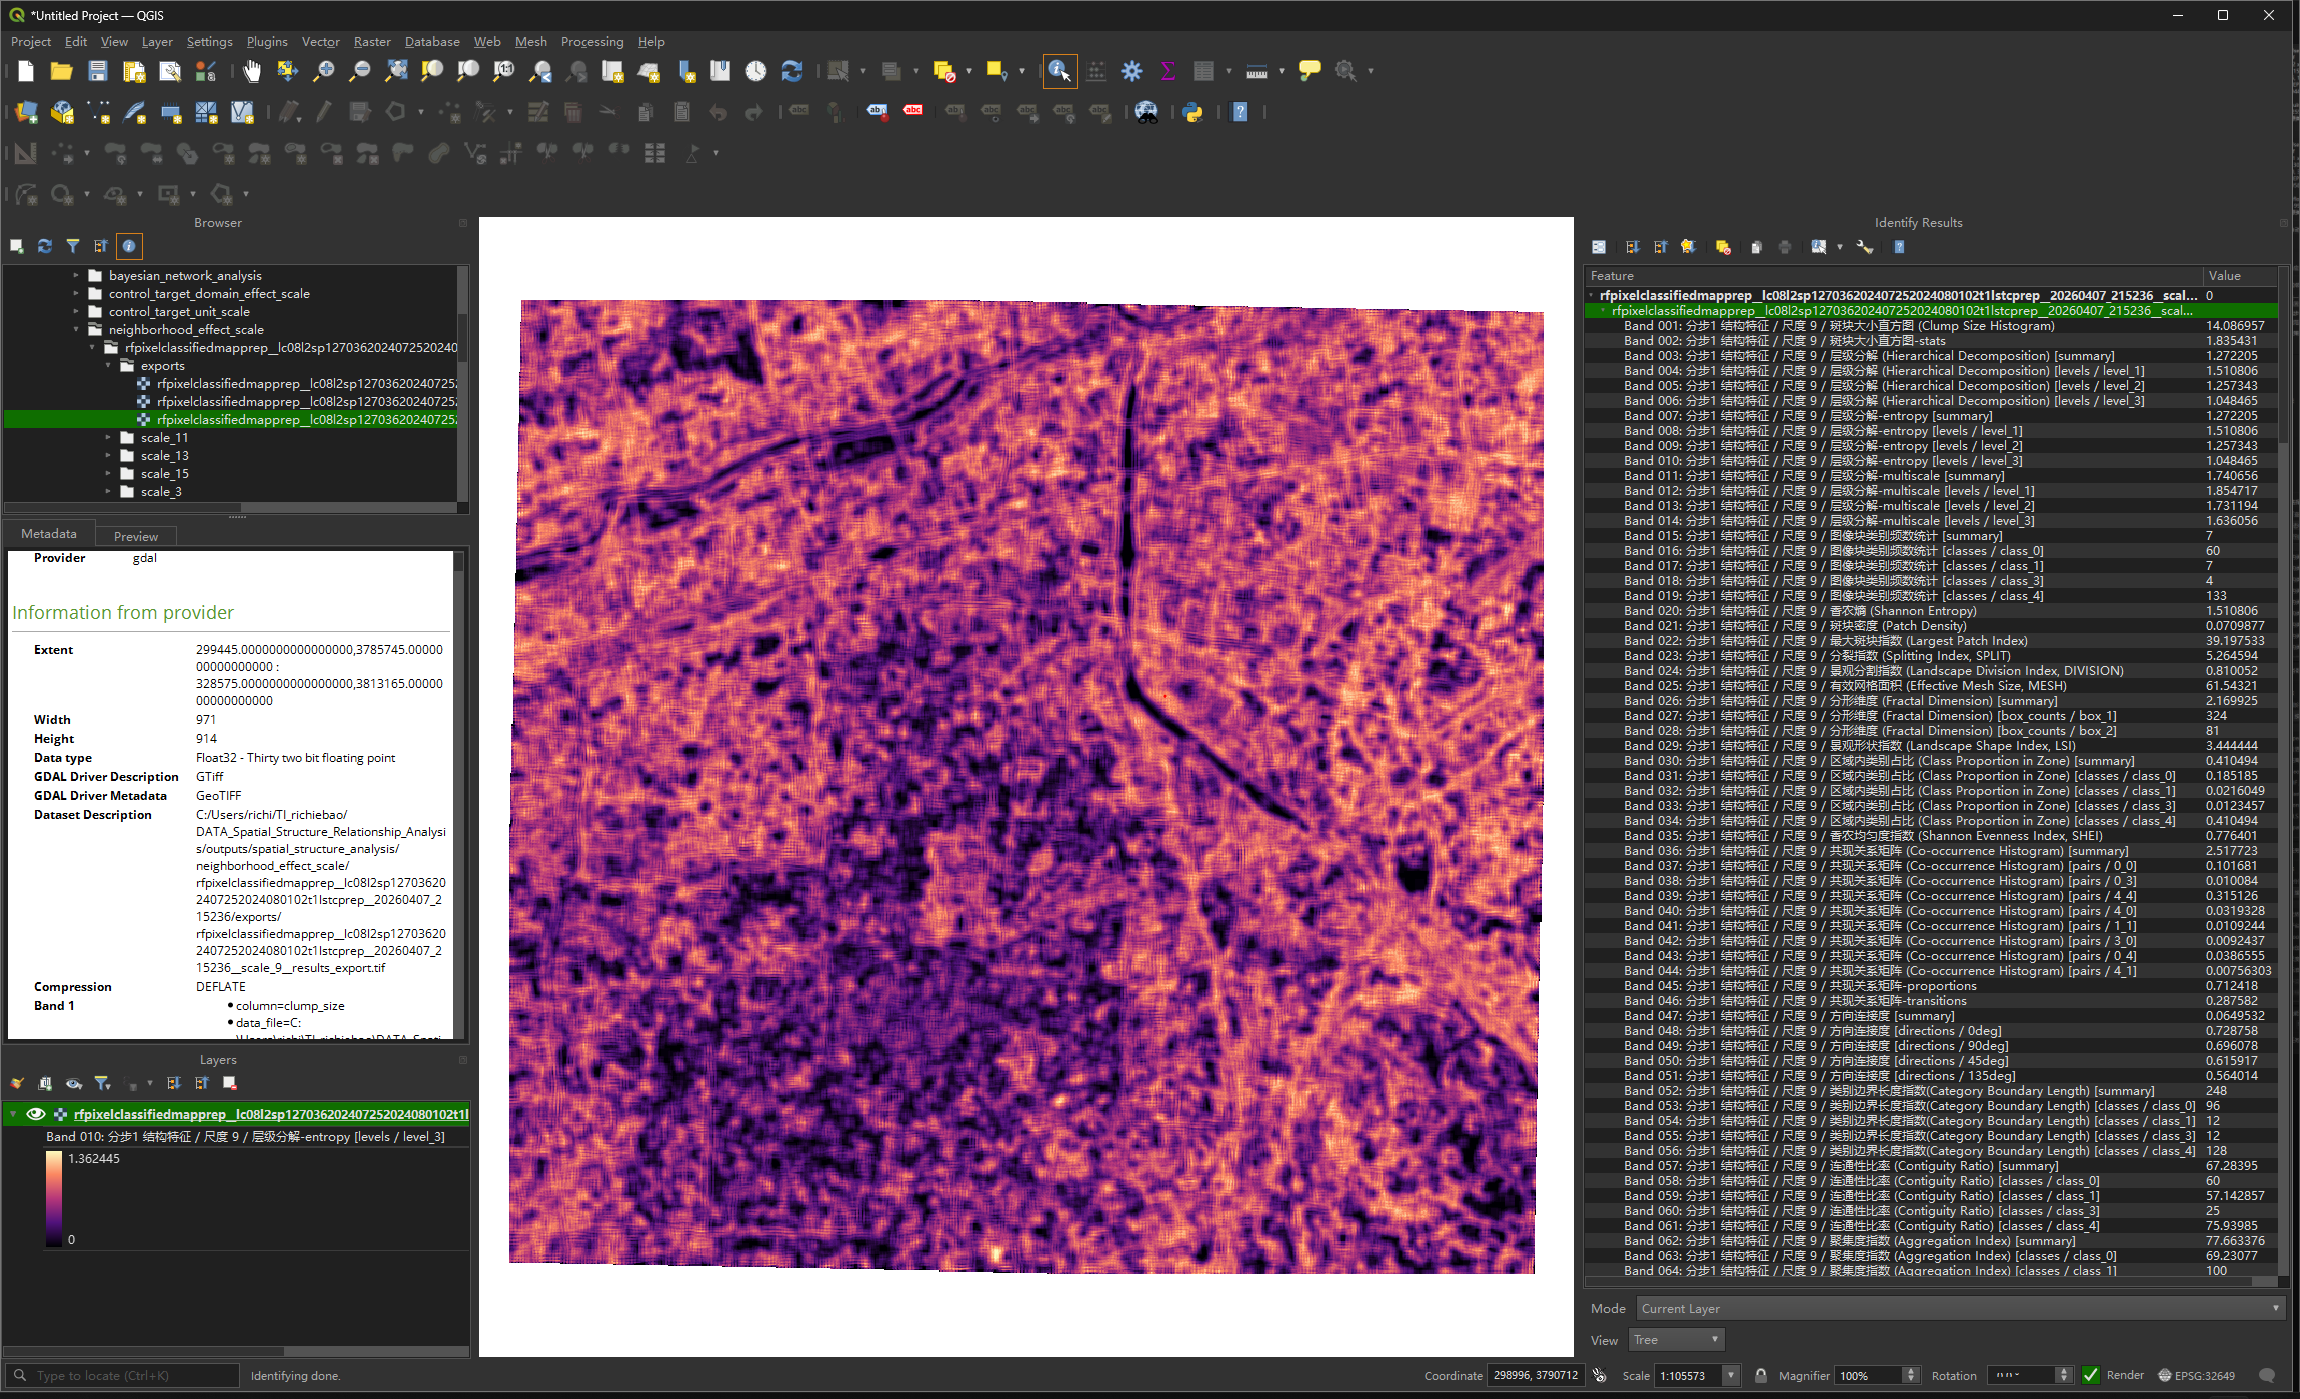
图 D-37 邻域作用尺度多波段空间结果:待导出字段的栅格展示与属性核验
D.3.3 控制变量/多目标分析—统计单元尺度
先展示统计单元尺度的控制变量与多目标完整配置,再按协同/权衡批处理、综合协同报告和结果导出成果的页签顺序排列。
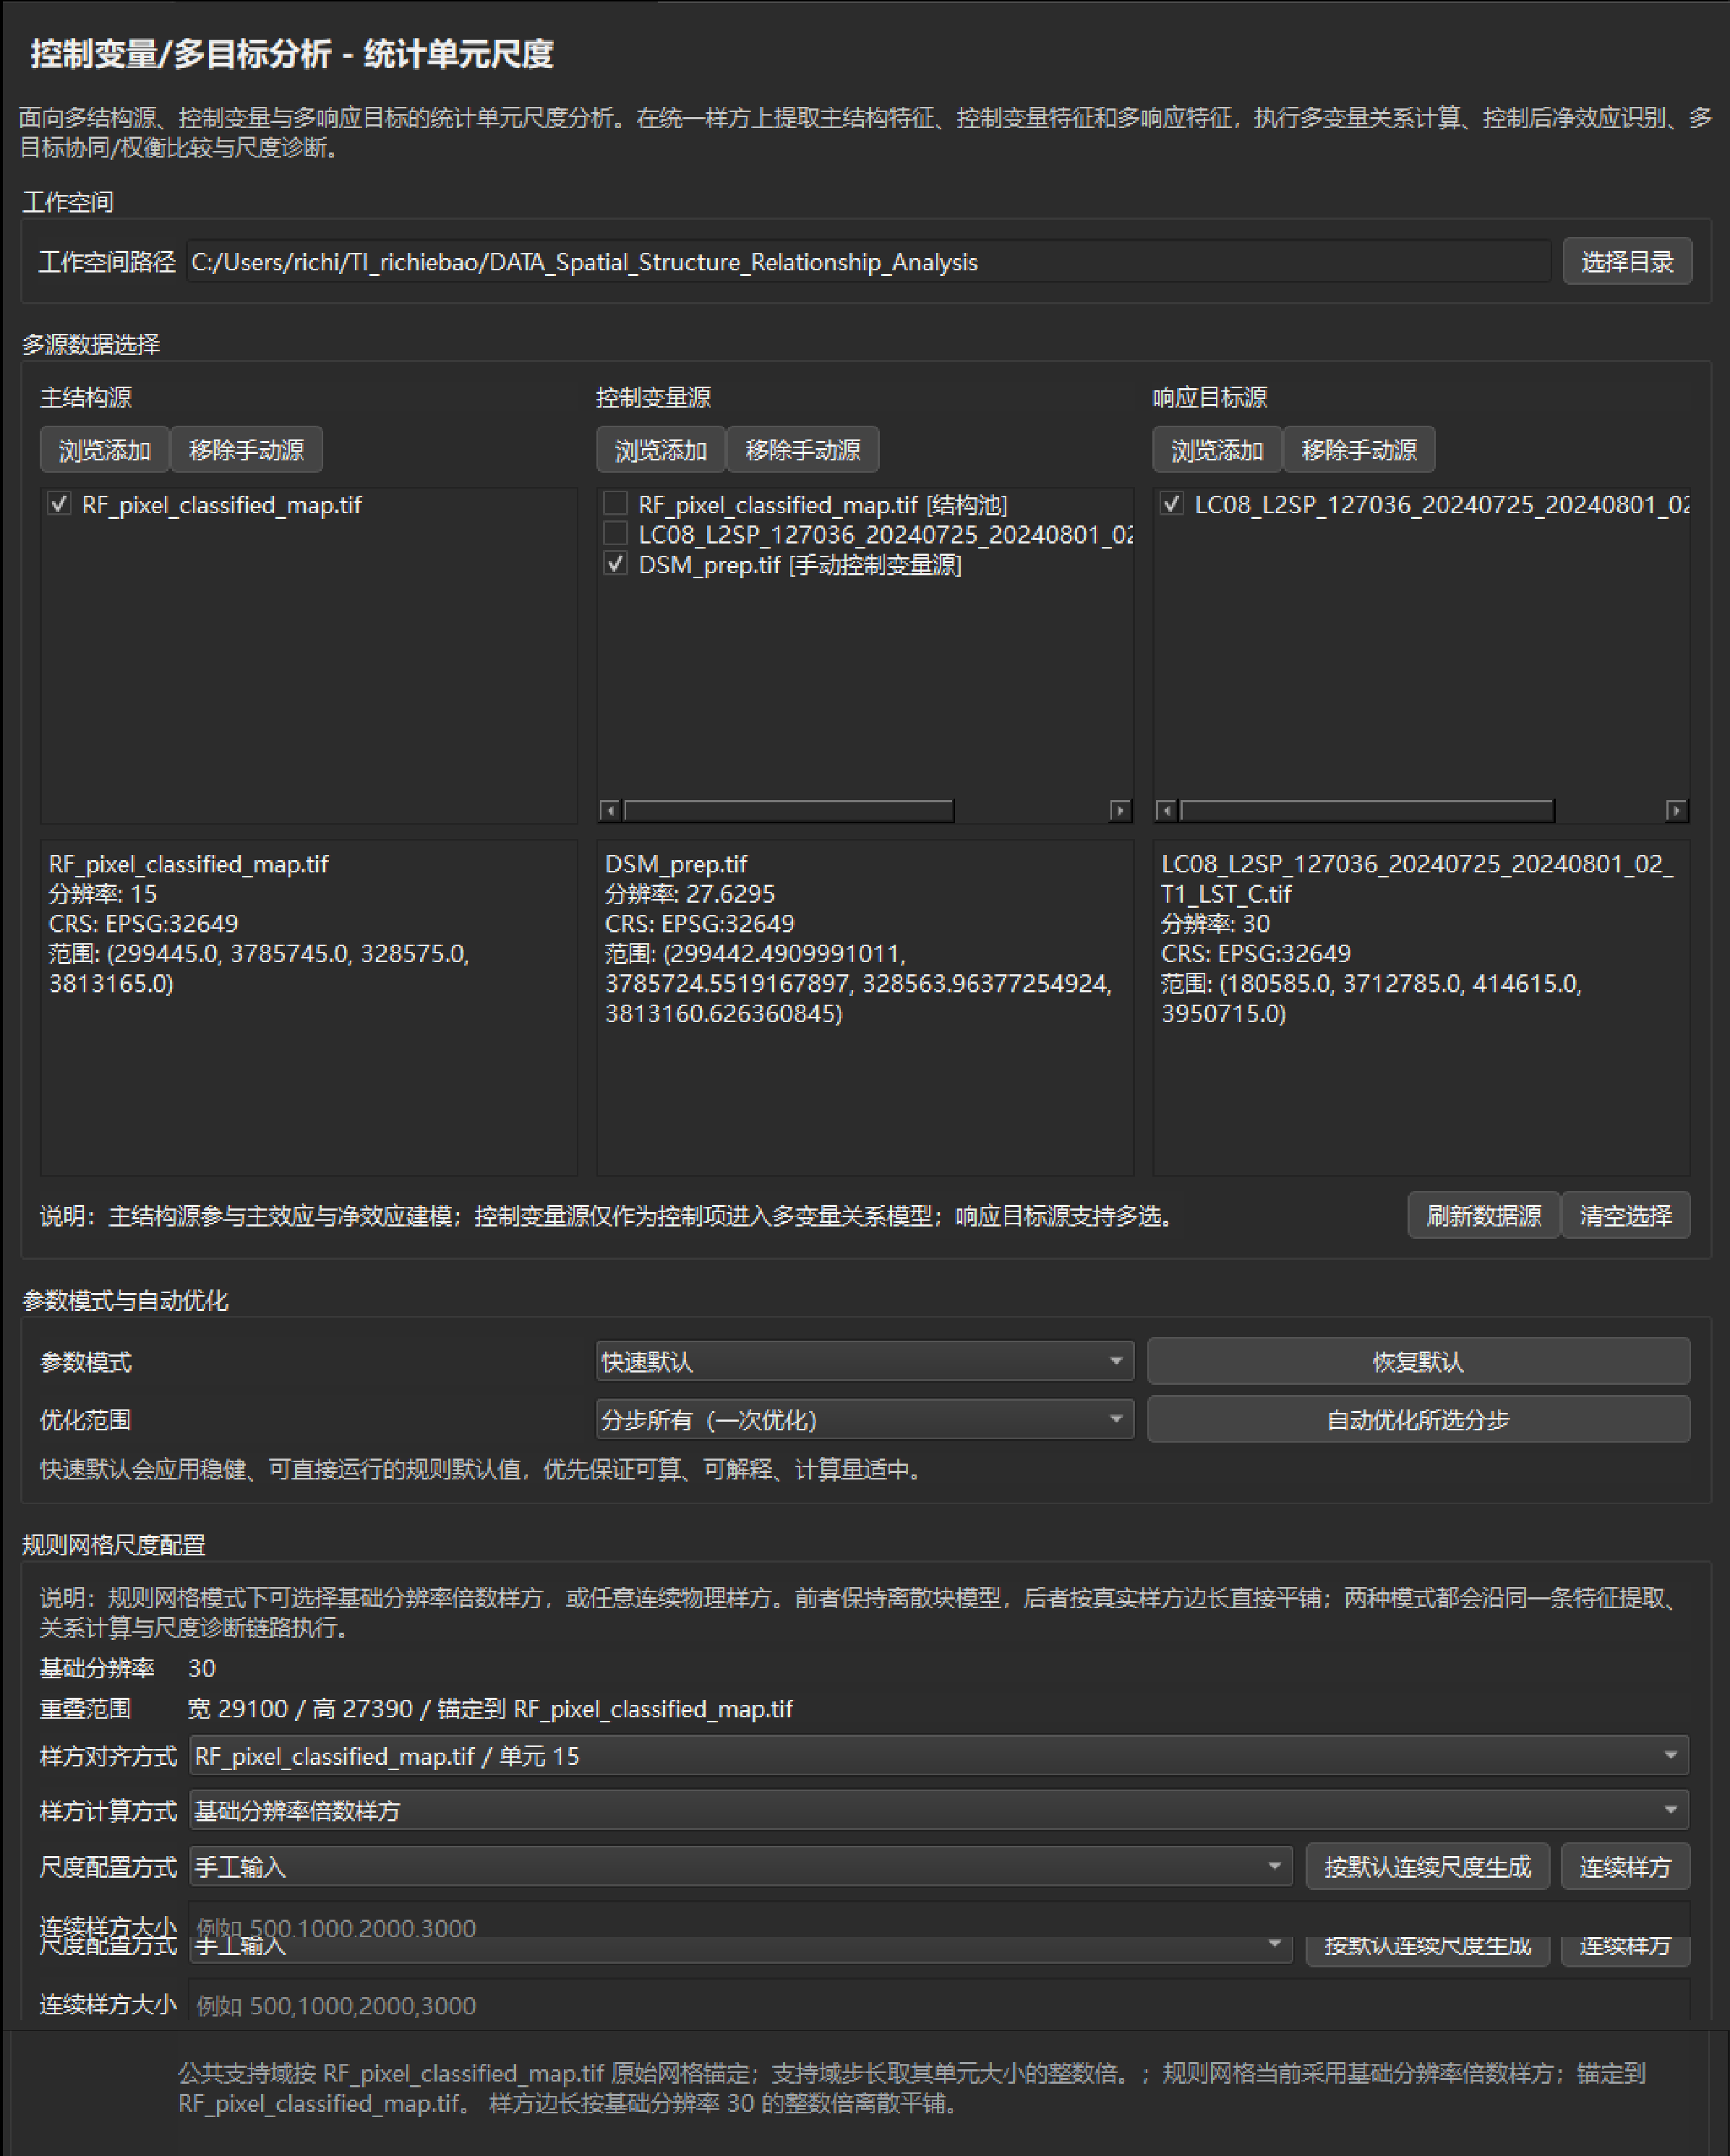
图 D-38 控制变量与多目标统计单元尺度完整配置:多源数据、规则网格、特征、方法、性能与阶段化运行(第 1/3 部分)
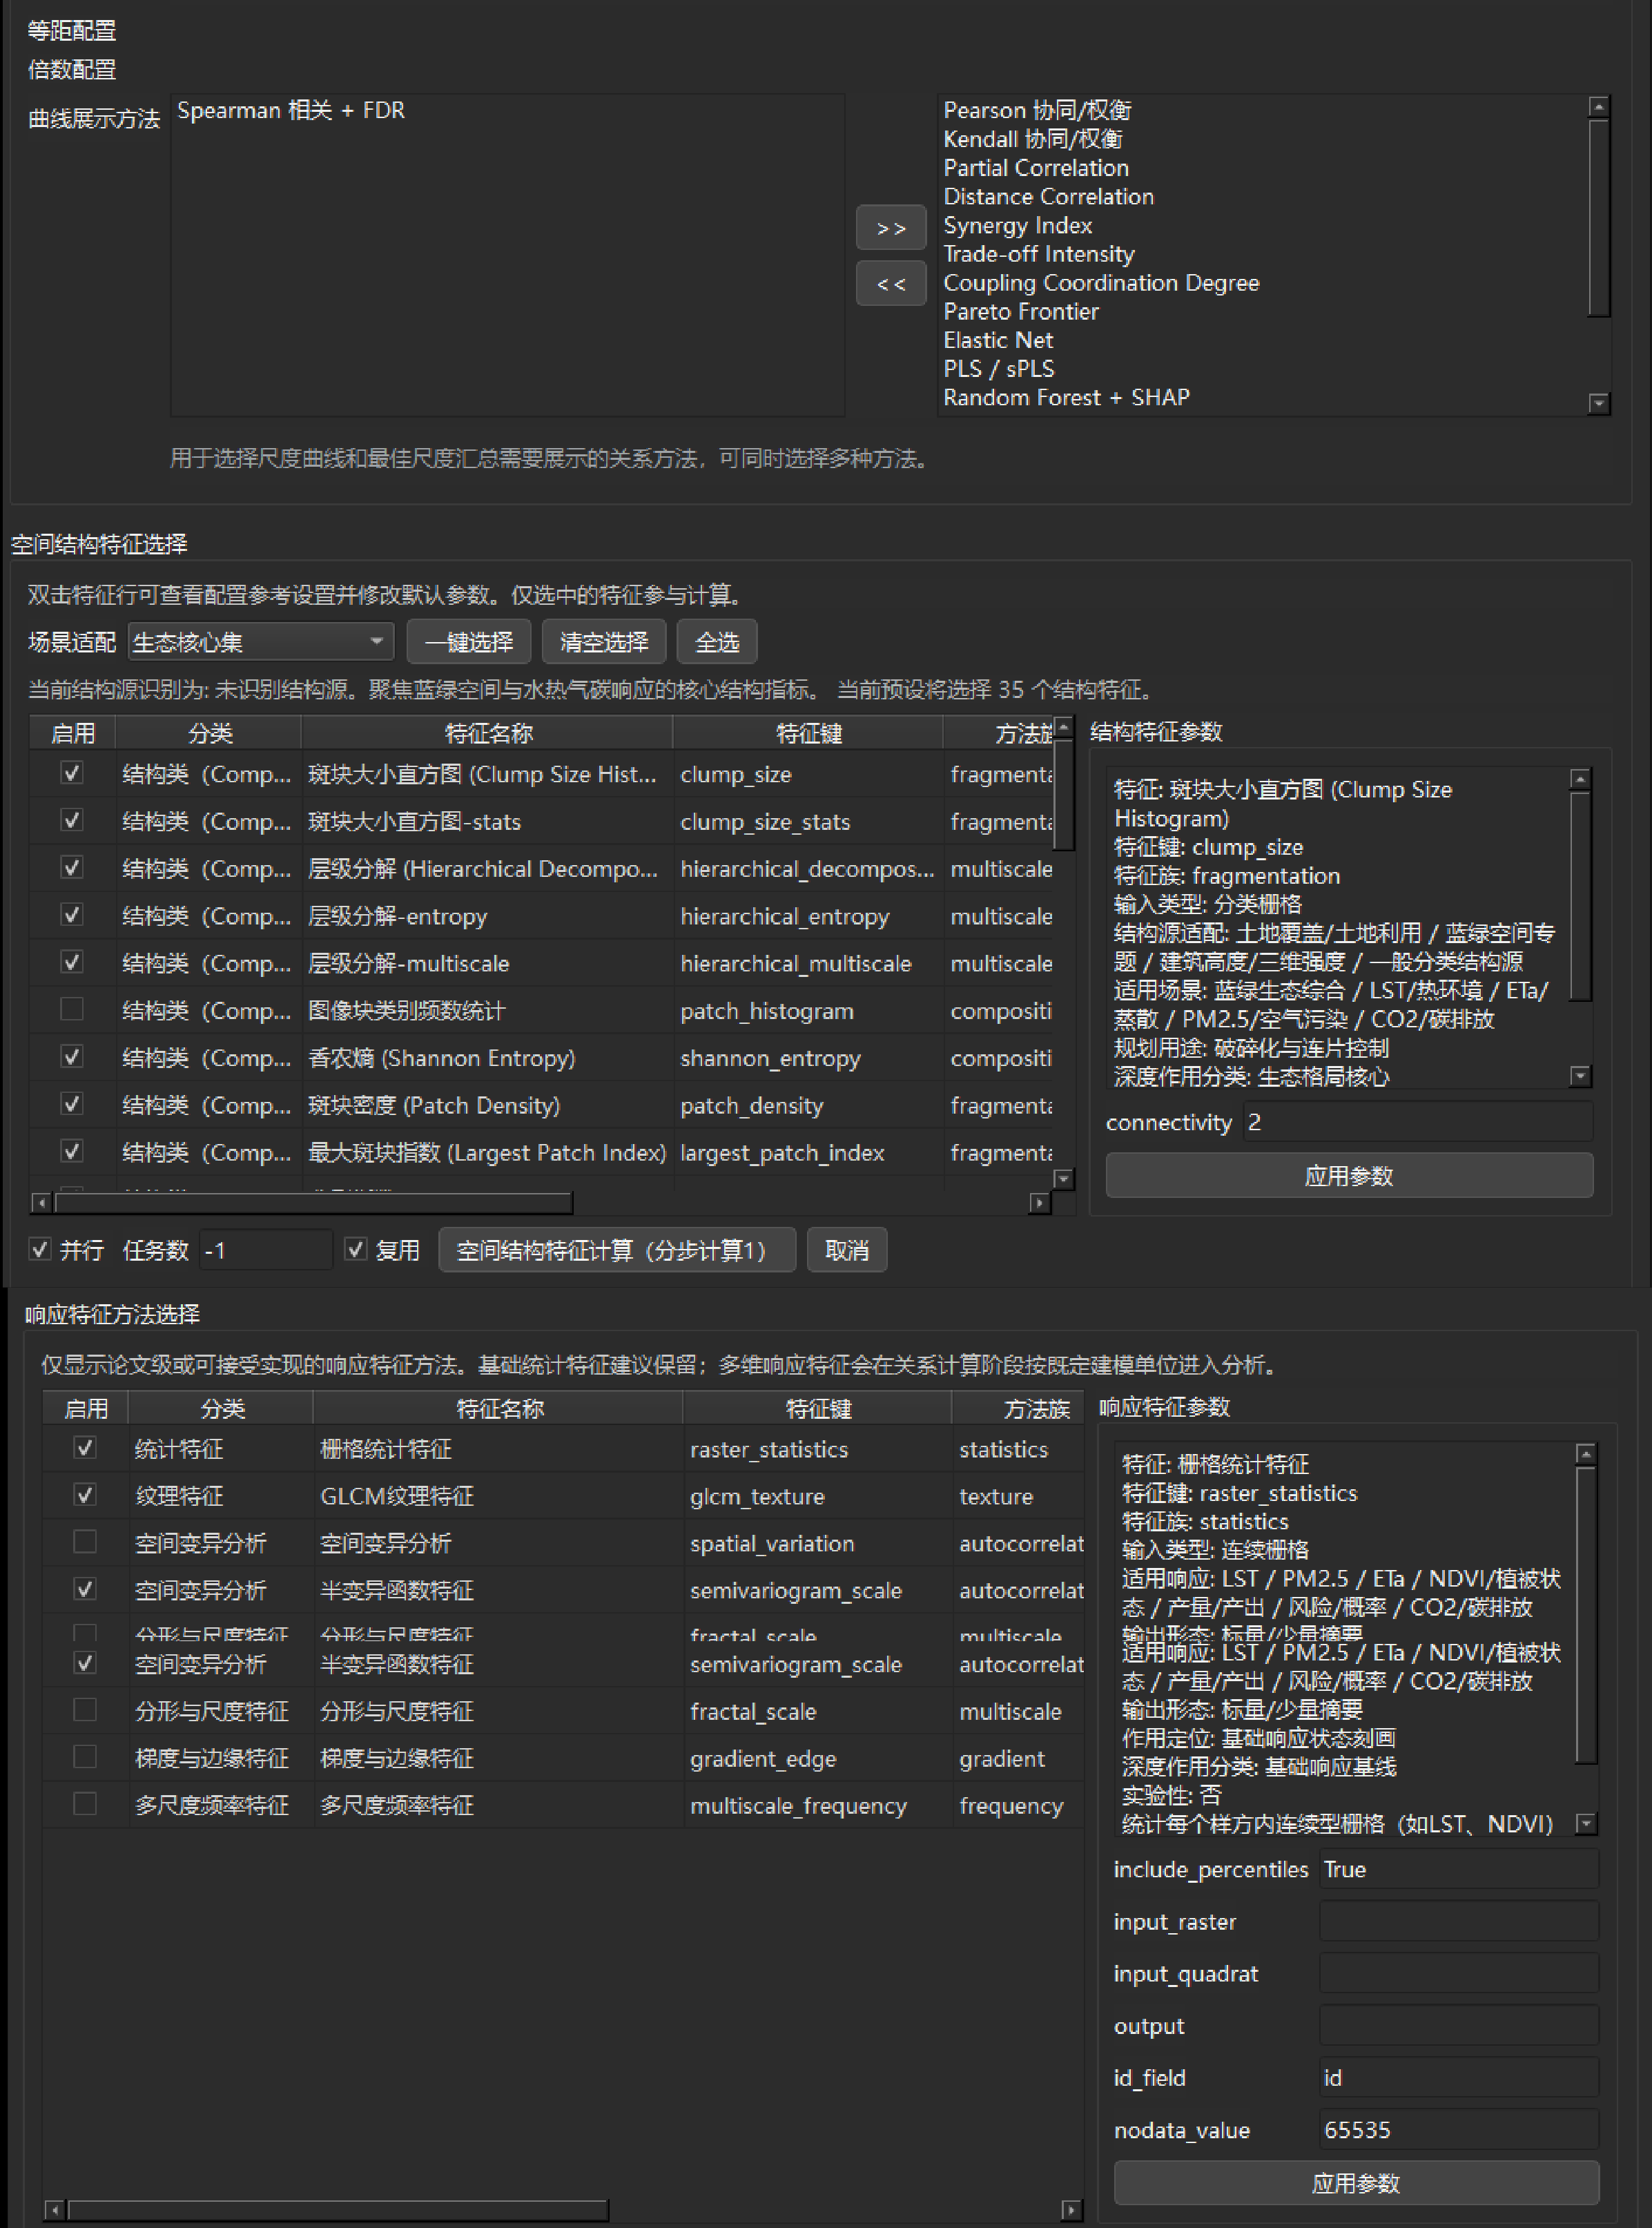
图 D-38 控制变量与多目标统计单元尺度完整配置:多源数据、规则网格、特征、方法、性能与阶段化运行(第 2/3 部分)
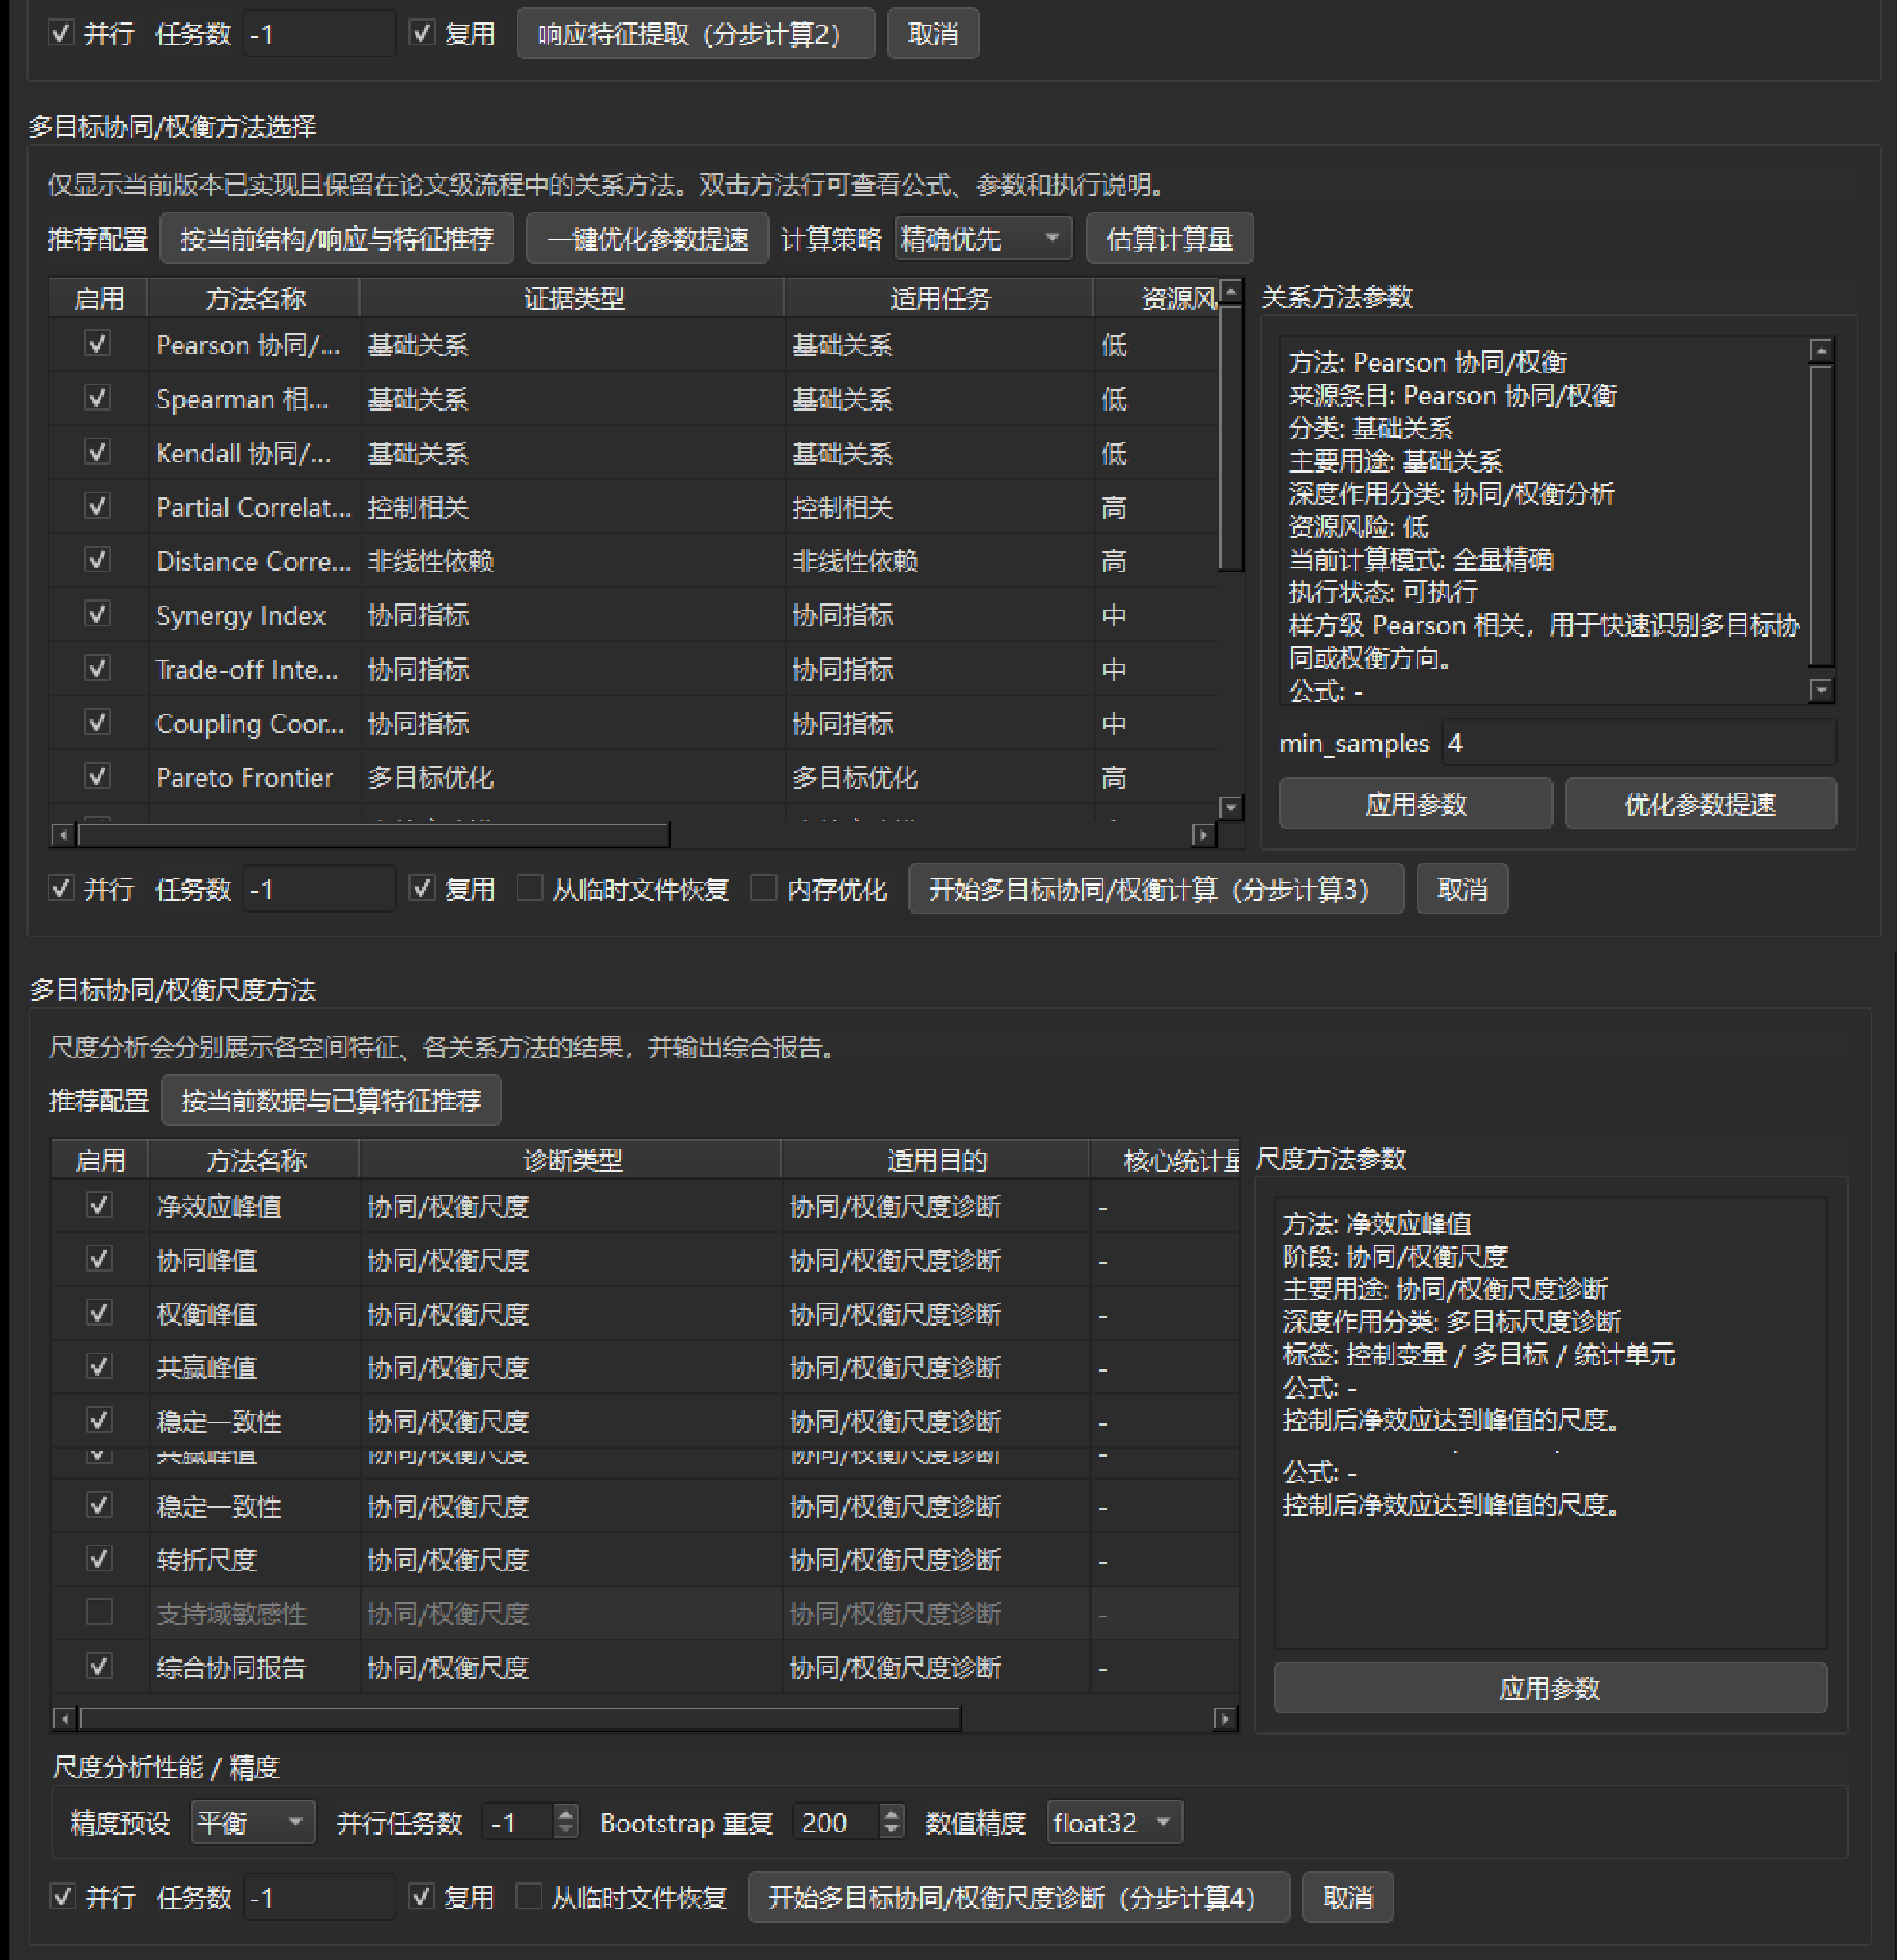
图 D-38 控制变量与多目标统计单元尺度完整配置:多源数据、规则网格、特征、方法、性能与阶段化运行(第 3/3 部分)
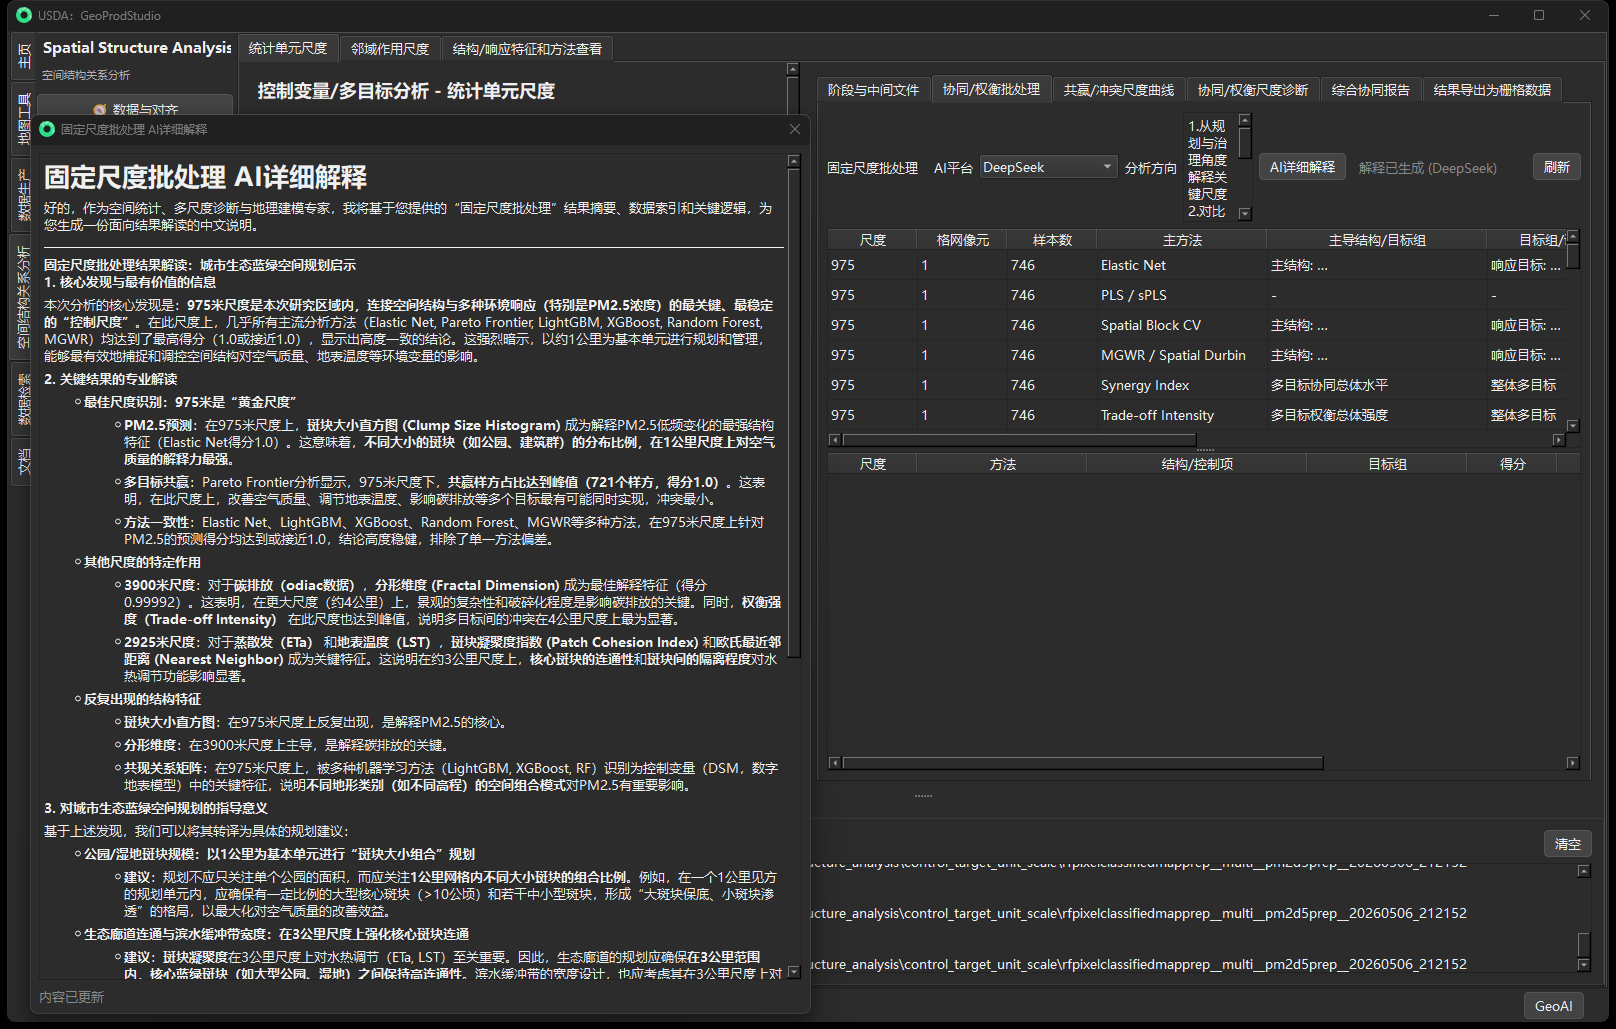
图 D-39 统计单元尺度固定尺度分析:净效应、多目标指数、帕累托共赢与模型结果
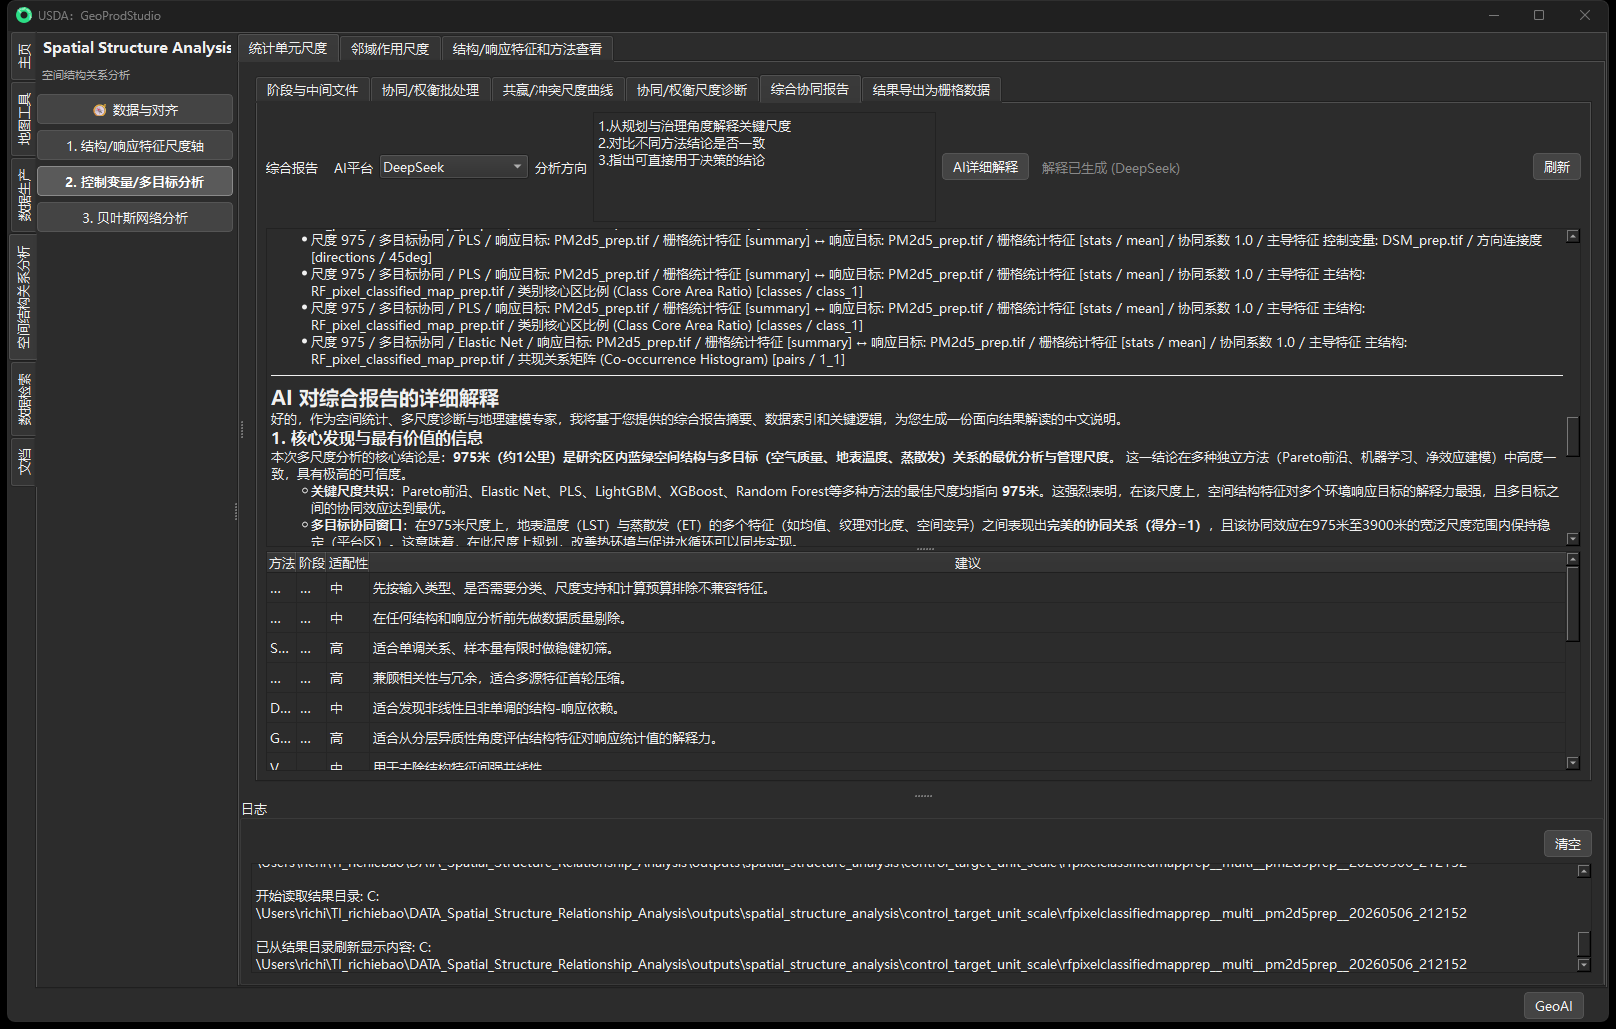
图 D-40 统计单元尺度综合协同报告:最佳尺度、净效应、协同与权衡、主导因素和方法结论
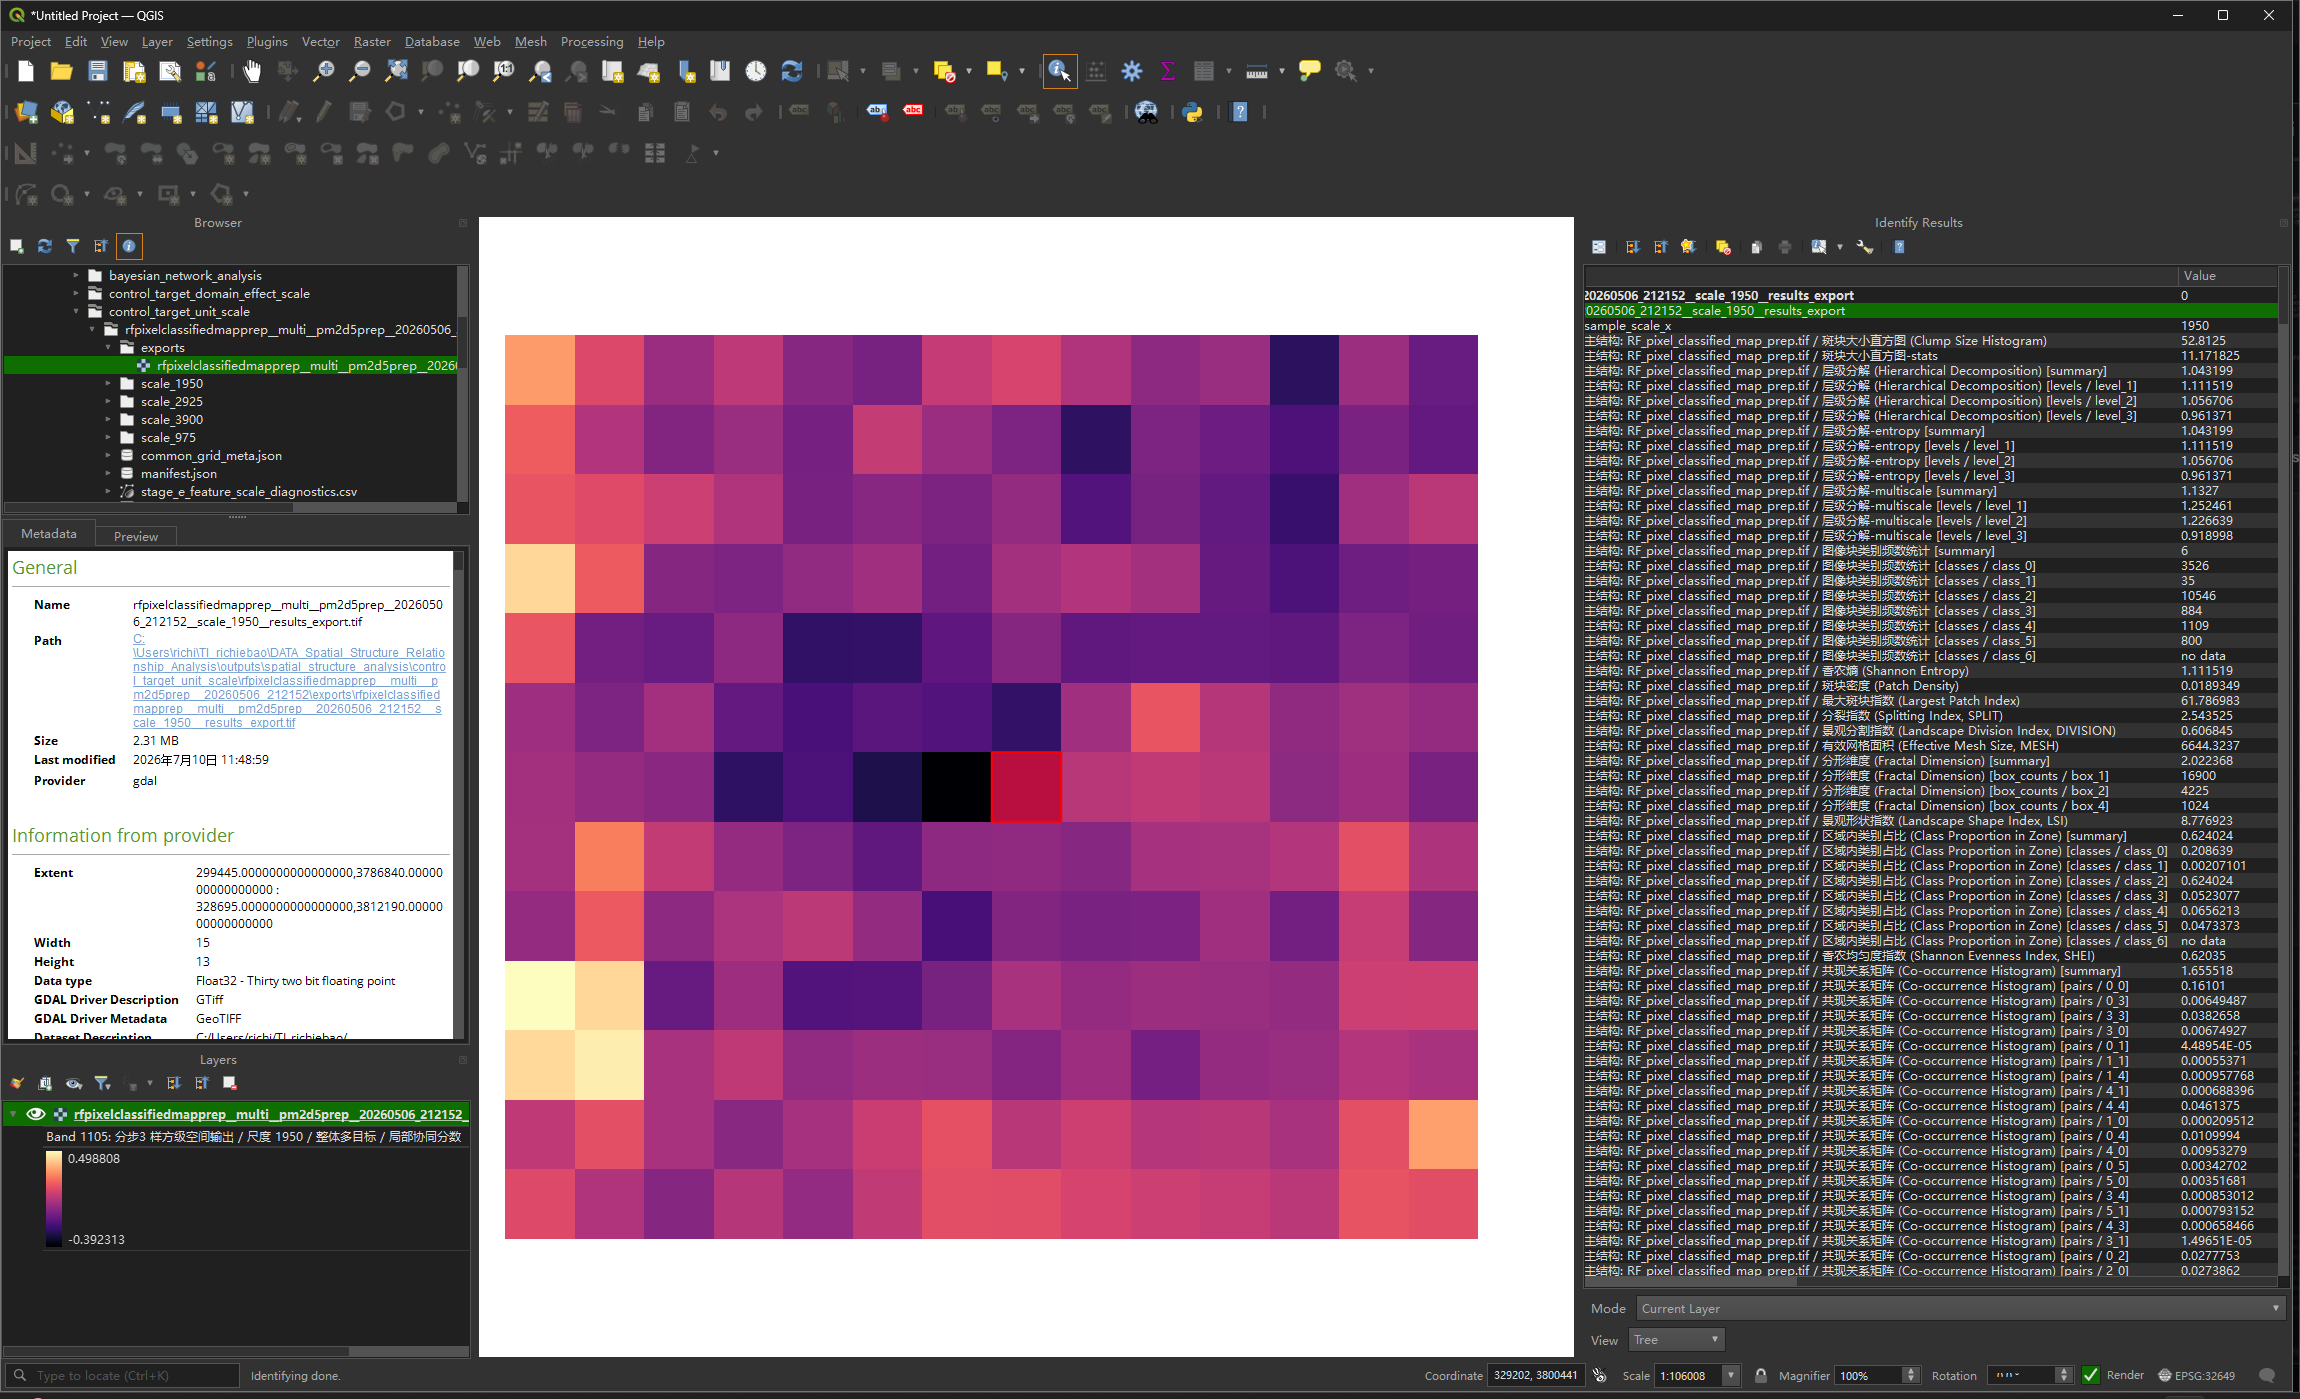
图 D-41 统计单元尺度多波段空间结果:净效应、协同与权衡及空间模型字段
D.3.4 控制变量/多目标分析—邻域作用尺度
先展示邻域作用尺度完整配置,随后按阶段与中间文件、协同/权衡批处理、共赢/冲突尺度曲线、尺度诊断、综合协同报告、结果导出及导出成果示例的页签顺序排列。
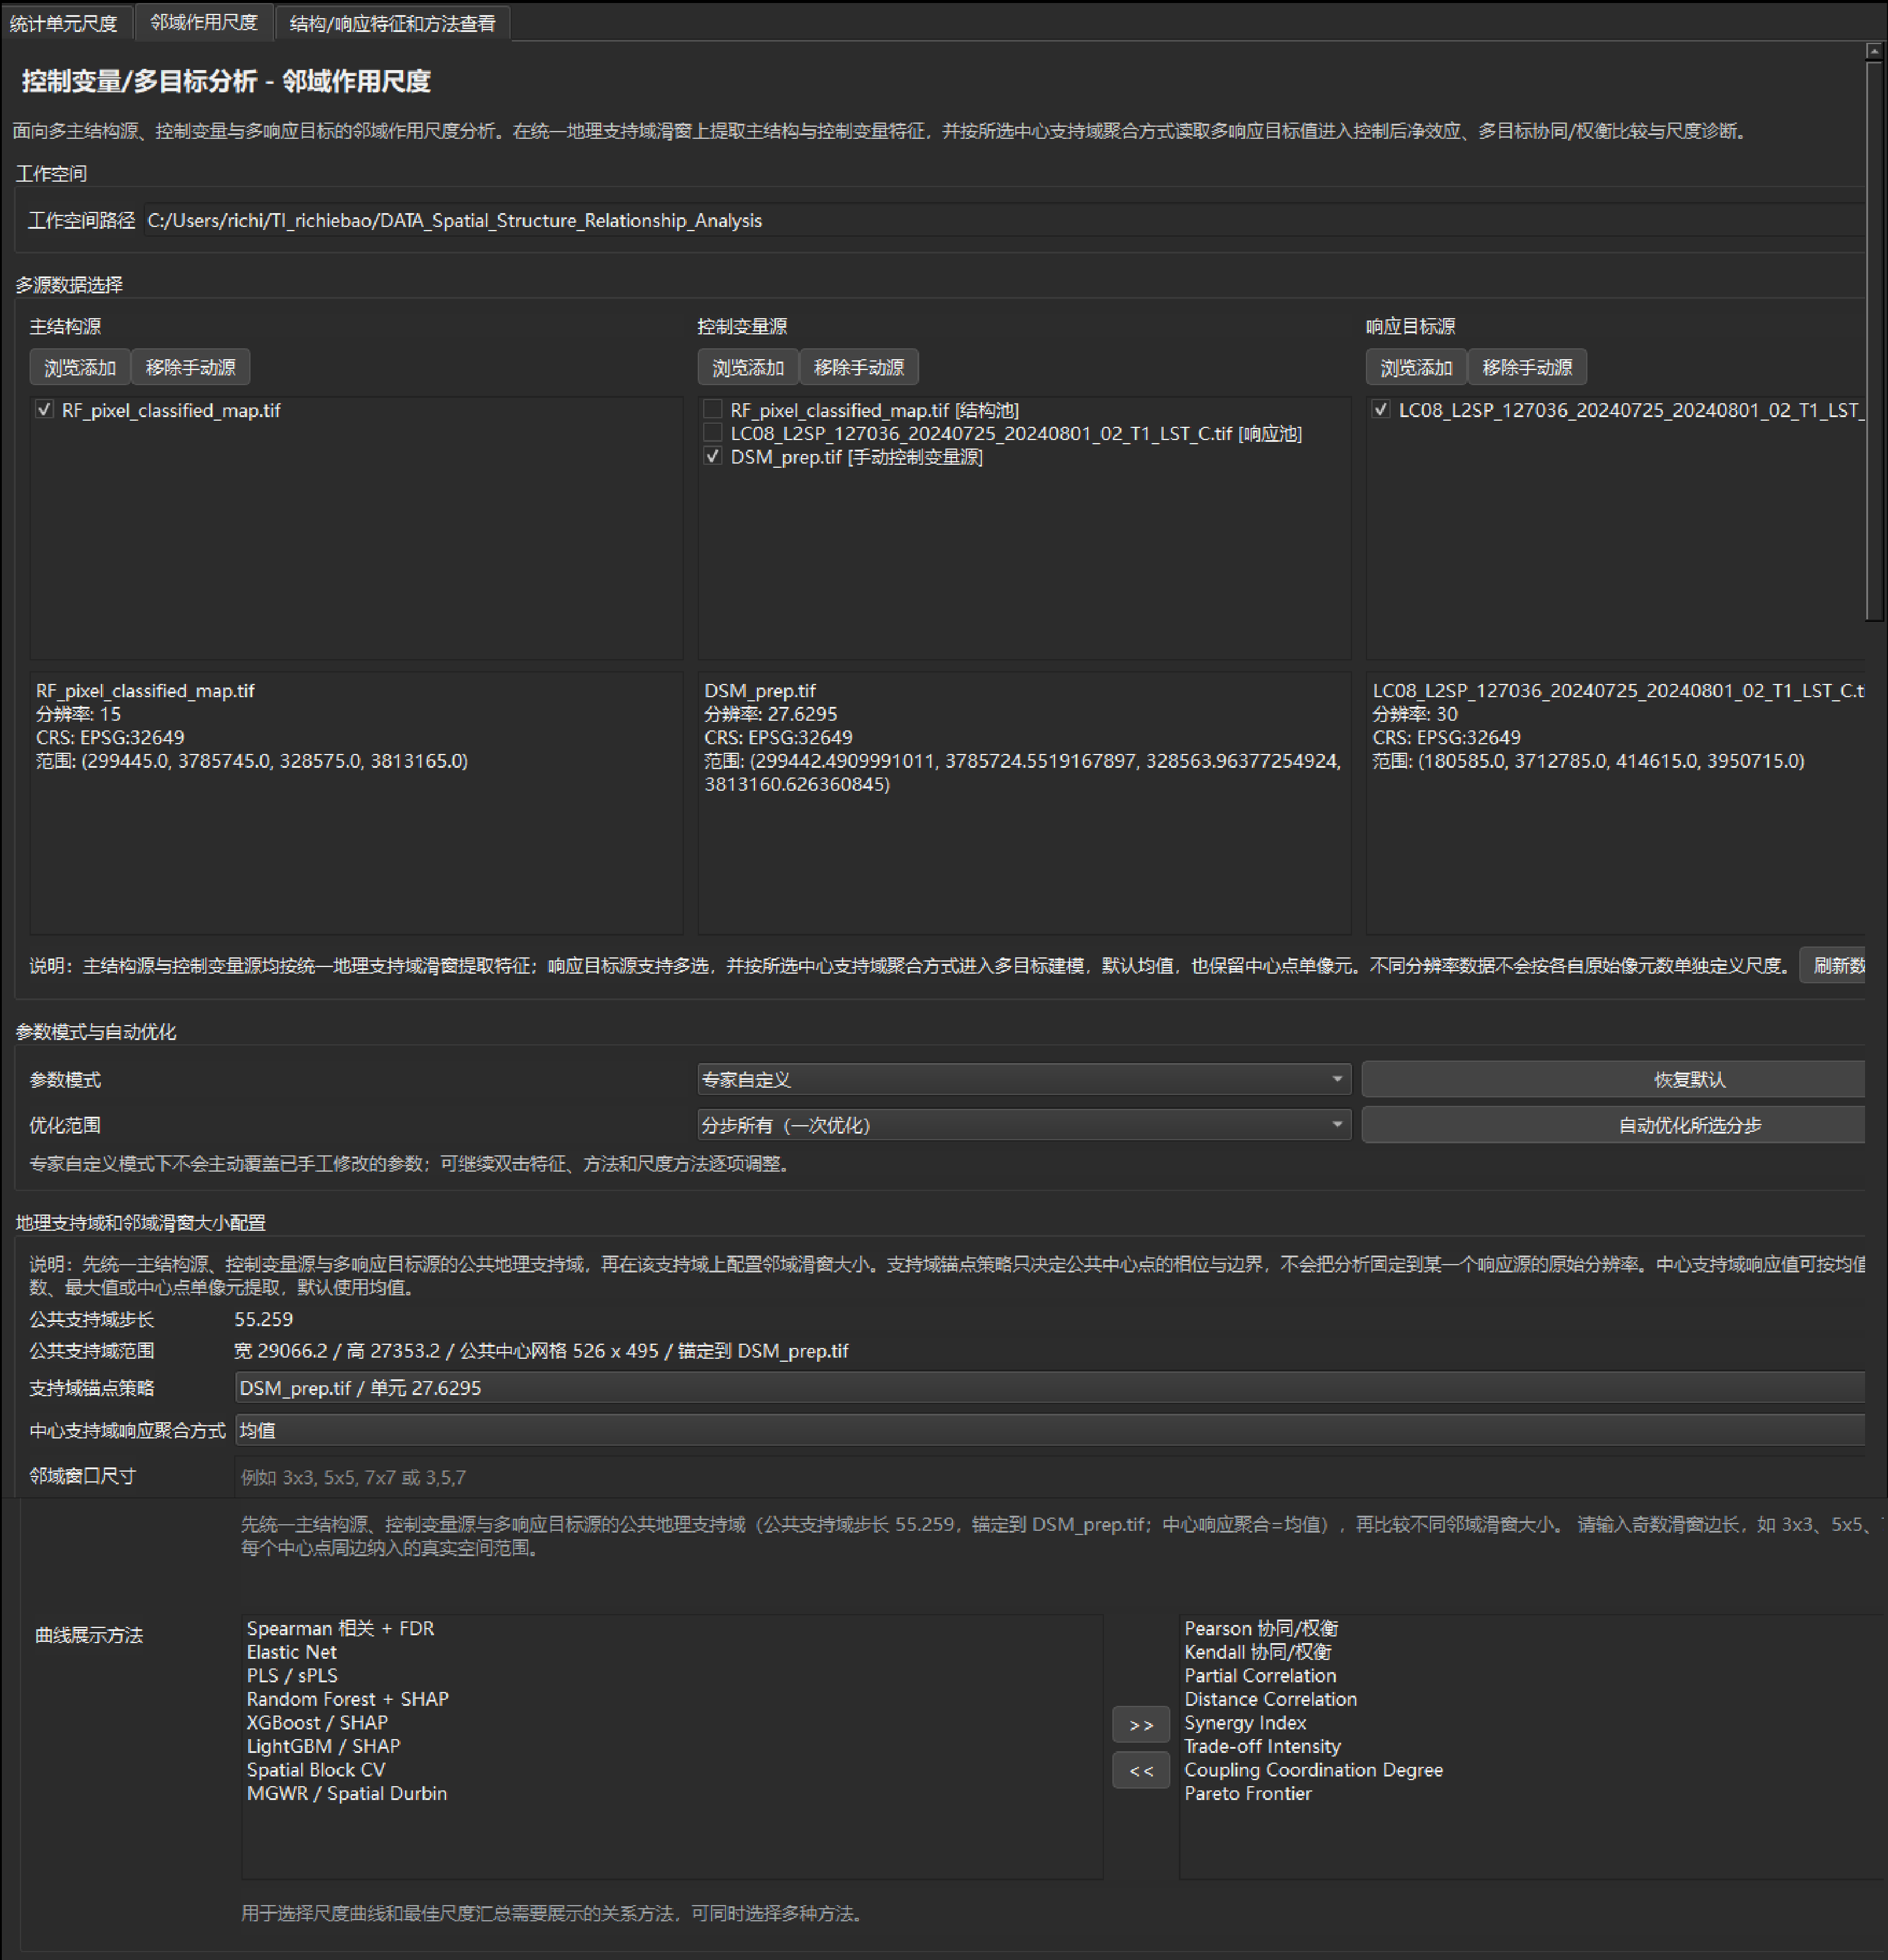
图 D-42 控制变量与多目标邻域作用尺度完整配置:主结构、控制变量、响应目标、中心响应聚合与窗口序列(第 1/2 部分)
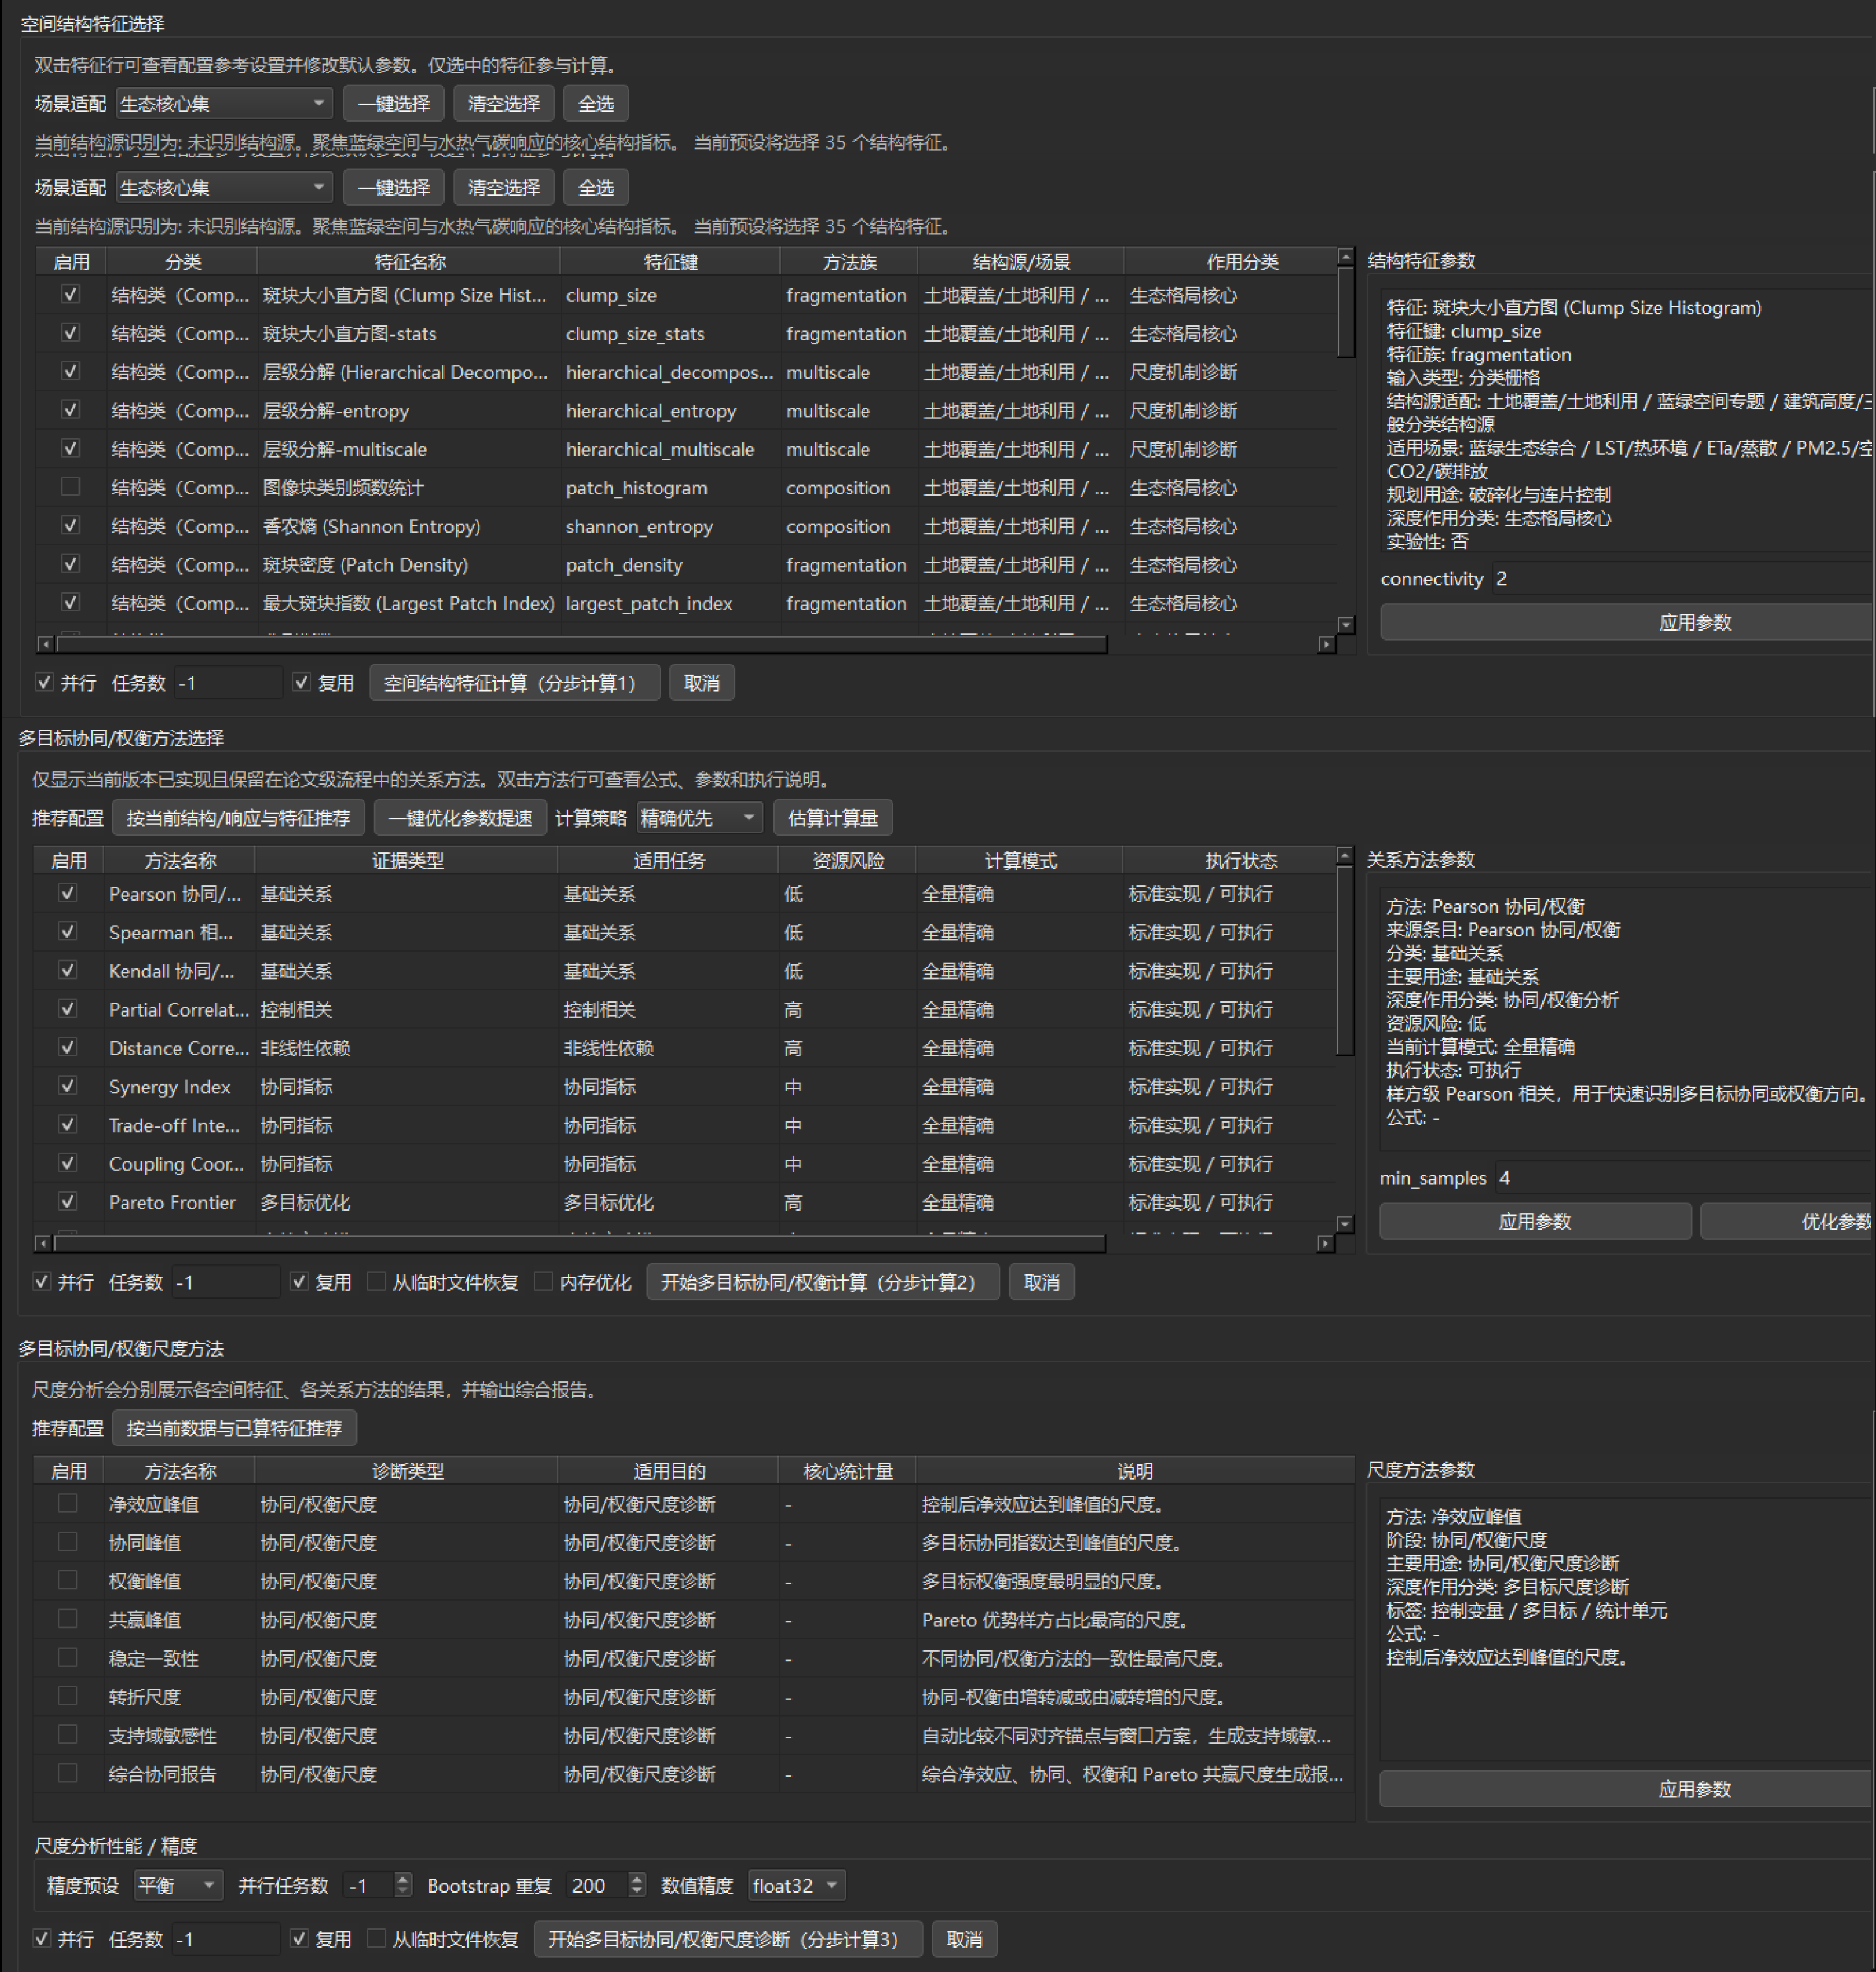
图 D-42 控制变量与多目标邻域作用尺度完整配置:主结构、控制变量、响应目标、中心响应聚合与窗口序列(第 2/2 部分)
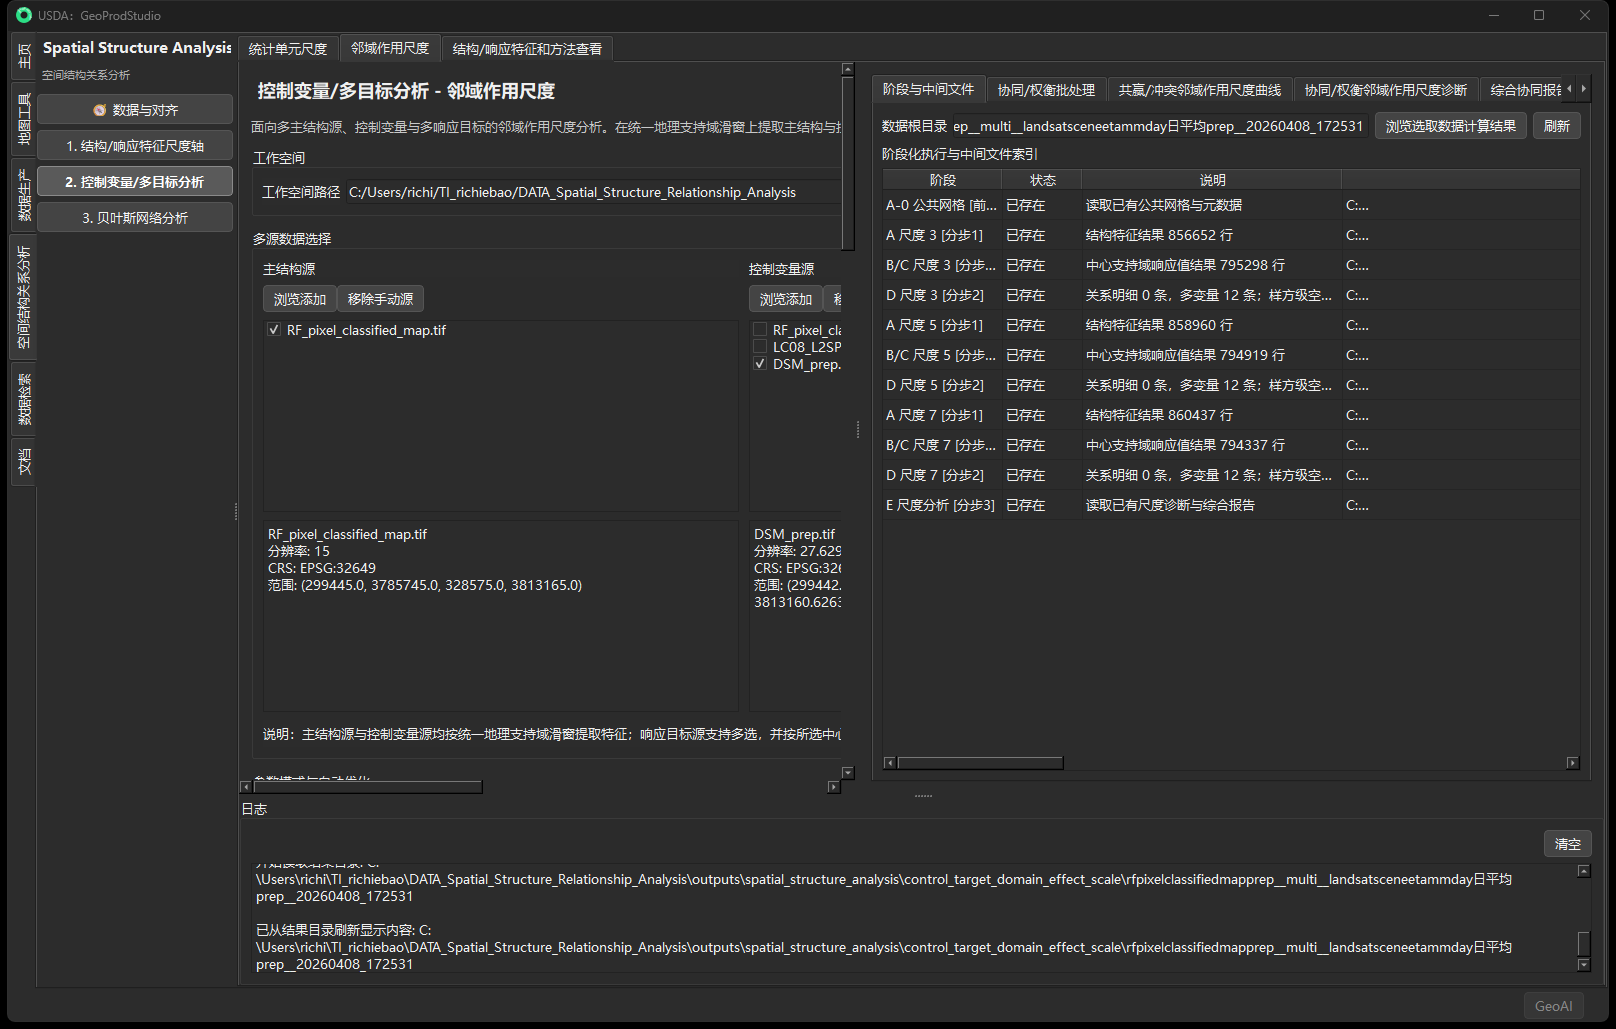
图 D-43 邻域作用尺度主界面与阶段结果:公共支持域及多窗口净效应和协同与权衡比较
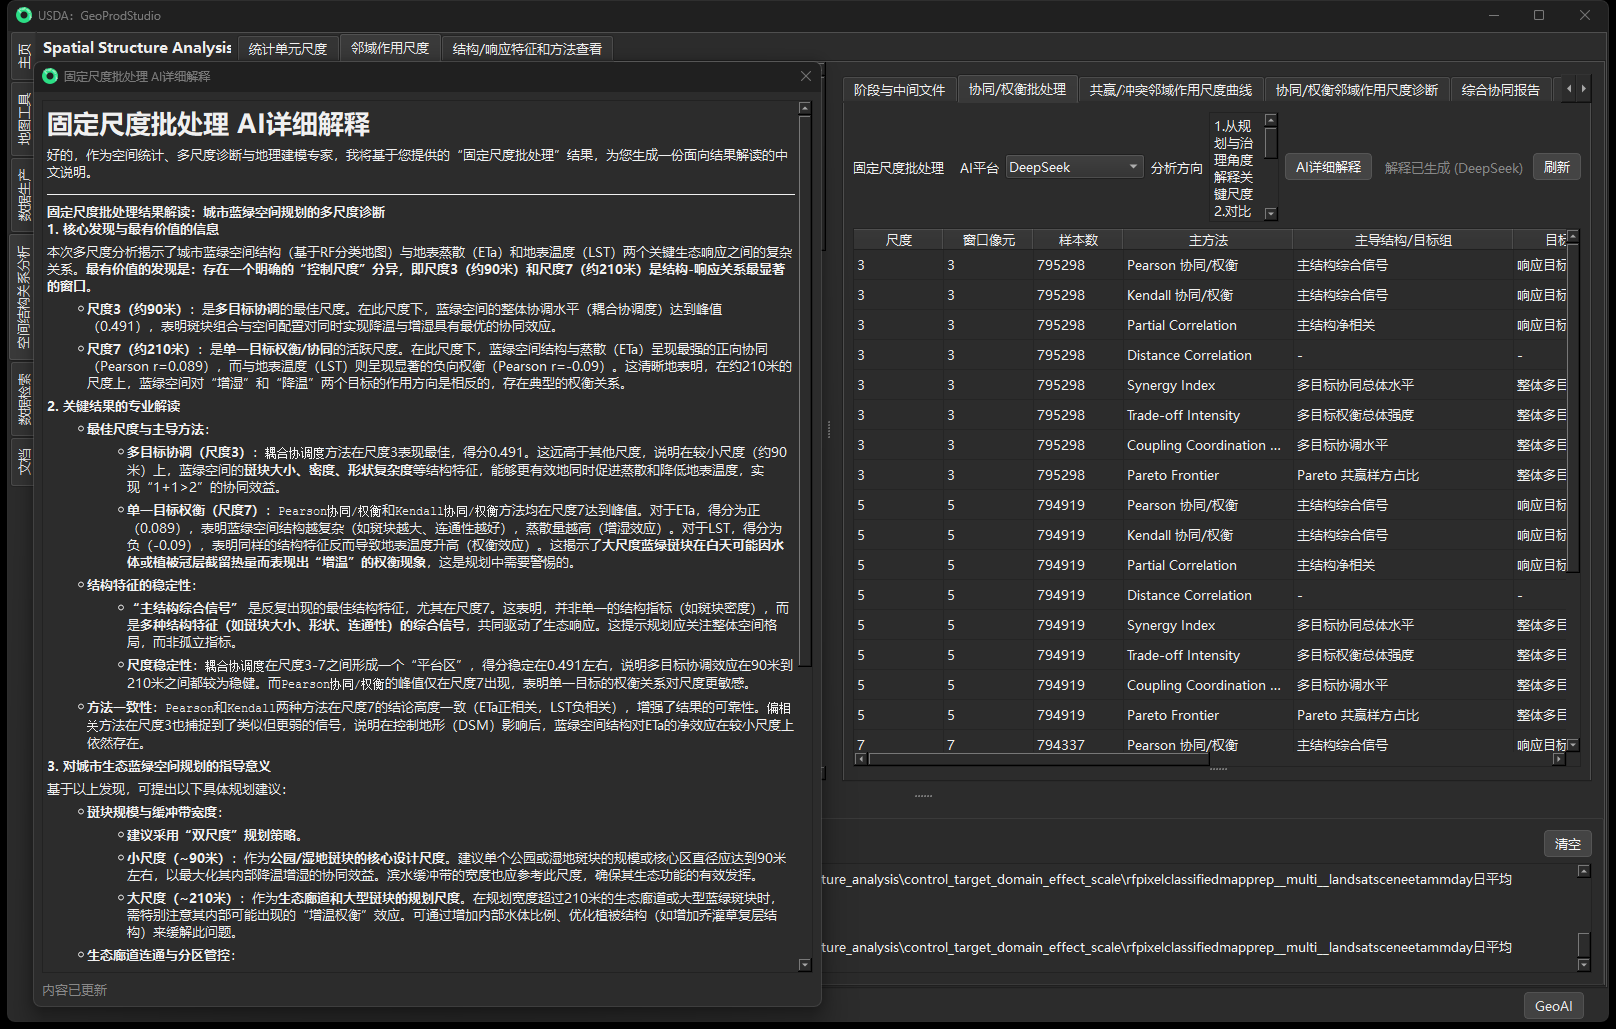
图 D-44 邻域作用尺度固定窗口批处理:协同、权衡与控制后结果比较
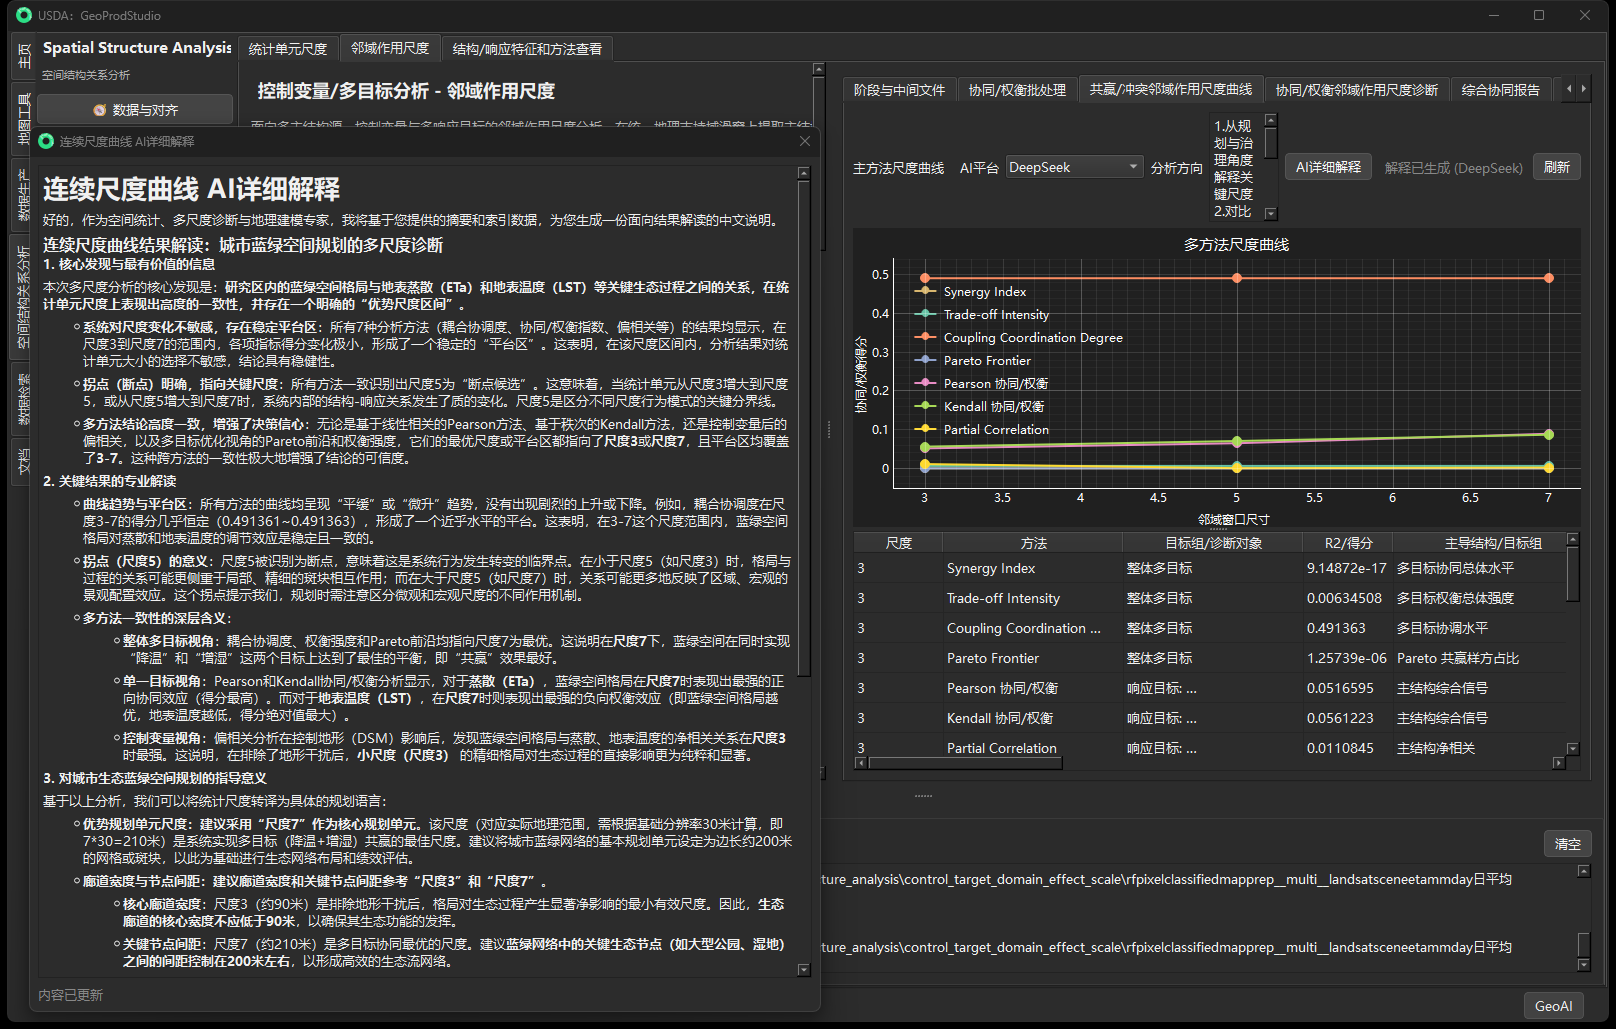
图 D-45 邻域作用尺度共赢与冲突曲线:局地至较大邻域的协同与权衡变化
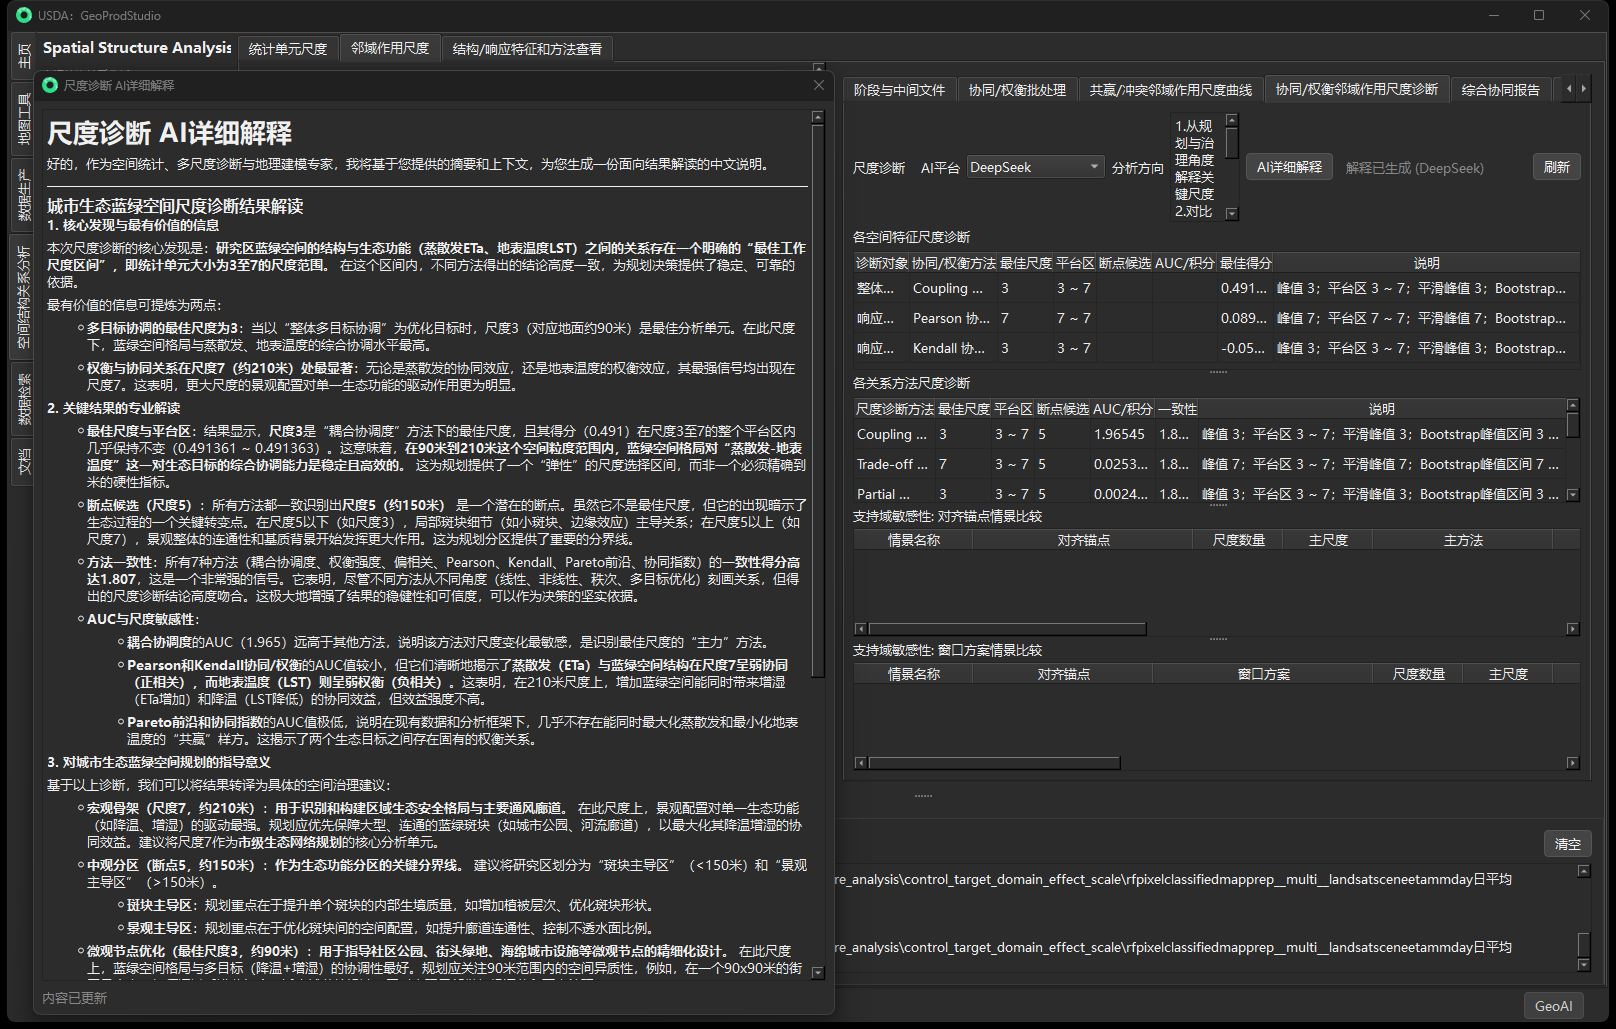
图 D-46 邻域作用尺度协同与权衡诊断:净效应、协同、权衡和共赢峰值及窗口转折
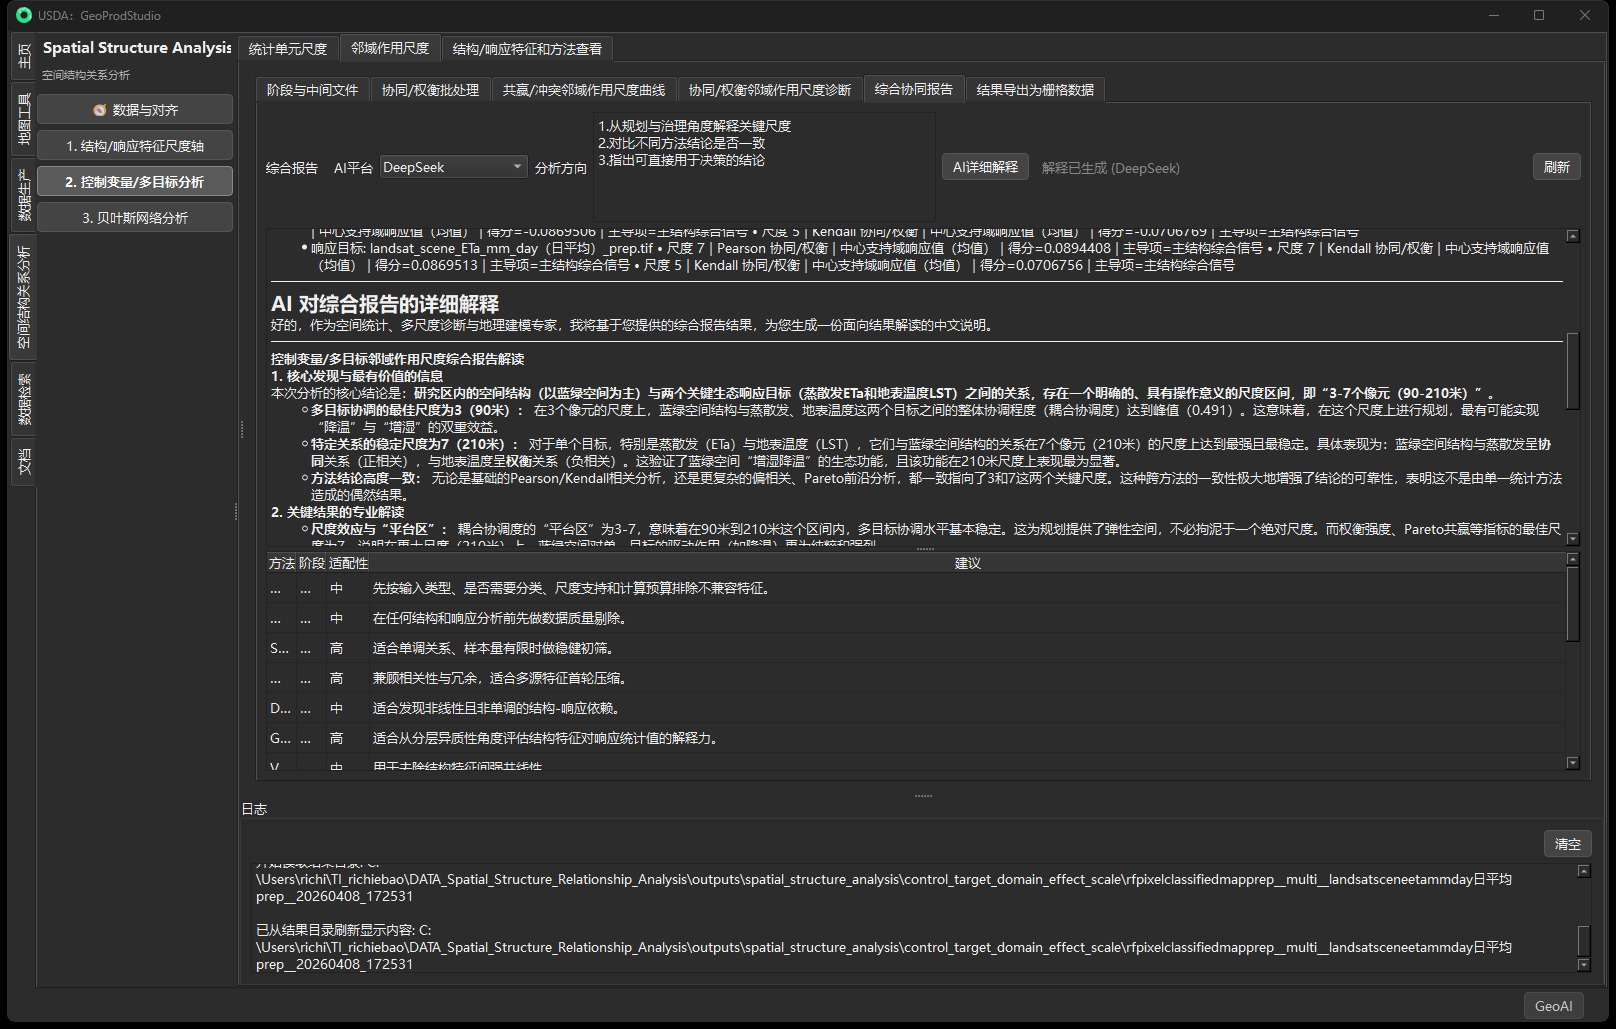
图 D-47 邻域作用尺度综合协同报告:多目标结论、支持域与窗口稳健性汇总
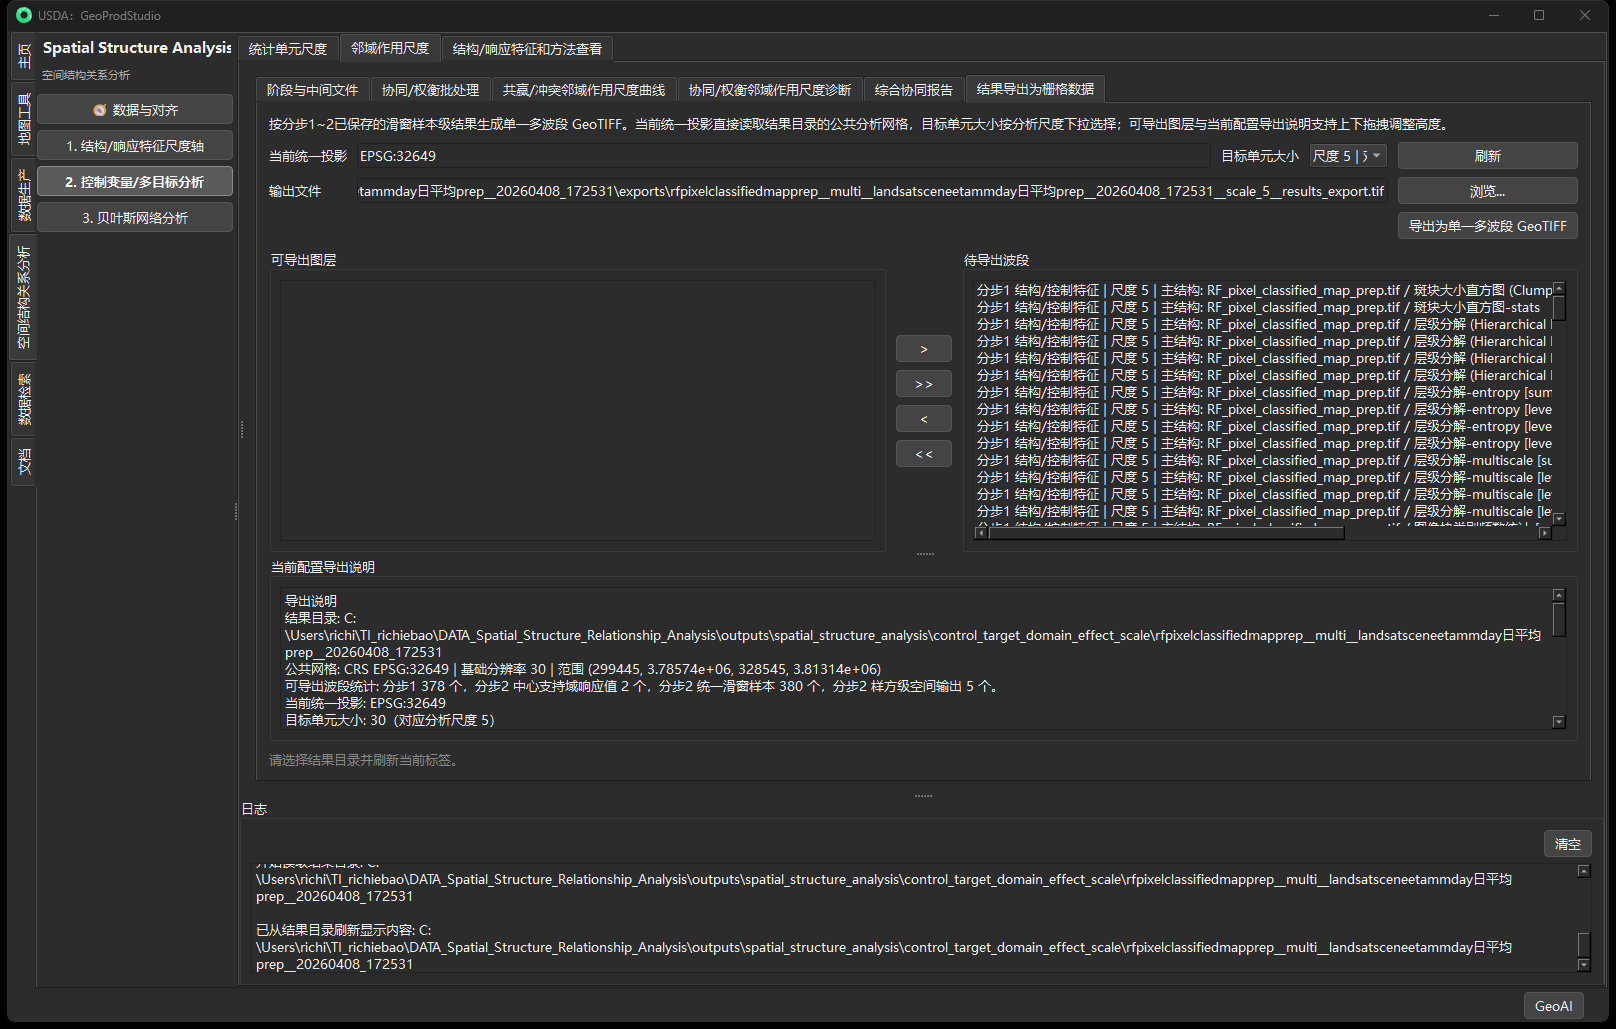
图 D-48 控制变量与多目标邻域作用结果导出:按目标窗口和公共中心网格回写空间结果
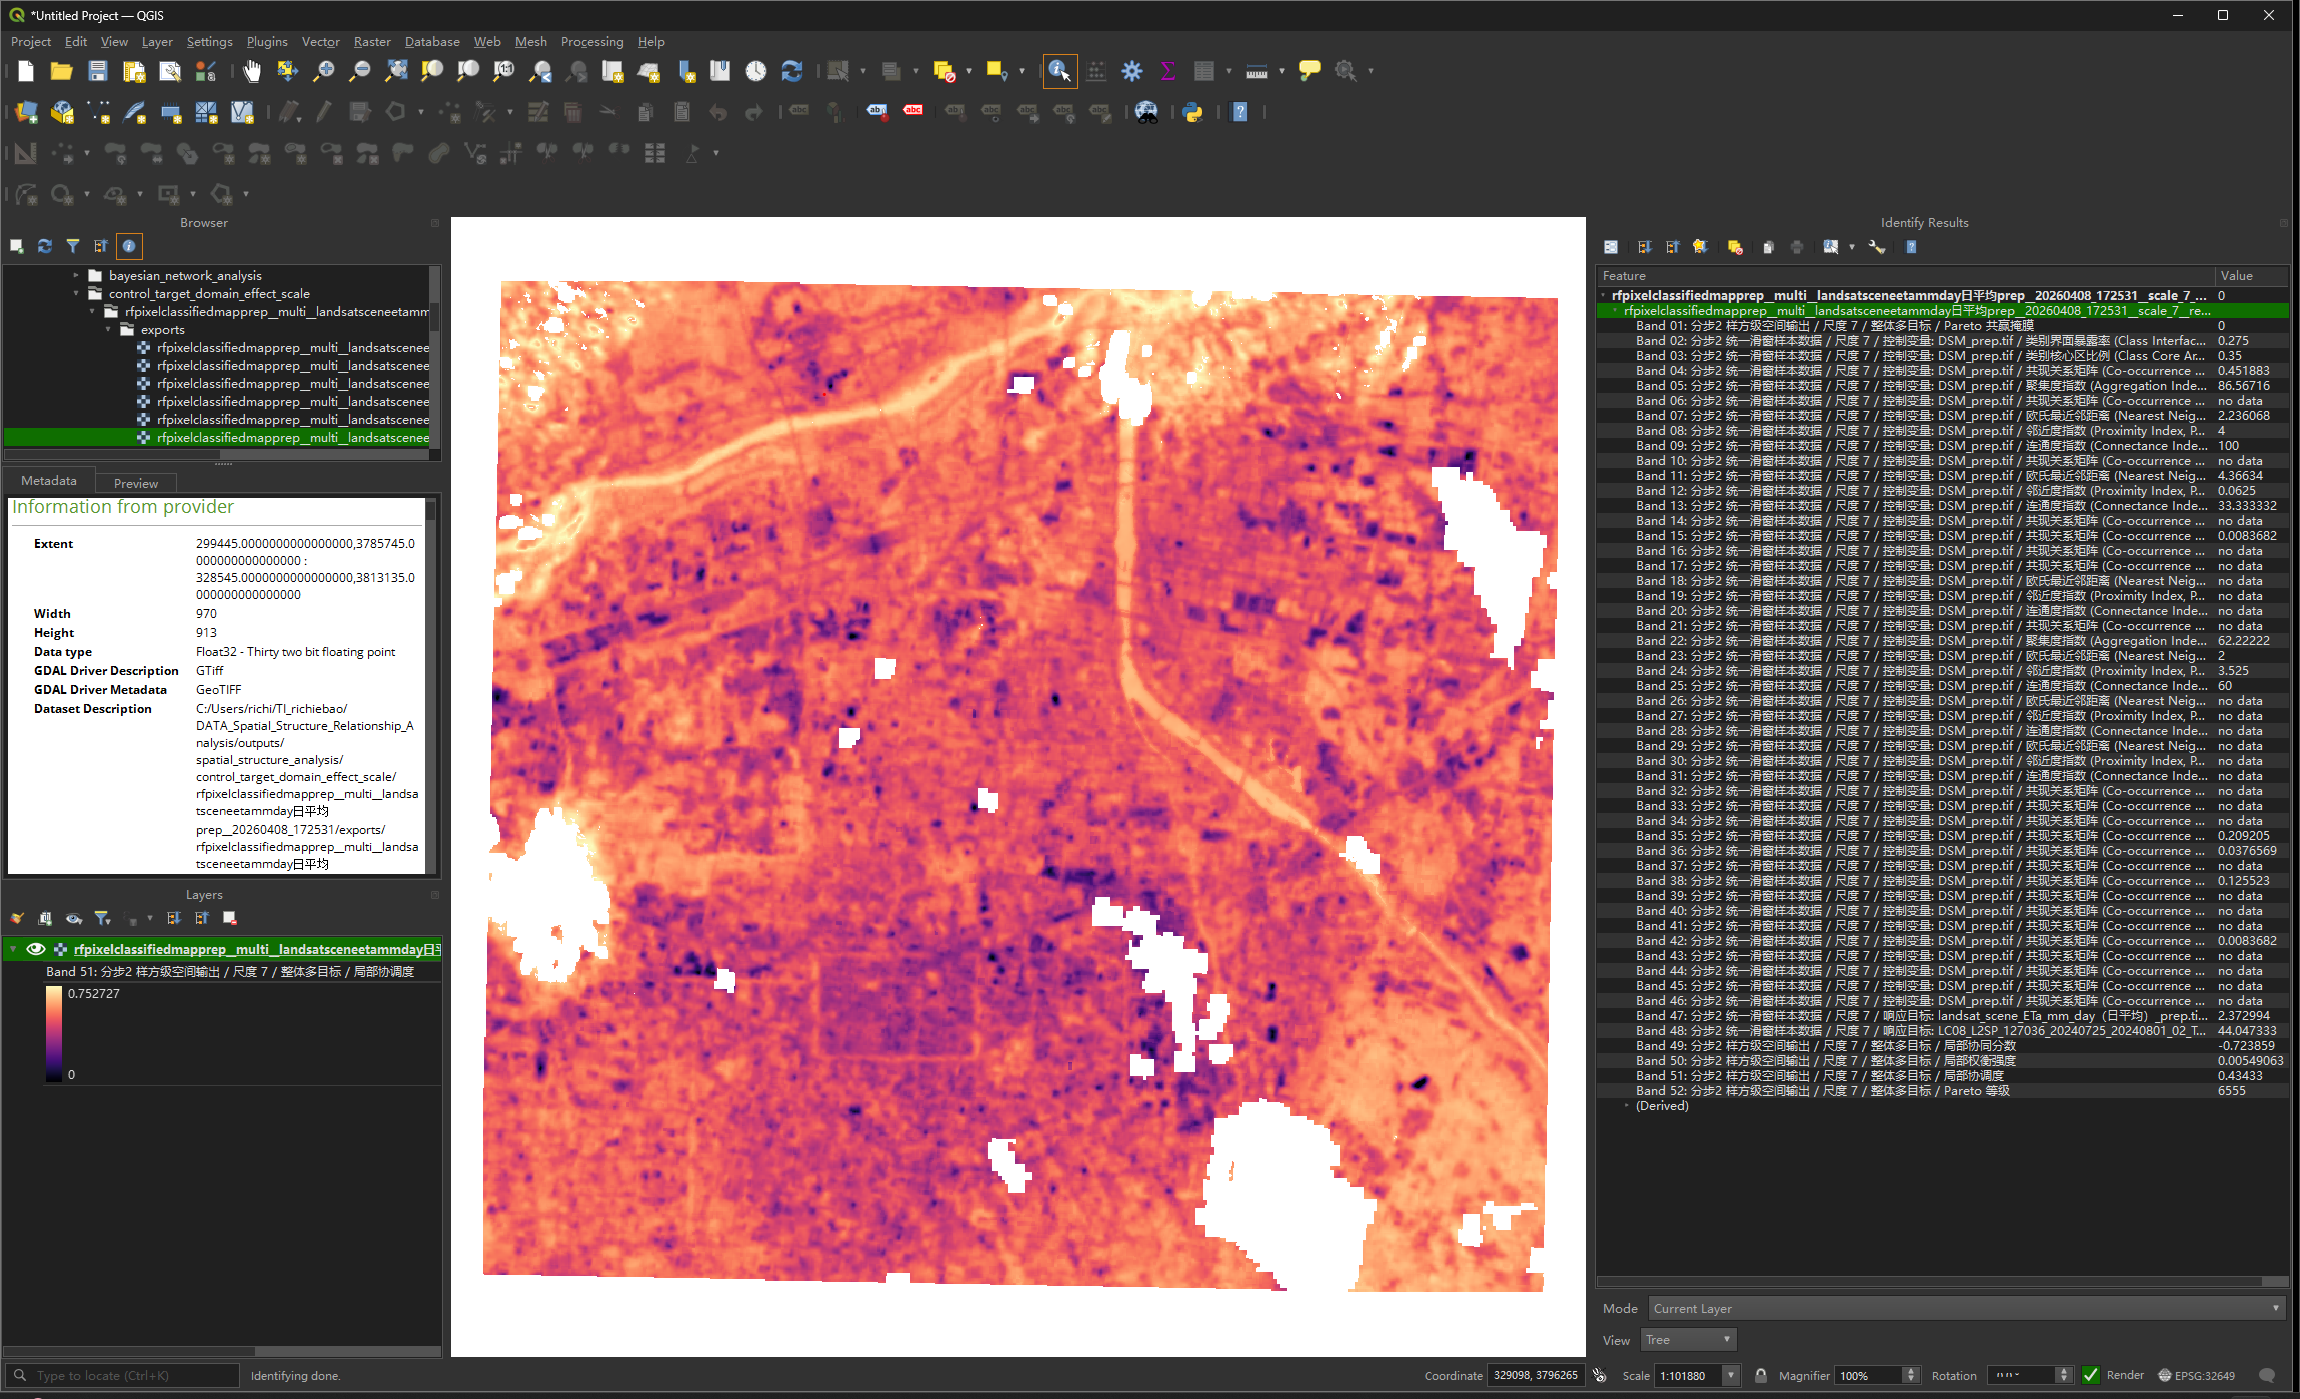
图 D-49 邻域作用尺度多波段空间结果:局部协同、权衡、耦合协调度、帕累托共赢与净效应
D.3.5 贝叶斯网络分析
贝叶斯网络结果按右侧页签从左到右排列;本附录依次展示马尔可夫毯、条件概率表和综合报告,其余页签截图已在正文展示。
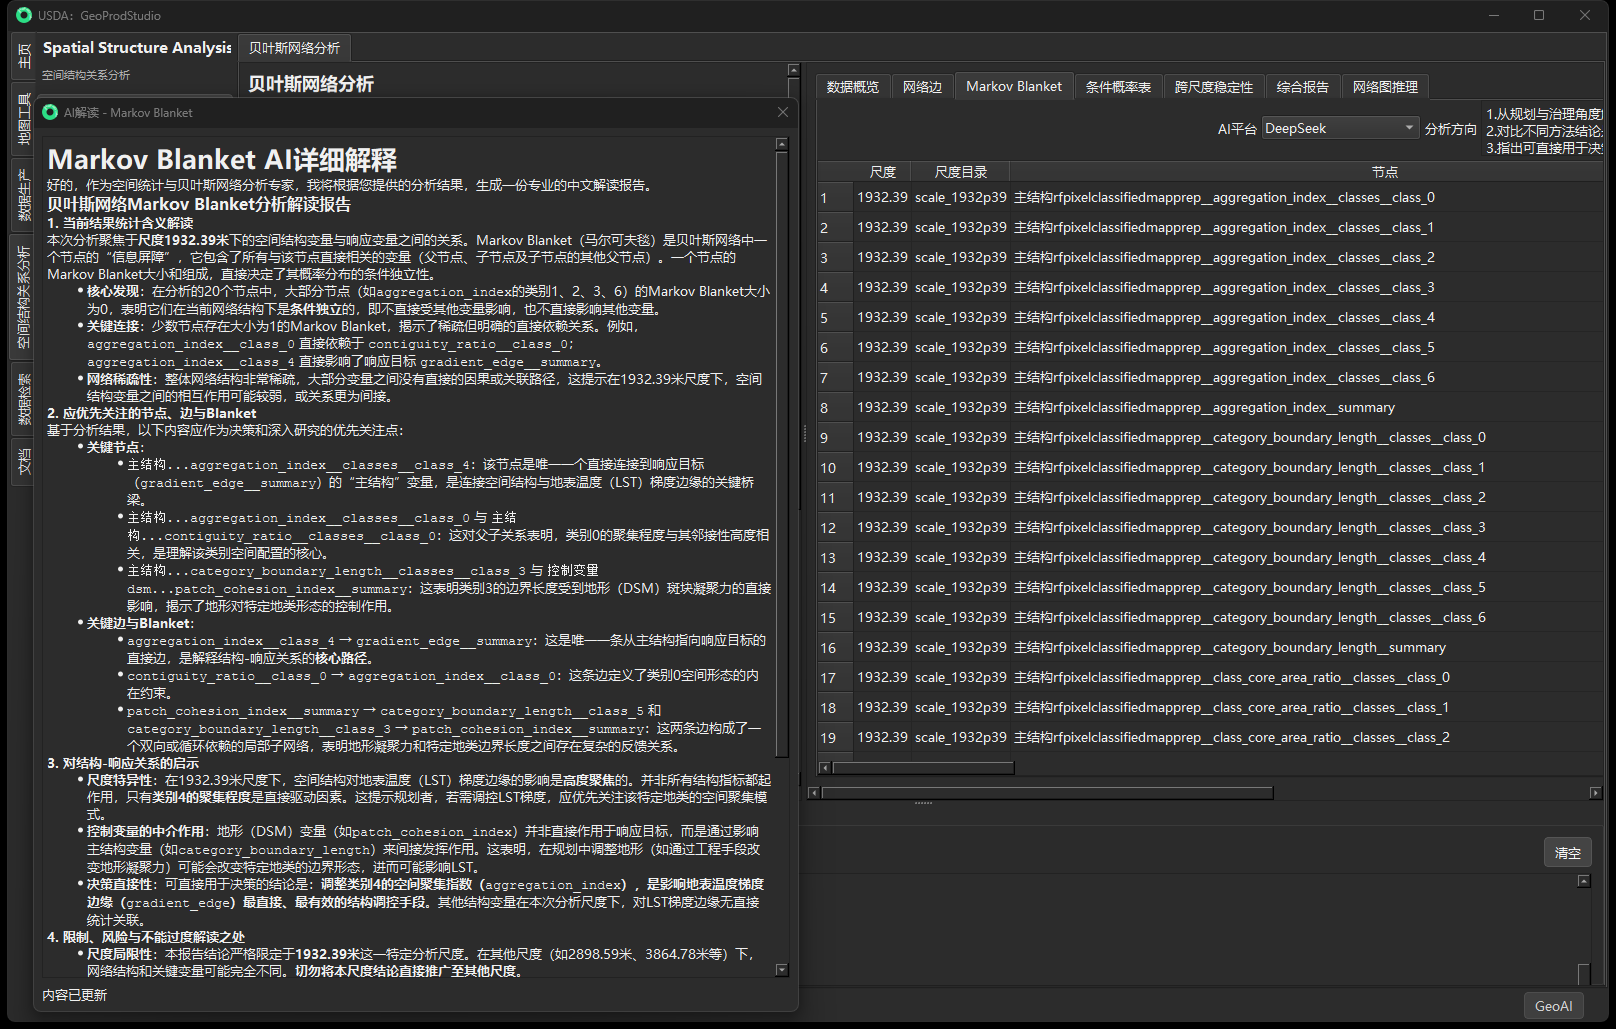
图 D-50 贝叶斯网络马尔可夫毯:父节点、子节点、配偶节点及毯集规模
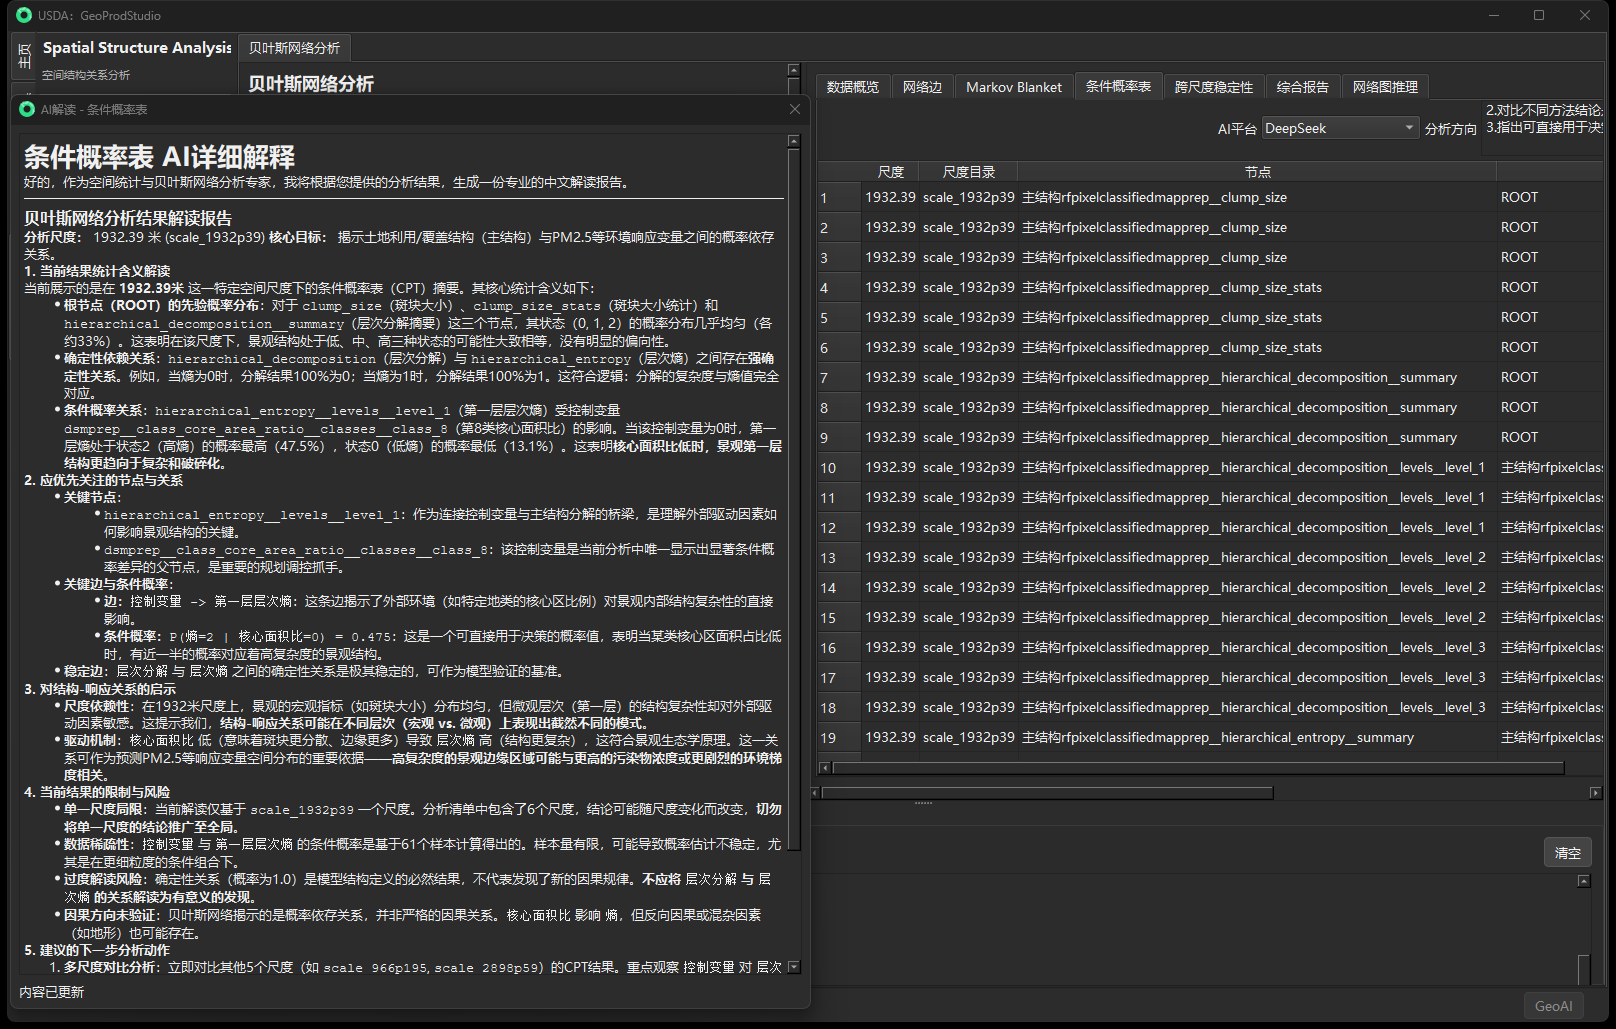
图 D-51 贝叶斯网络条件概率表:尺度、节点、父节点状态、节点状态、计数与观测概率
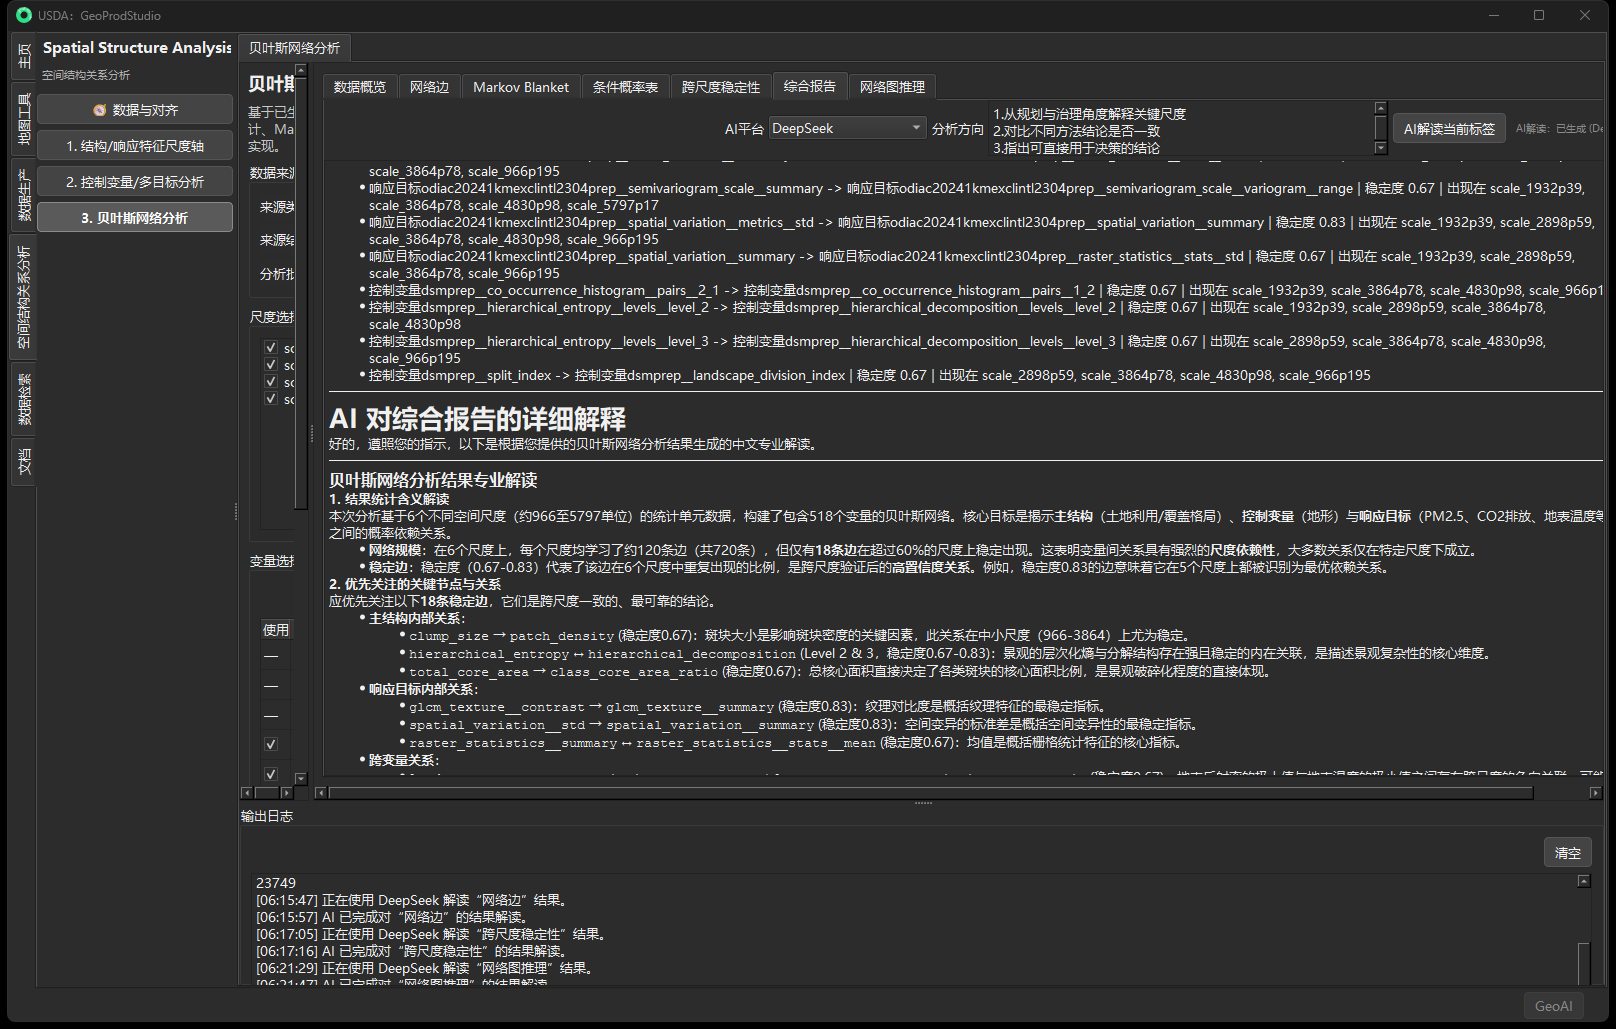
图 D-52 贝叶斯网络综合报告:尺度、变量、边、稳定边与关键关系汇总
D.4 数据检索
本节按数据检索顶部页签从左到右排列,先展示数据库管理,再展示按数据类型检索。
D.4.1 数据库
数据库截图按 NumPy 压缩数组、栅格和矢量数据的预览对象连续排列。
图 D-53 地理信息数据库管理:NumPy 压缩数组(NPZ)特征包内容预览
图 D-54 地理信息数据库管理:栅格数据地图预览
图 D-55 地理信息数据库管理:矢量数据地图预览
D.4.2 按数据类型检索
按数据类型检索截图依据应用分类配置,依次展示栅格数据、矢量数据以及配置与元数据类的模型评价报告。
图 D-56 按数据类型检索:栅格数据目录浏览与地图预览
图 D-57 按数据类型检索:矢量数据目录浏览与地图预览
图 D-58 按数据类型检索:模型评价报告元数据与内容预览
附录 E 软件著作权登记证明
本证书对应软件名称为“USDA-GeoProdStudio:遥感影像智能解译与分析系统”,登记版本为 V2.0.0。本文所述 USDA GeoProdStudio V3.5.0(发布日期:2026.10.08)在登记版本基础上持续迭代形成。本证书用于证明软件成果的历史登记基础及著作权归属,不将其登记版本改写为本次软件版本。
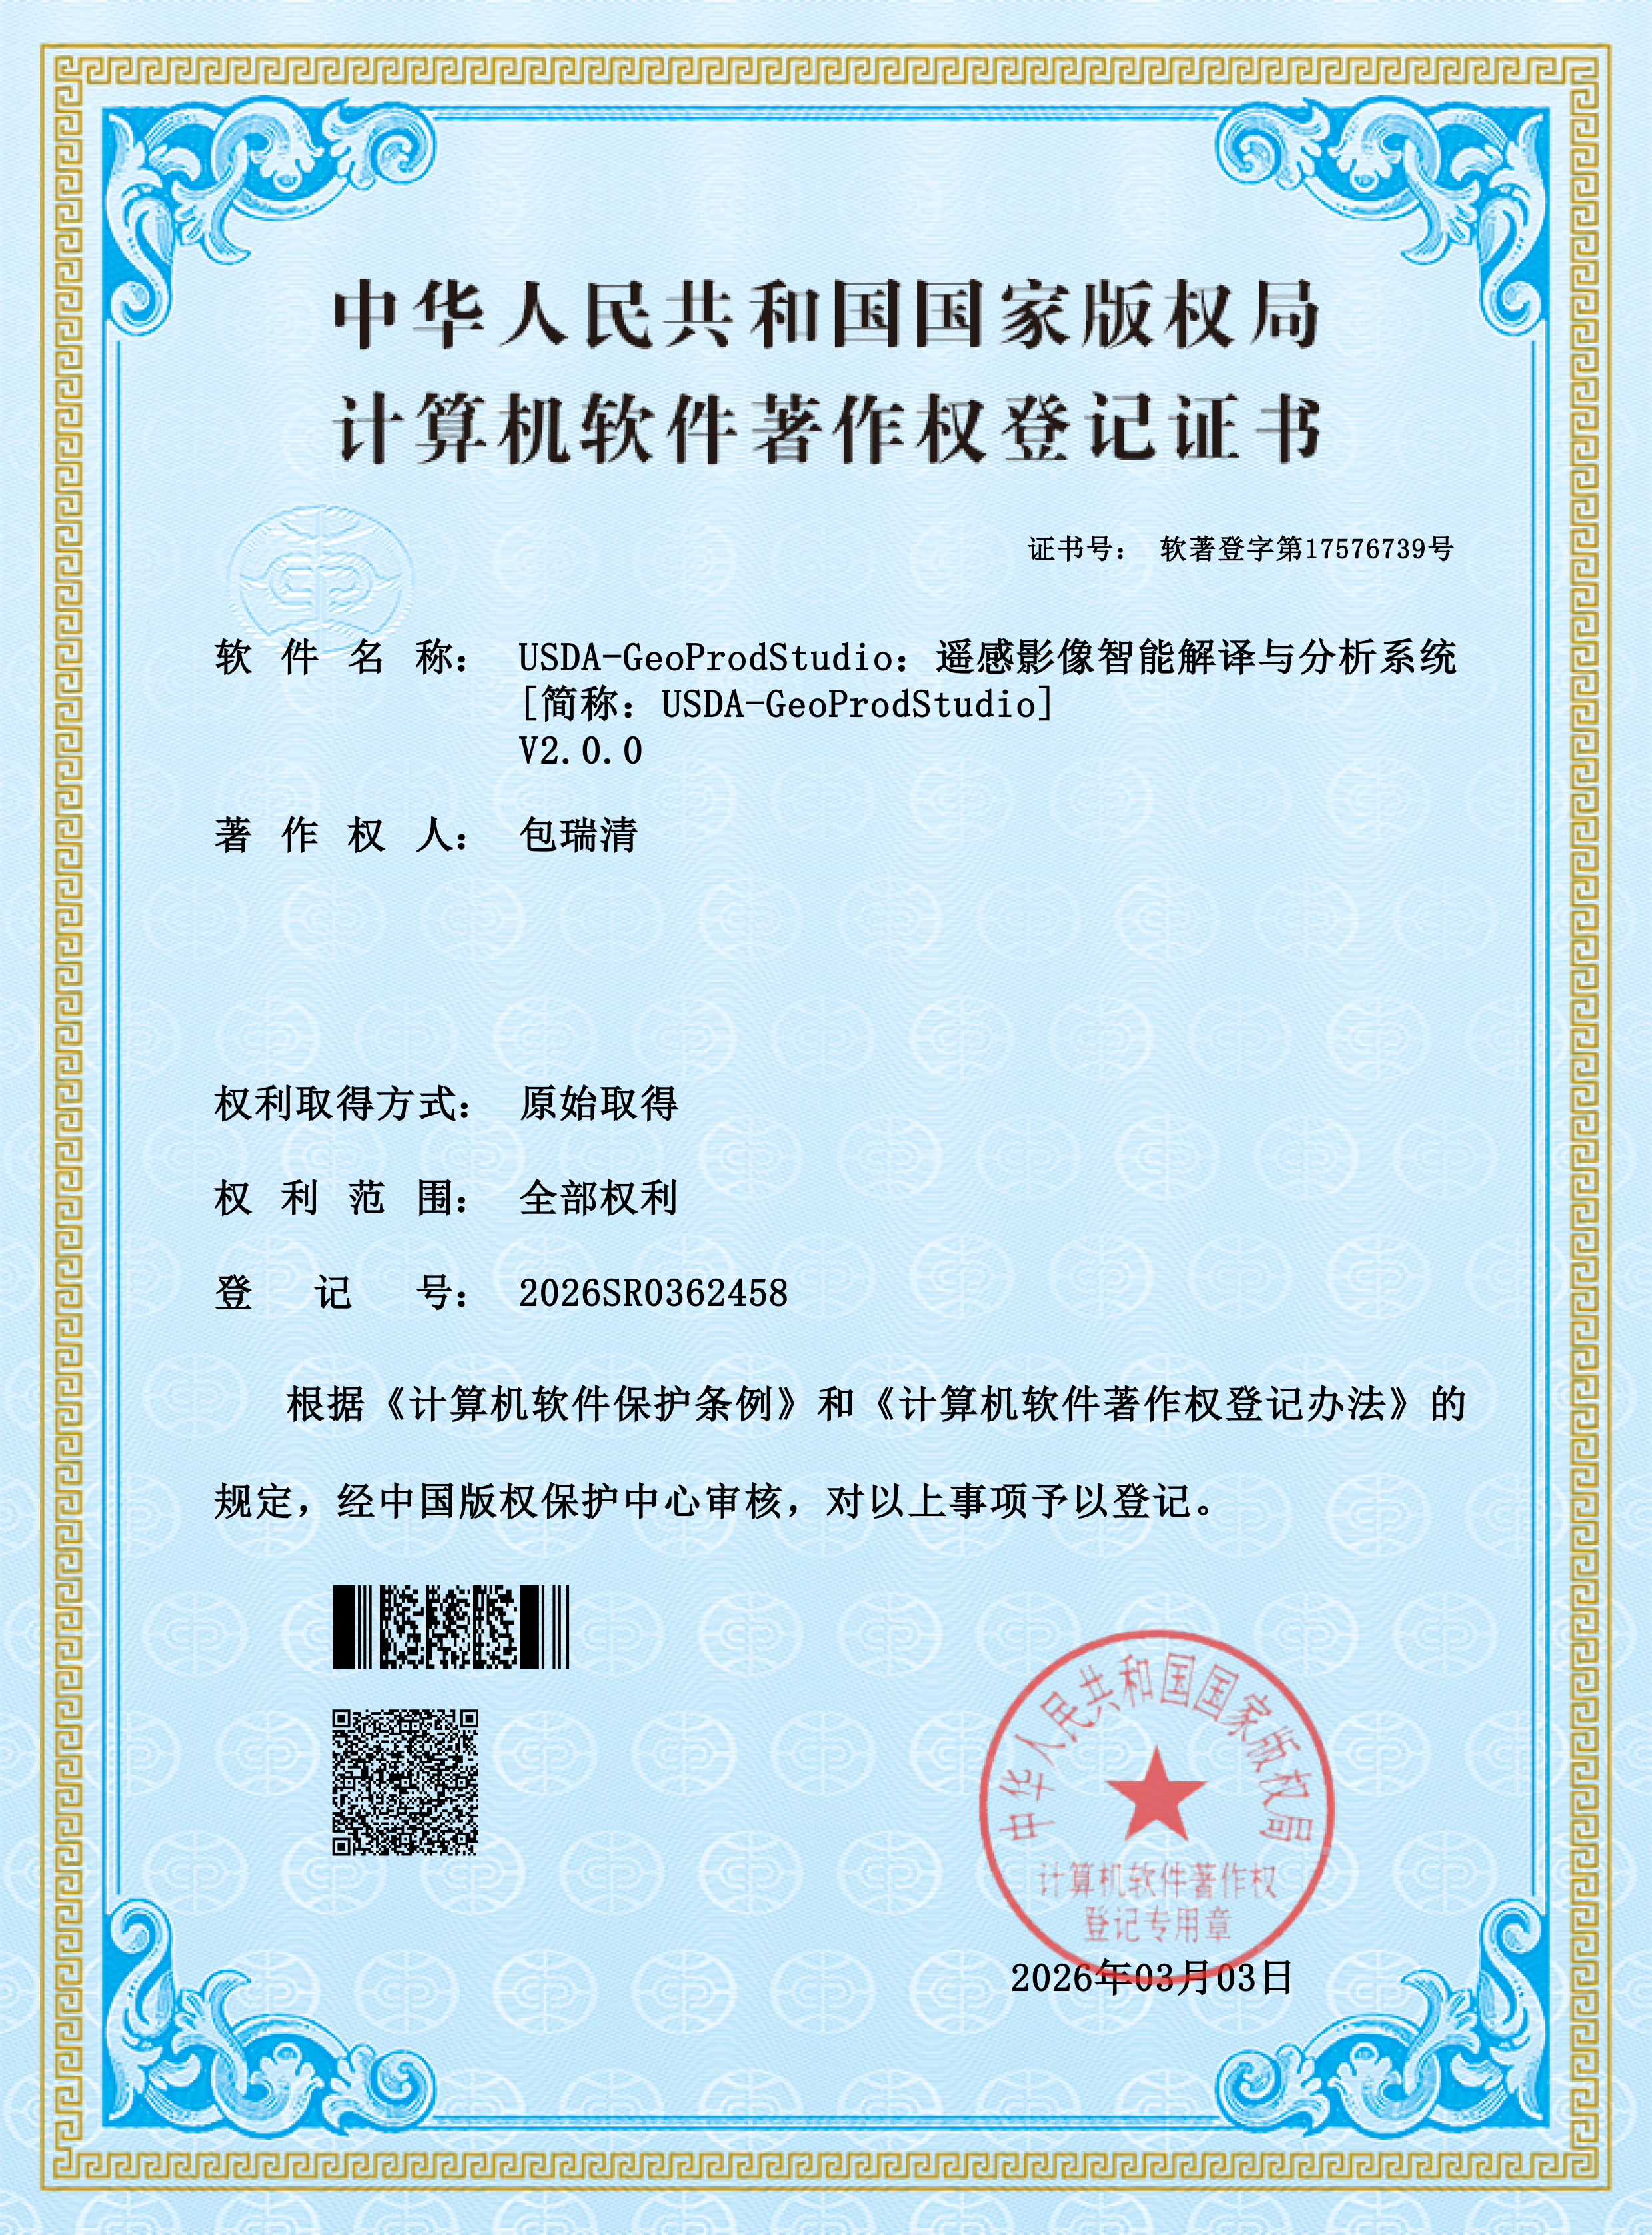
图 E-1 USDA-GeoProdStudio 计算机软件著作权登记证书(V2.0.0)
附录 F V3.5.0 修订与核验依据
本次修订保留原报告章节、字体样式、表格、原生公式及原图,更新软件版本、阶段链、特征单位、验证协议、多目标指标、贝叶斯后端与 AI 能力。正文和参数/公式附录同步修订;历史界面图不因文字修订而成为现行协议下重新计算的结果。
实现依据:spatial_structure_analysis/calculation_validation.py、numeric_backends.py、control_target_unit_scale.py、statistical_unit_scale.py、bn_backend.py、bayesian_network_analysis.py;utils 下 Harness Agent、MCP 桥接、工作目录及版本管理实现;requirements.txt;resources/markdown/usdaInfo.md;topics/topic_md/harness_agent.md 与 geoai_release_guide.md。
后续发布与科学验证应分别完成:新输入的角色、类别、单位、时相及目标方向核查;城市批次按当前协议重算或明确旧结果描述边界;空间独立样本与邻域隔离验证;BN 预测与重抽样检验;AI 多平台任务交付核验;EXE 跨机器安装、资源路径与升级回退测试;规划指标定义及方案阈值的独立验证。